Что вышло 21 октября
FastH3 Omni показали 20 октября: модель принимает текст, картинки, видео и голос, а отдаёт готовый клип с синхронизированным звуком. На восьми GB200 пятисекундный ролик в 768p из одного фото собирался за 5,7 секунды.
Двадцать первого октября команда Hao AI Lab (UC San Diego) опубликовала разбор локального запуска: те же запросы, те же референсы, тот же seed, но на одной и двух DGX Spark, на RTX 5090, на RTX 3090 и на Apple M5 Max с 64 ГБ памяти. В тот же день в репозитории FastVideo появился коммит о поддержке Apple Silicon через MLX, время 19:01 UTC.
Почему это интересно: до сих пор такие модели жили в облаке, а локальный запуск означал компромисс по качеству или по длине клипа. Здесь авторы показывают, что компромисс сместился в сторону времени и памяти.
Замеры, которые легко пересчитать в деньги
Все цифры ниже относятся к клипу длиной пять секунд: 124 кадра, 24 кадра в секунду, стерео, 832 на 480 пикселей, один референс в виде фото.
На одном DGX Spark такой запрос занимает 192 секунды, на двух Spark 130 секунд. В 768p те же запросы растягиваются до 361 и 218 секунд. Один RTX 5090 справляется за 62 секунды. RTX 3090 уходит почти на 17 минут, и это без загрузки модели, которая добавляет ещё около семи минут. Apple M5 Max показывает 19,5 минуты на одиночном прогоне.
Три фотографии в референсе меняют картину: 640 секунд на одном Spark, 390 секунд на двух. Запросы с тремя фото и с длинным клипом не влезают в профиль видеокарты на 24 или 32 ГБ, а M5 Max их тянет, но за 44-59 минут.
Референсы стоят дороже, чем кажется
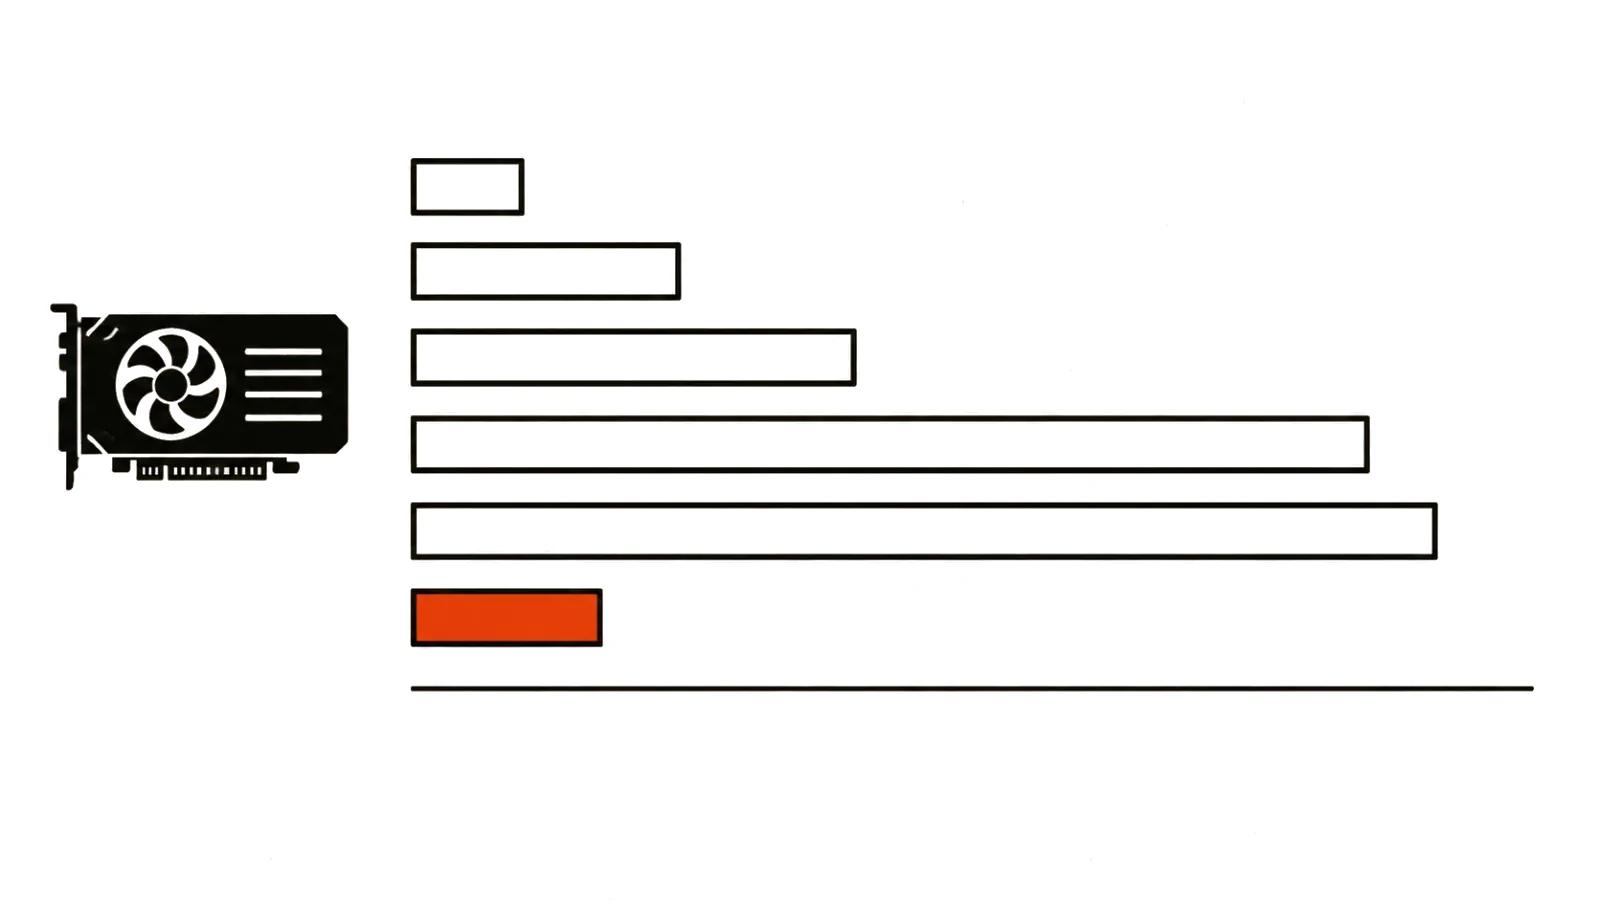
Авторы объясняют разницу в токенах. Пятисекундный клип в 480p даёт примерно 14 400 видеотокенов. Каждое референсное фото читается на холсте 2048 пикселей, на котором модель обучали, и добавляет около 7 100 токенов VAE и ещё 7 100 токенов зрения в промпт. Одно фото удваивает последовательность до 29 000 токенов, три фото дают почти 60 000.
Отсюда и разброс: запрос с фото идёт в 3,3-4,4 раза дольше, чем текстовый на той же машине. На двух Spark текстовый клип занимает 33,6 секунды, а с одним фото уже 130 секунд. На 5090 разница 14 секунд против 62.
Почему это важно: в рекламной задаче почти всегда есть референс, фото товара или кадр из прошлой съёмки. Именно он определяет, сколько будет стоить дубль.
Один флаг меняет смету в четыре раза
У FastH3 Omni есть опция --reference-max-pixels match. Она уменьшает референс до размера самого клипа, и на M5 Max запрос с одним фото падает с 19,5 минуты до 4,7 минуты, то есть в 4,2 раза.
Флаг выключен по умолчанию, и это честно: он уводит от обучающего холста и меняет кадрирование с действием. Авторы прямо пишут, что качество референса при этом страдает. Для черновых итераций это разумный компромисс, для финального кадра скорее нет.
Почему это важно: локальная нейросеть для генерации видео упирается в одну настройку, которую легко не заметить. Если считать по умолчанию, смета получается в разы выше реальной.
Как модель на 35 миллиардов влезает в настольную память
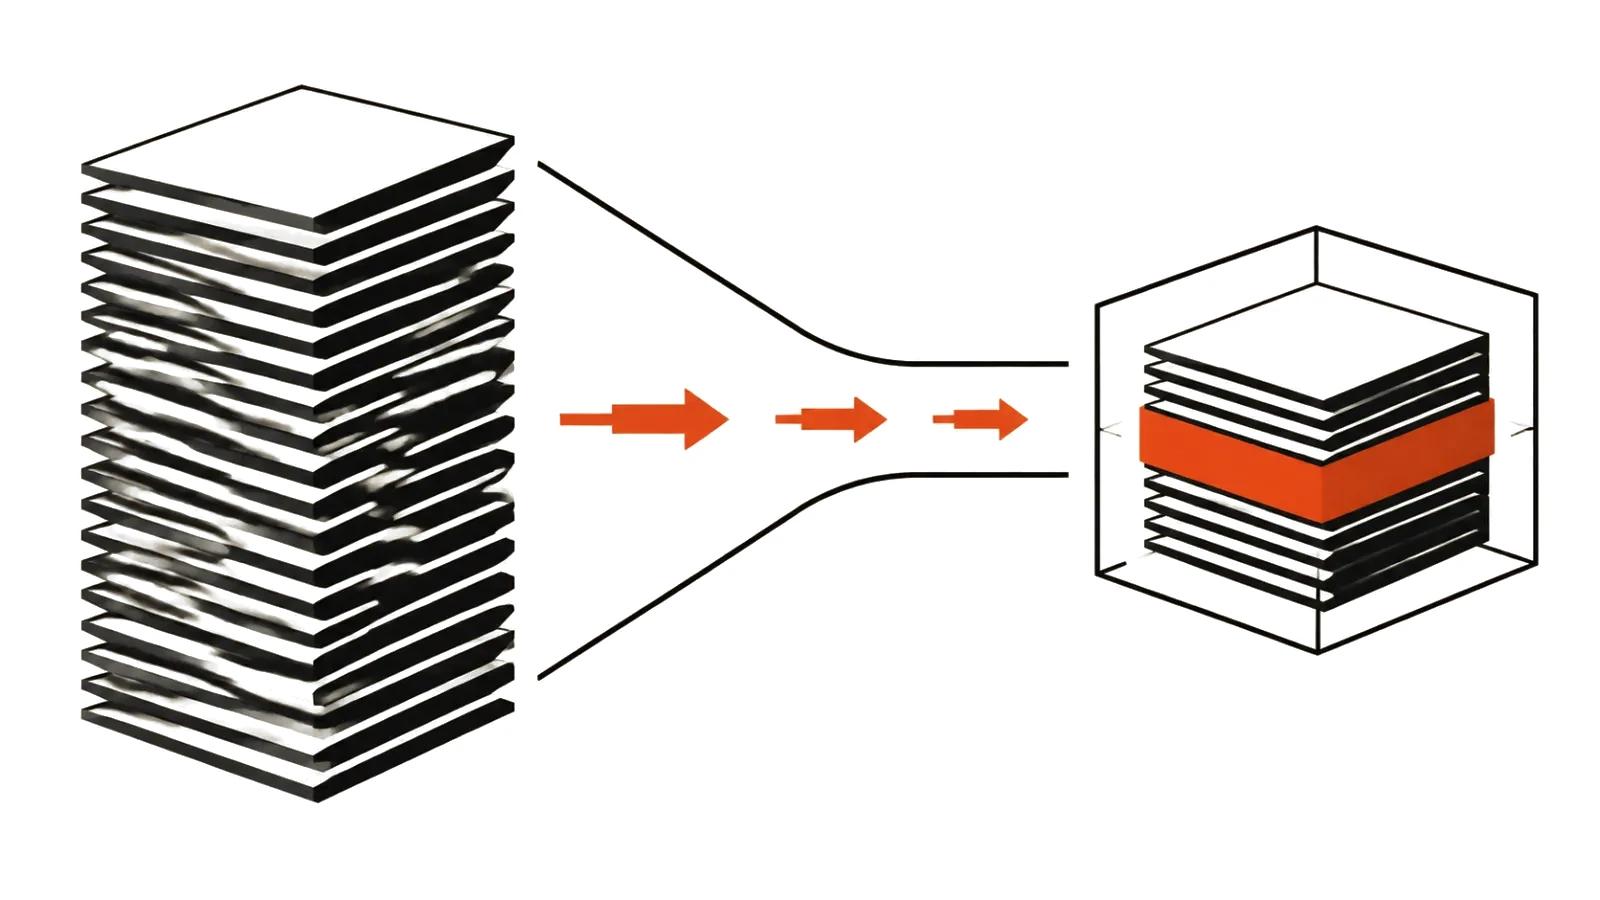
FastH3 Omni это примерно 35 миллиардов параметров в трансформере и около 32 миллиардов в текстовом энкодере Qwen3-VL, в BF16 это больше 100 ГБ. Каждая машина вмещает их по-своему.
На DGX Spark всё живёт в 128 ГБ общей памяти без перекладывания между этапами. Трансформер, энкодер и декодер держатся в NVFP4, внимание разреженное на плитках по 128 токенов, а текстовые, референсные и звуковые строки считаются плотно в 8 битах.
На RTX 5090 трюк другой: предвычисленная таблица на 155 МБ заменяет 26 ГБ весов проекций времени, и трансформер сжимается с 44,5 до 18,5 ГБ. Текстовый энкодер подгружается только на время кодирования промпта. RTX 3090 не умеет FP4 и FP8 аппаратно, поэтому работает с весами FP8 и математикой BF16, подкачивая блоки по несколько штук.
Apple Silicon: INT6, Metal и 27-31 ГБ
На Mac модель идёт через MLX. Трансформер квантуется в INT6 и занимает 17 ГБ, проекции времени предвычислены, веса NVFP4 не нужны. Референсы читает лёгкий энкодер LightVAE Lite на 406 МБ, кадры пишут те же декодеры NVFP4, что и на Blackwell. Разреженное внимание на 128-токенных плитках реализовано отдельным ядром Metal.
Пиковая память на M5 Max держится в коридоре 27-31 ГБ на всех пяти сценариях. Это означает, что ноутбук с 36 ГБ и больше формально способен на такой запуск, хотя время на один клип измеряется десятками минут.
Что это меняет для заказчика
Первое: появилась возможность считать смету без облачных тарифов. Изготовление видео с помощью нейросетей теперь можно оценивать в машинном времени, без кредитов сервиса, и это меняет экономику повторных дублей.
Второе: референс перестал быть бесплатным приложением к промпту. Если в проекте пять товаров, каждое фото это плюс 7 100 токенов и примерно удвоение времени. Для пачки однотипных роликов выгоднее один раз проверить кадр и дальше держать настройки, чем гонять полный холст на каждом.
Третье: автоматизированный YouTube-канал на локальном железе становится реальным, но с оговоркой. Клип на пять секунд это ещё не выпуск. Выпуск собирается из десятка клипов, и на 3090 склейка займёт часы. Ручные ролики с актёром и монтажом такой конвейер пока не заменяет, зато обзор нейросетей для видео теперь можно делать на одном железе, быстро проверяя десяток моделей.