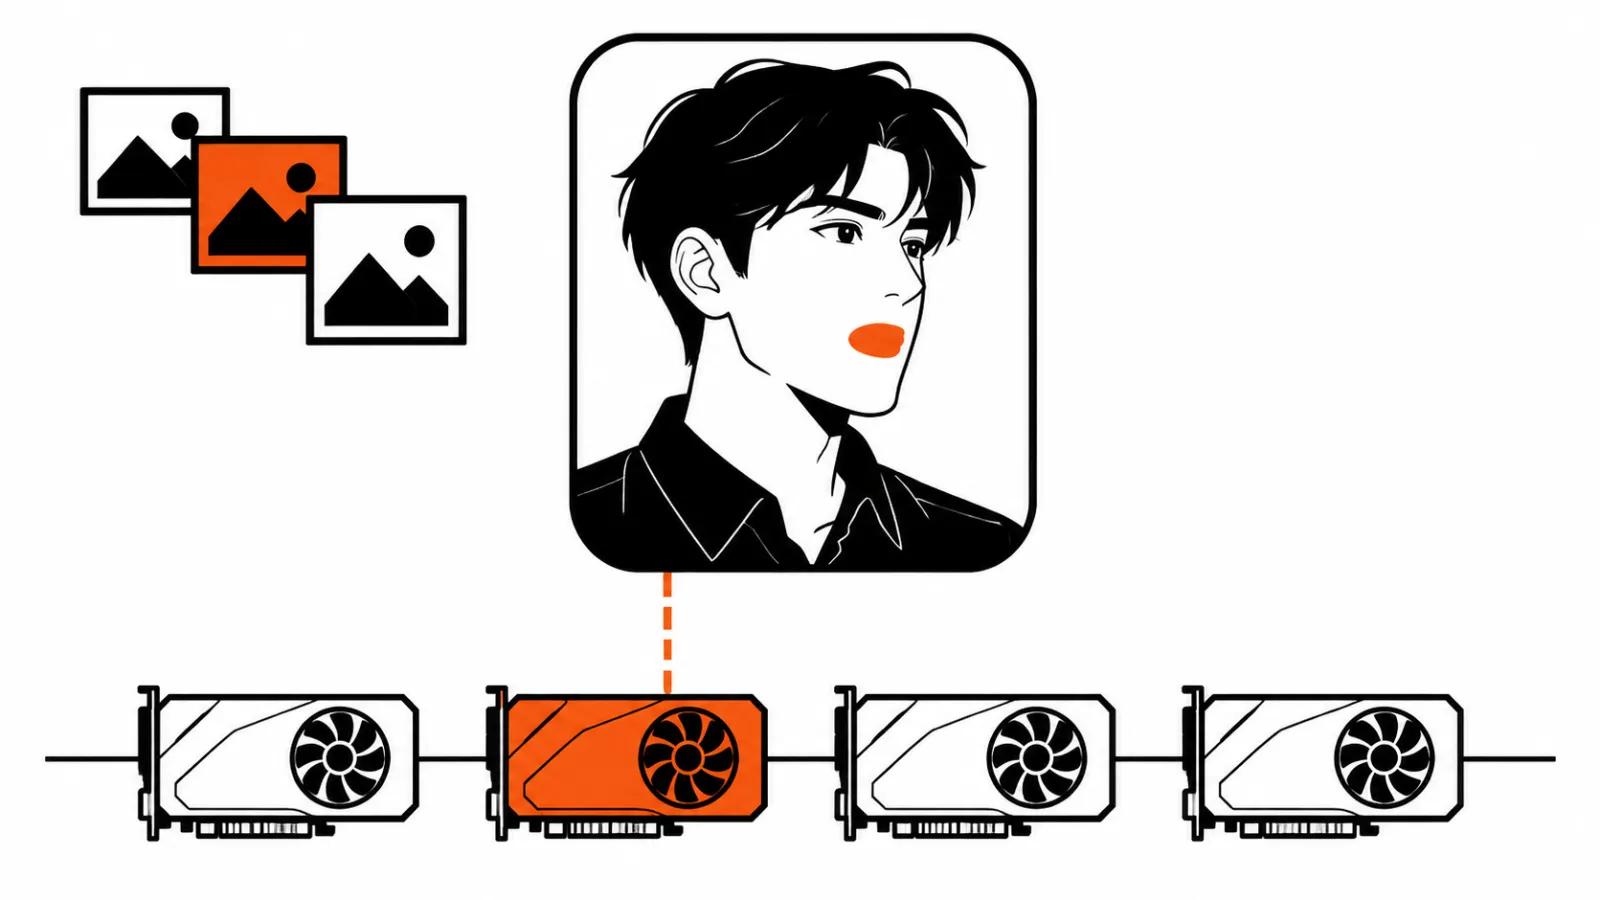
Что Runway Characters делает с одним фото
Characters это продукт, где из одного фото получается живой собеседник. На той стороне сидит авторегрессионная видеомодель примерно на 57 миллиардов параметров, по архитектуре видео DiT. Каждый чанк она собирает в четыре denoising-прохода и выдаёт кадр 704×1088 при 24 fps.
Ритм задаётся арифметикой. Четыре кадра каждые 166,7 мс. Это обязательство на каждый шаг, не средний темп за минуту. Одна сессия на одного человека: batch size one. Здесь и находится главный поворот поста.
Почему batch size one ломает привычную логику GPU
Обычный инференс живёт по правилу «набить батч и размазать стоимость по всем». Пятьдесят запросов разом стоят дешевле, чем пятьдесят по одному, и на этом построены все расчёты себестоимости.
С диалоговым аватаром так не выйдет. В пост-разборе сказано прямо: загрузка на одну сессию держит 2,24 PFLOP/s полезной работы, и подсаживать второго пользователя в тот же такт нельзя. Каждый платит за свою карту целиком. Нейросеть реального времени для видео считает железо на одного человека, и старая логика батча тут не работает.
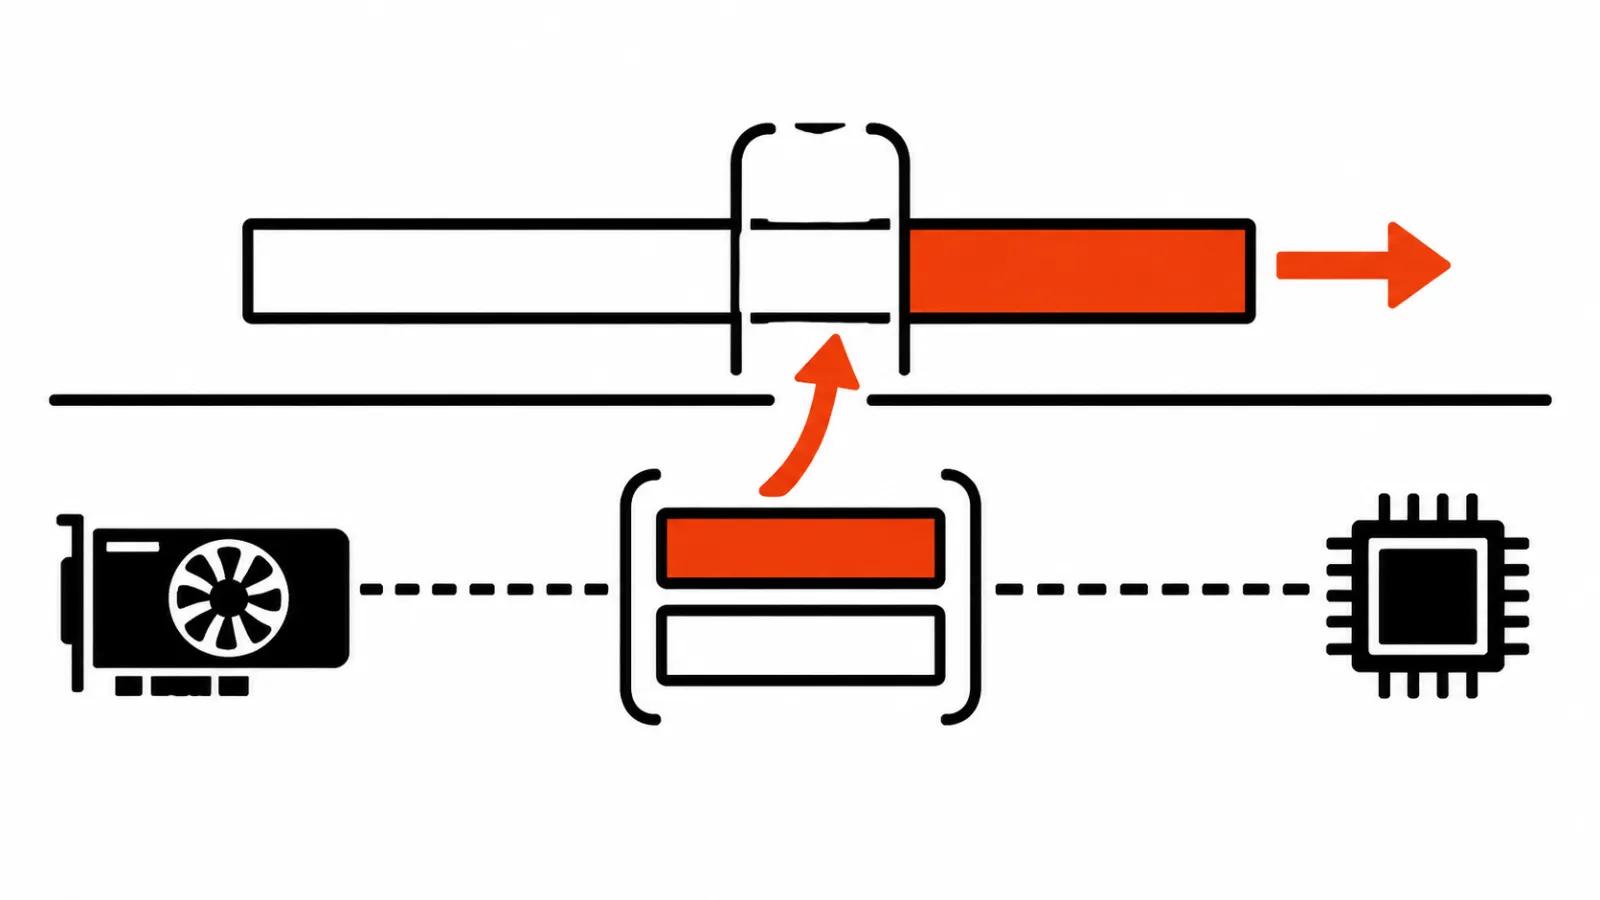
Бюджет времени: 240,9 мс против 166,7 мс
На восьми H100 сессия стартовала, и это была точка отсчёта. Простой расчёт показывает, что даёт переезд на четыре карты: базовый шаг в такой раскладке занимал 240,9 мс, а в бюджет нужно уложить 166,7 мс. Разница больше семидесяти миллисекунд, и в реальном времени она видна как задержка.
Сначала идут настройки продакшна: 159,3 мс, это 24,5 fps, ускорение в 1,51 раза. Затем fused-ядро, где all-reduce зашит внутрь FP8-умножения, и там 147,4 мс, то есть 1,63 раза от базы.
Кэш: 240 attention calls и работа на запись
Второй источник экономии оказался в том, как модель читает собственную память. На каждый чанк приходится 240 attention calls, и каждое обращение читает KV-кэш на 5788 слотов, из которых новых всего 757. В базовом шаге 29% времени GPU уходило на пересчёт почти неизменного кэша, а сами attention занимают около 6%.
Работу перенесли на момент записи: кольцевой кэш, RoPE и квантование в FP8 применяются один раз при записи, а при сбросе позиций считают дельта-поворот. Upkeep упал с 69,7 до 6,2 мс на шаг. Позиции сбрасываются каждые 42 шага.
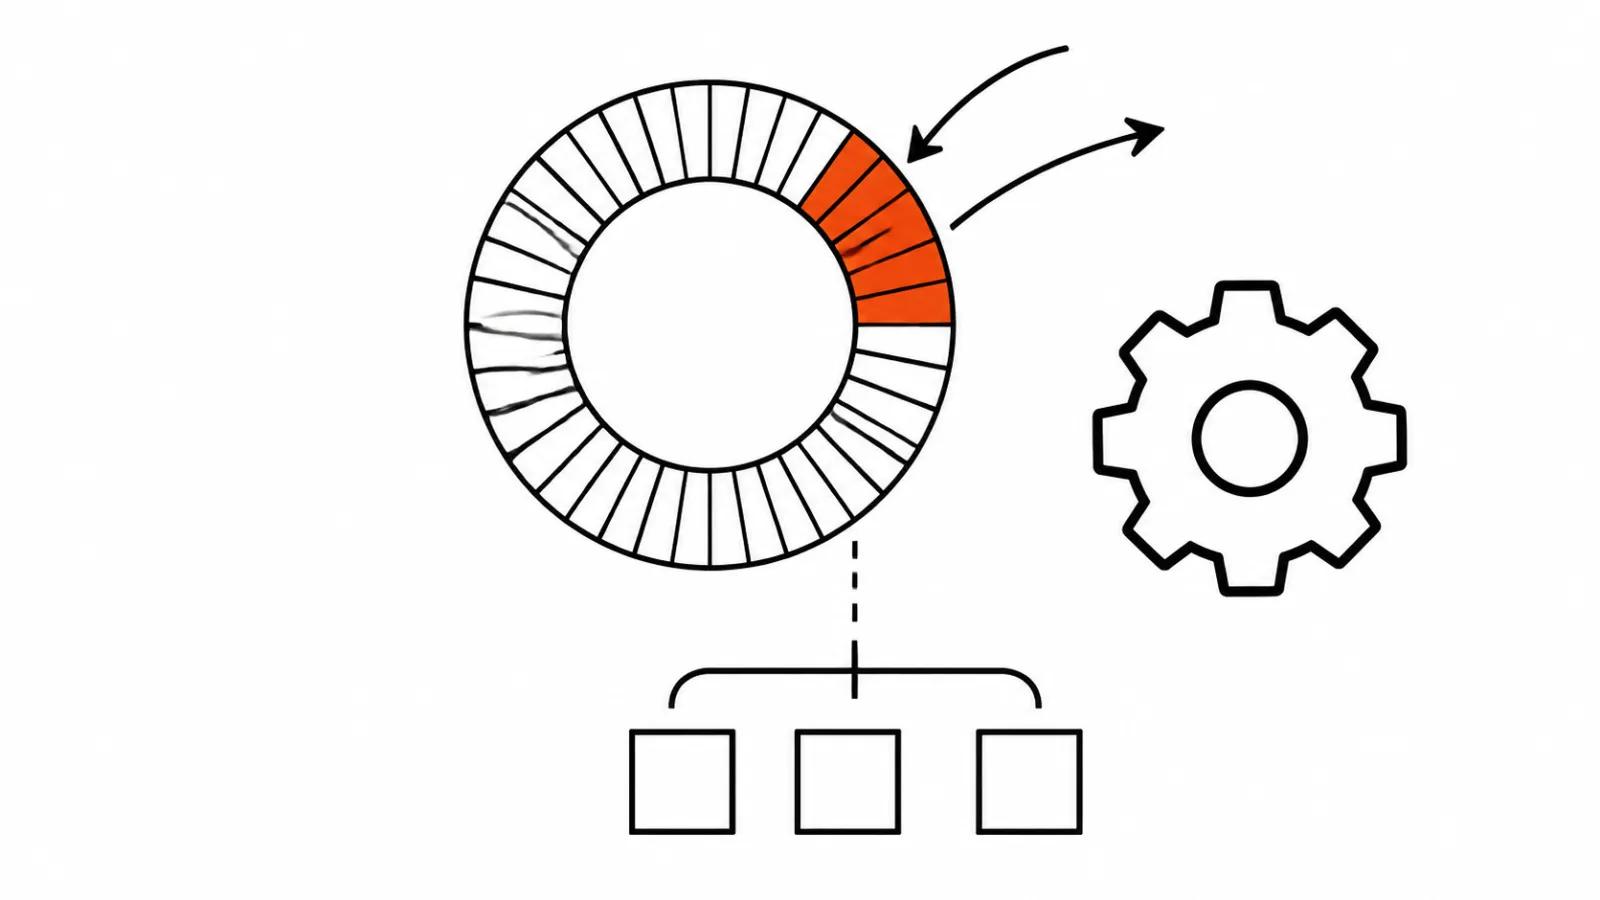
Декодер на отдельной карте
Третье решение про железо. Декодер, который превращает латентные представления в готовые кадры, занял свой GPU и работает параллельно с denoising. Он забирает 114 мс, но укладывается в то же окно, где считается диффузия. На общей B200 с power cap такая схема тормозит diffusion на 18-26%.
Что показал launch: fused-ядро, OOM и откат
Fused-ядро собрали в августе 2026 года, и оно сразу попало в продакшн. После обновления PyTorch и NCCL посыпались ошибки памяти: OOM в рабочей нагрузке. Команда откатилась, разобралась и включила ядро заново 8 октября. За пятнадцать дней после этого доля сессий, где кадры проседали до 24 fps и ниже, составила 0,7% против 7-23% до фикса.
Как проверяли качество
Мерить авторегрессионную модель в пикселях бессмысленно: PSNR здесь не работает, потому что сравнить не с чем. База сравнения другая, прогон против прогона. На 51 размеченном клипе средняя разница по lip-sync не превысила 0,03, и это лежит в пределах собственного разброса модели между одинаковыми запусками. Четыре десятиминутные сессии дали тот же порядок цифр.
Задержку мерили на живом разговоре. Медиана от конца фразы пользователя до реакции аватара составила 2,13 с. Внутри этого времени голосовой агент забирает 1,42 с, видеопайплайн 0,49 с, доставка около 190 мс.
Blackwell: три B200 вместо четырёх H100
Числа по свежему поколению тоже есть. Три B200 дают около 154,3 мс. Восемь H100 считают диффузию за 118,2 мс, но упираются в декодер, и итог выходит 128,7 мс, то есть 31 fps. Запас производительности у железа есть, только расходуется он на декодер и мелкие шаги.
Аватар из одного фото: что это меняет в смете
Мой вывод простой, и он про второй эшелон поста. В самом разборе нет цен, это инженерный отчёт про serving, и я не стану приписывать Characters прайс, которого там нет.
Смотреть стоит на другое: сессия реального времени теперь считается в четырёх картах вместо восьми. Для студии, которая считает себестоимость live-аватара, это прямое сокращение знаменателя. Это важнее для тех, кто проектирует диалоговые сценарии и прикидывает стоимость GPU-часа, и почти неинтересно тем, кто собирает 15-секундные рекламные клипы офлайн. Там платят за секунду рендера. Удержание темпа оплачивается отдельно.
Про Kling 4.0 Flash, Gemini Omni и Muse рассказал вчерашний выпуск, и разница между тремя «реальными времени» наконец читается: у одной это serving на batch one, у другой длина клипа, у третьей разговорная игрушка.
Для практической работы ориентир остаётся прежним. Диалоговые ролики и сцены с говорящим человеком мы собираем на пайплайне с человеком за кадром, ручные ролики идут от 16 000 ₽, и там предсказуемо всё, кроме бюджета GPU-часа. Серии сцен, где видео нейросетями работает партиями, живут на другом расчёте, до 0,10 ₽ за просмотр. Когда нужен именно разговор с персонажем без съёмки, рядом лежит разбор говорящего аватара в реальном времени. Железо под ним дешевеет, значит предел по длине сессии скоро перестанет быть техническим.