Что модель действительно видит
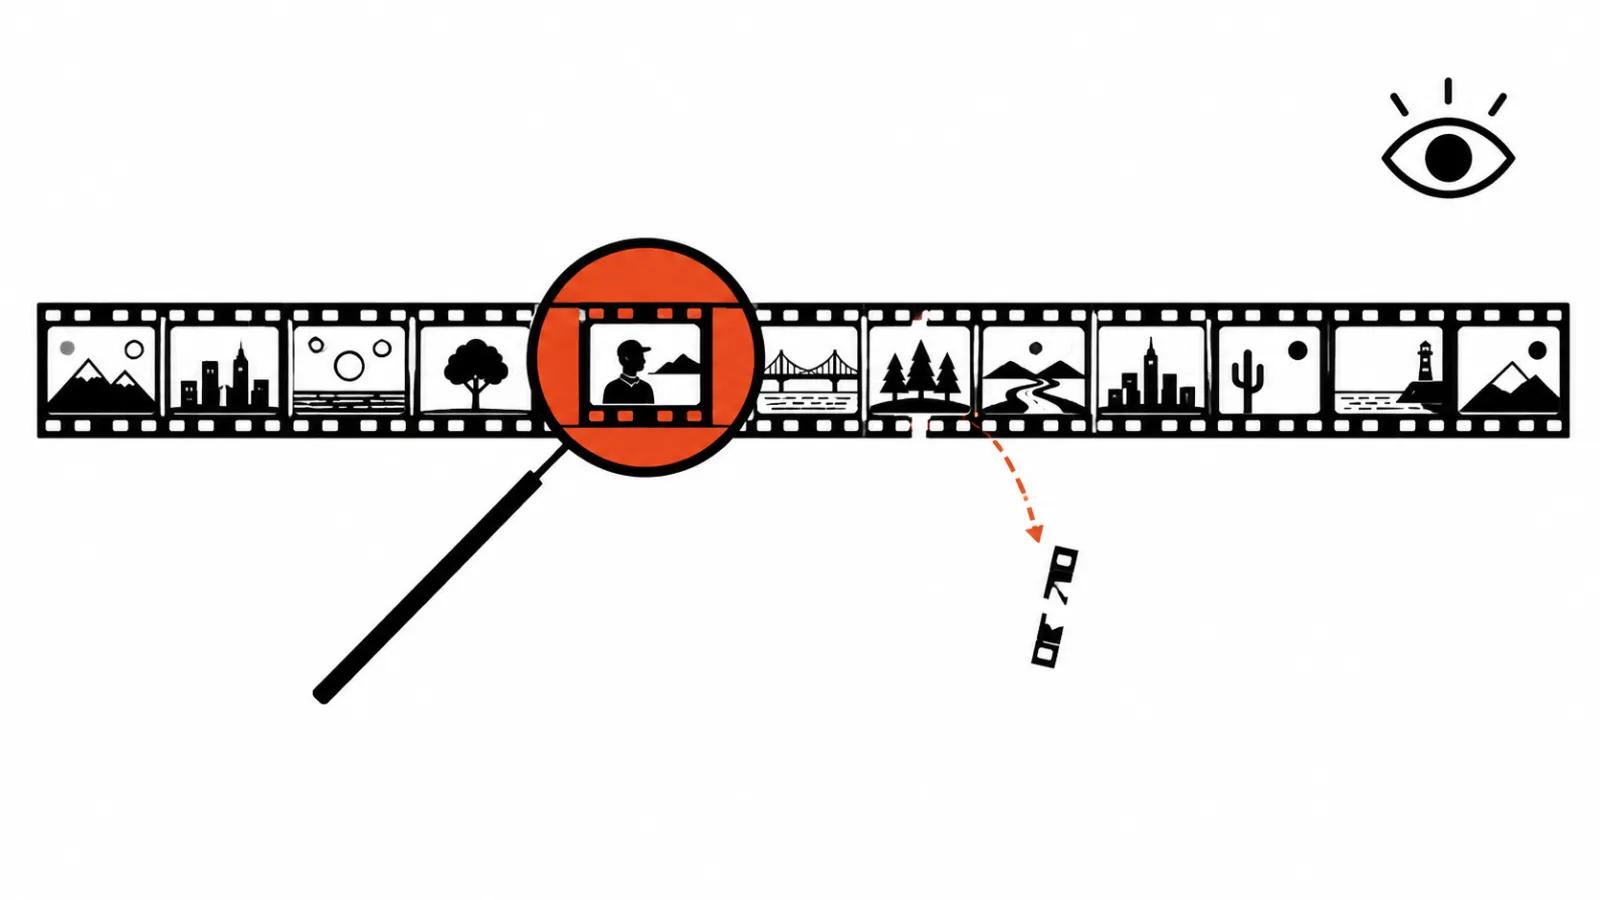
На вход модель получает файл или ссылку на YouTube. Дальше она смотрит кадры и, если модель поддерживает звук, слушает дорожку.
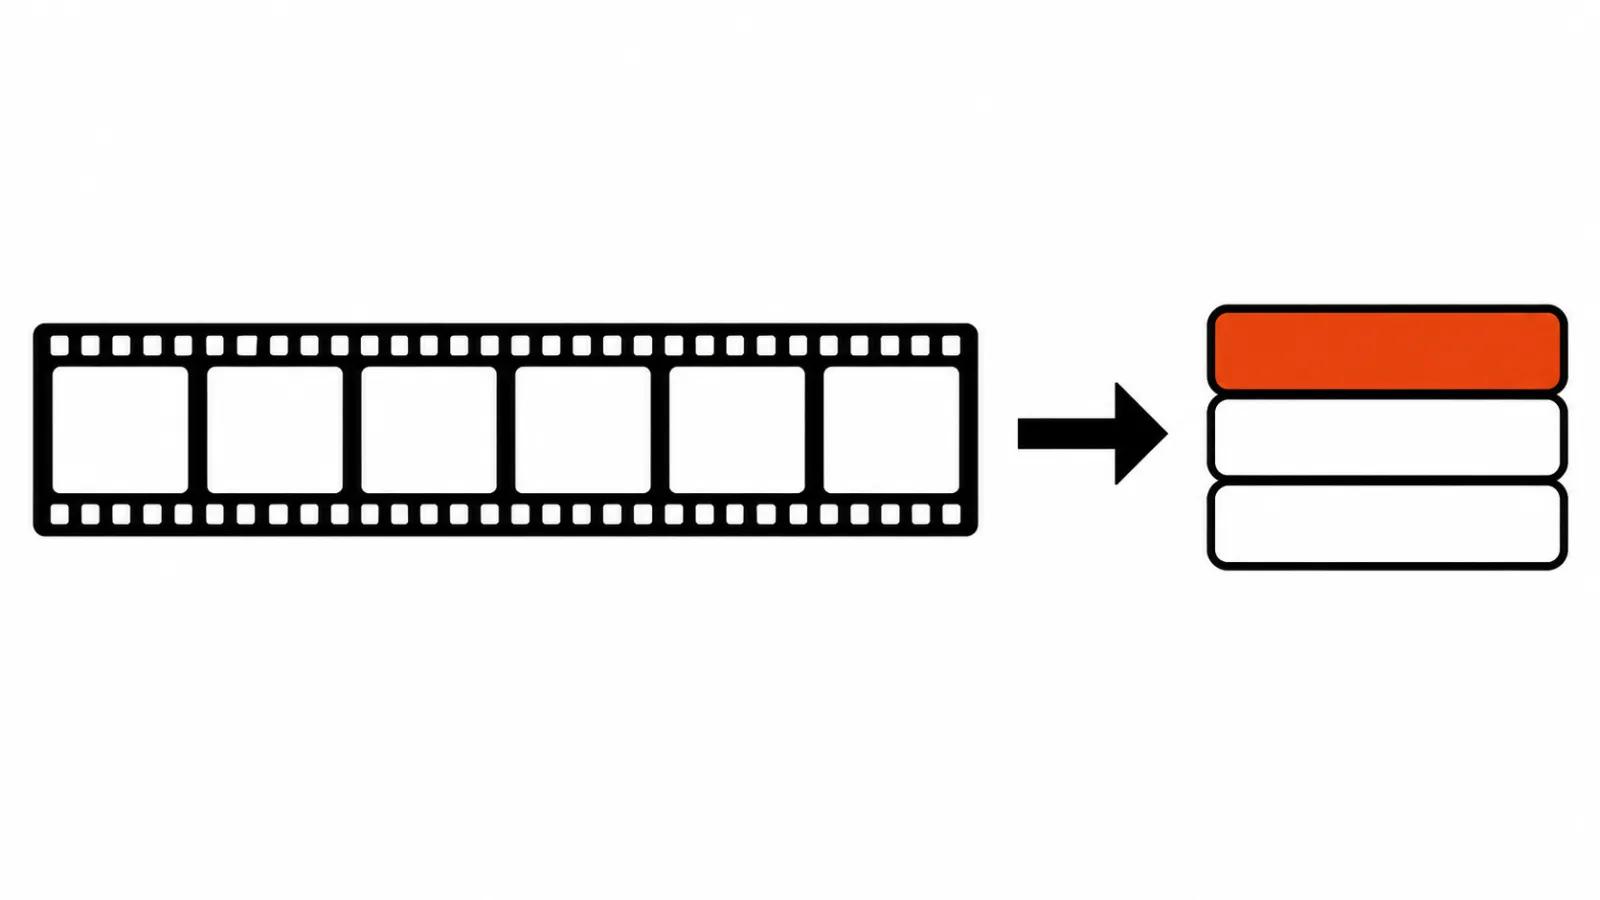
Кадры берутся не все. По умолчанию частота выборки один кадр в секунду, и это число можно менять в настройках запроса. При стандартном разрешении один кадр стоит около семидесяти токенов.
Отсюда первый практический вывод. Между двумя соседними кадрами помещается почти секунда, и всё, что короче, попадает в выборку случайно.
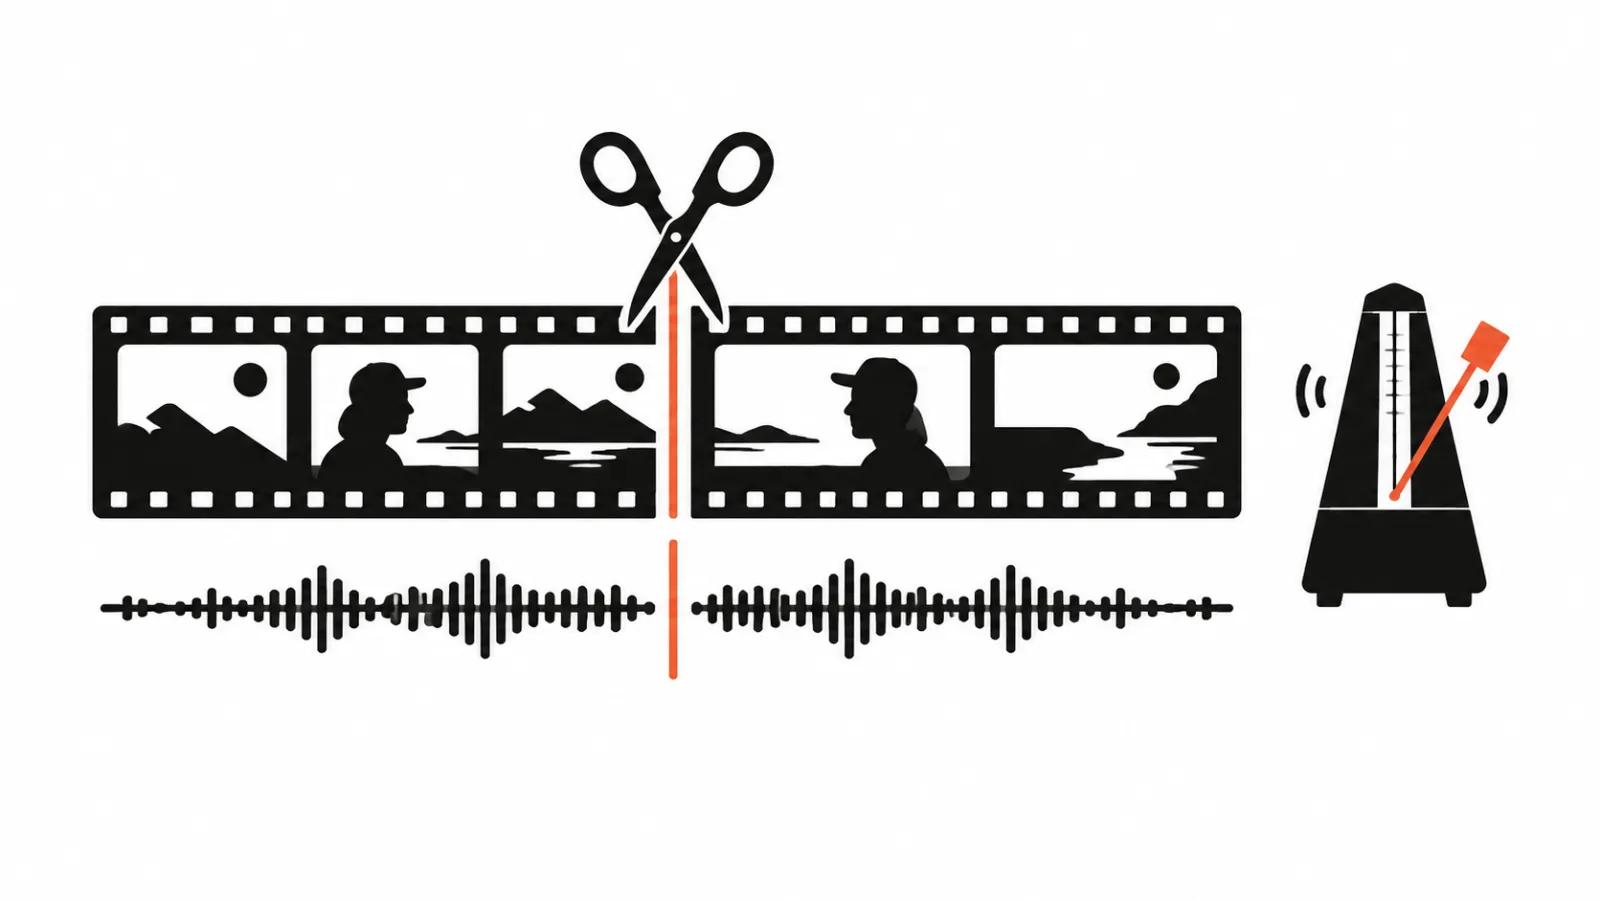
Монтажная склейка длиной в четверть секунды может исчезнуть целиком. Модель расскажет связную историю про сцену, которой в исходнике не было.
Нейросеть для анализа видео: три задачи, где она экономит день
Первая задача: найти сцену в длинной записи. Интервью на сорок минут, нужен фрагмент про цену. Раньше это перемотка с блокнотом, теперь вопрос словами и таймкод в ответе.
Вторая: разобрать чужой ролик. Что показывает конкурент в первые три секунды, сколько у него планов, есть ли человек в кадре, чем заканчивается видео. Модель отвечает быстрее, чем я успеваю досмотреть. Тем, кто делает видео нейросетями пачками, так дешевле отсмотреть десяток версий.
Третья: проверить рекламный ролик до запуска. Совпадает ли текст на экране с озвучкой, не мелькает ли логотип, укладывается ли сообщение в первые секунды, нет ли в кадре лишнего человека или чужого бренда.
| Задача | Что спросить у модели | Что проверить руками |
|---|---|---|
| Поиск сцены | В какую минуту говорят о цене и что звучит вокруг | Точность склейки и паузы |
| Разбор чужого ролика | Сколько планов, что в первом кадре, чем финал | Монтажный ритм и цвет |
| Проверка рекламы | Совпадают ли титры и речь, есть ли логотип | Читаемость на телефоне |
ИИ для анализа видео: сколько ролика влезает в запрос
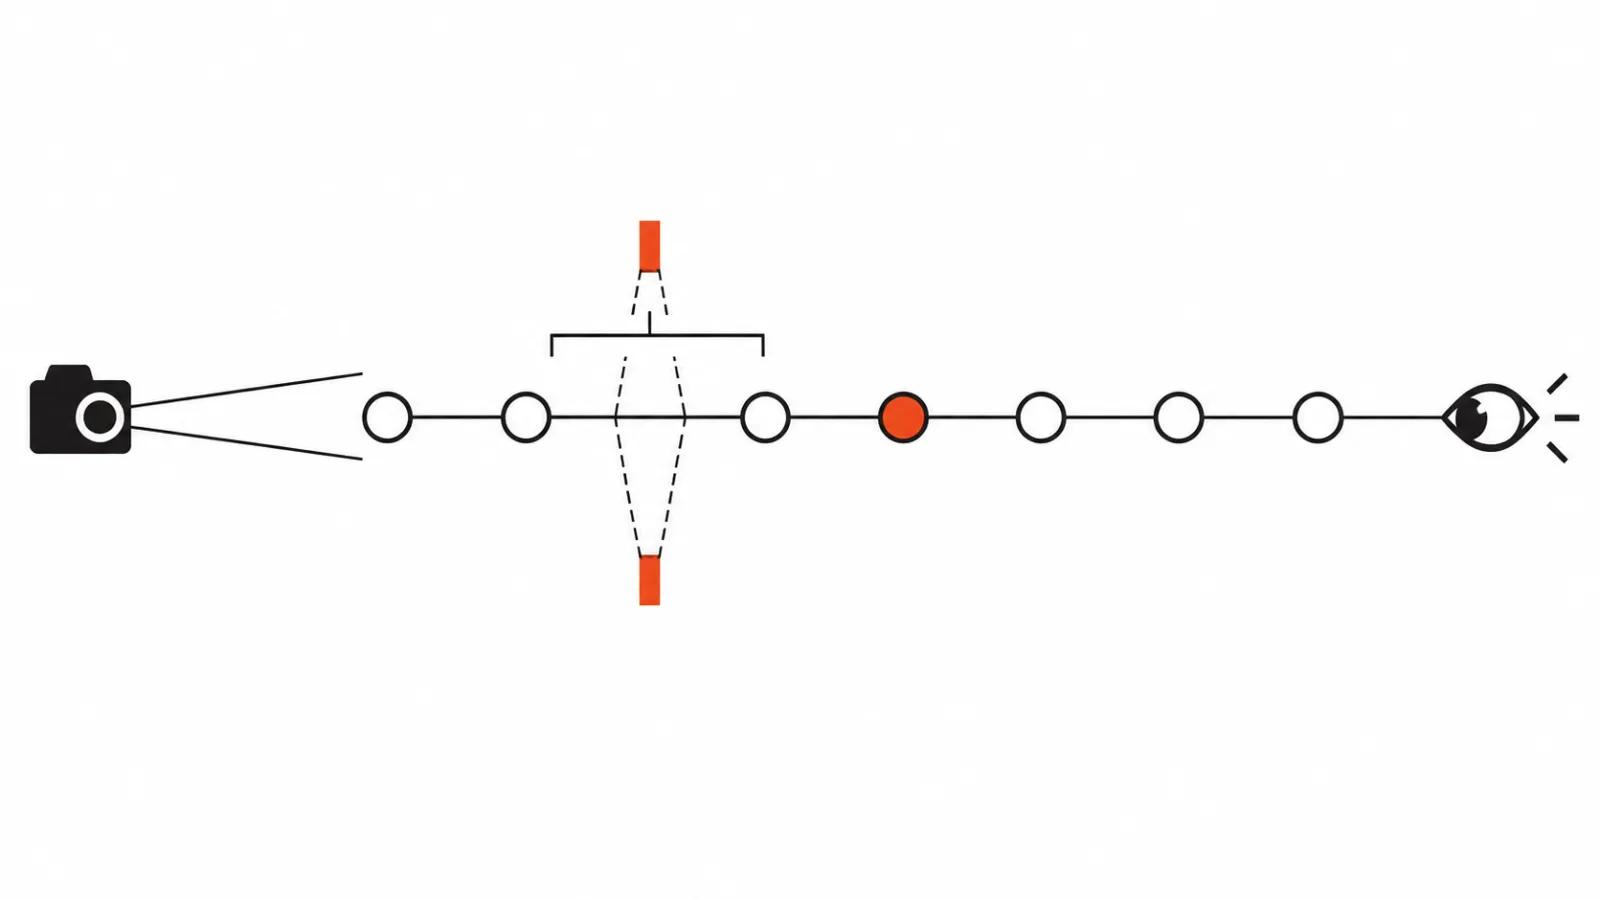
У основной линейки моделей лимит около сорока пяти минут для видео со звуком и около часа для немого файла. В одном запросе можно отправить до десяти роликов.
Для подкаста на два часа это значит нарезку на части и отдельные запросы по каждой. Ведение YouTube-канала с интервью на час и больше упирается в тот же лимит. Ссылка на YouTube экономит загрузку, и модель сама возьмёт дорожку оттуда.
Клип можно обрезать прямо в запросе: указать начало и конец фрагмента. Это дешевле, чем гонять полный файл, если нужен один эпизод.
Таймкоды и точность
Модель умеет возвращать ответ с метками времени, если попросить формат явно. Без просьбы она часто пишет «в начале», «ближе к концу», и искать потом приходится вручную.
Формулировка работает такая: укажи таймкод в формате минуты и секунды для каждого фрагмента, где звучит эта мысль.
Точность метки стоит проверять. На часовом материале промах в десять секунд это норма, и для монтажа его хватает, чтобы попасть в соседнюю фразу.
Для мелких деталей есть отдельный приём: попросить модель приблизиться к конкретному таймкоду. Так читают текст на экране, табло, мелкие подписи в презентации.
Распознавание ИИ видео не равно пониманию
Распознавание отвечает на вопрос «что сказано». Понимание отвечает на вопрос «что это значит для задачи». Это разные вещи, и вторая даётся модели хуже.
Она уверенно перескажет диалог и не заметит, что герой всё это время смотрит в другую сторону от собеседника. Или что на фоне играет чужая песня.
Звук обрабатывается не во всех моделях одинаково. Если дорожка не входит в контекст, запрос про интонацию и паузы вернёт выдумку.
Ещё одна граница: модель не знает, как ролик смотрится в ленте. Досмотры, удержание, реакция аудитории остаются за пределами запроса.
Где анализ врёт
Первое место: быстрый монтаж. Один кадр в секунду не ловит вставки и моргания, поэтому «в кадре один человек» может оказаться ошибкой.
Второе: текст на экране. Мелкий шрифт, субтитры, плашки с ценой читаются через приближение, и без него модель придумает надпись по смыслу.
Третье: количество. «Сколько раз показан продукт» модель считает приблизительно, и на цифру лучше не опираться в отчёте.
Четвёртое: юридические детали. Модель назовёт логотип, но не скажет, есть ли права на музыку и согласие человека на съёмку.
Как ставить задачу
Запрос лучше собирать из трёх частей: что смотреть, что именно искать, в каком виде вернуть ответ.
Пример: «Это рекламный ролик на тридцать секунд. Перечисли по порядку все планы с таймкодами. Отдельно отметь кадры, где виден логотип, и кадры с людьми. Ответ дай списком, без вступлений».
Просьба «оцени качество» даёт общие слова. Просьба «найди расхождение между титрами и озвучкой» даёт проверяемый список.
Если роликов много, один запрос на десять файлов работает хуже, чем десять отдельных: модель начинает путать, к какому файлу относится наблюдение.
Что проверить руками перед решением
Выводы модели стоит воспринимать как черновик разбора. Таймкоды сверить на таймлайне, цитаты прочитать в исходнике, цифры пересчитать.
Для рекламы я оставляю два обязательных прохода глазами: первый кадр на телефоне и звук в наушниках. Модель не слышит, как шум комнаты перекрывает голос.
Ручные ролики я проверяю по-другому: там важна мимика, и её видно только в полном кадре без выборки. Модель тут помогает отобрать дубли, решение принимает человек.
И ещё: перед отправкой файла проверьте, нет ли в нём чужих прав и личных данных. Загрузка чужого ролика в сервис это отдельное решение, и модель тут ни при чём.
Анализ видео нейросетью экономит вечер на разборе и не отменяет финального просмотра. Такой порядок меня устраивает: рутина уходит в запрос, решение остаётся за человеком.