Что просят, когда ищут ИИ видео из видео
По нашему семантическому ядру у фразы «ии видео из видео» 1130 точных запросов в месяц. Рядом «ии для создания видео из видео» с 653, «создать видео из видео нейросеть» с 345, «ии генератор видео из видео» с 340 и «нейросеть для генерации видео из видео» с 282. Частоты высокие, и за ними стоят разные задачи: кто-то хочет перерисовать клип в мультяшном стиле, кто-то поменять фон, кто-то оживить фотографию.
Общее у них одно. На входе есть изображение или ролик, на выходе нужен новый материал с сохранённым движением. Это и есть video-to-video.
Чем переделка отличается от апскейла
Два запроса часто путают. Апскейл берёт то же видео и делает его резче, убирает шум и артефакты сжатия. Переделка берёт видео и рисует его заново по новому описанию. Апскейл сохраняет всё, включая ошибки, переделка меняет содержание кадра.
Если задача в резкости и чистоте, смотрите разбор про улучшение качества видео нейросетью. Если задача в другом стиле или других объектах, дальше про переделку.
Три режима: стиль, замена элементов, анимация персонажа
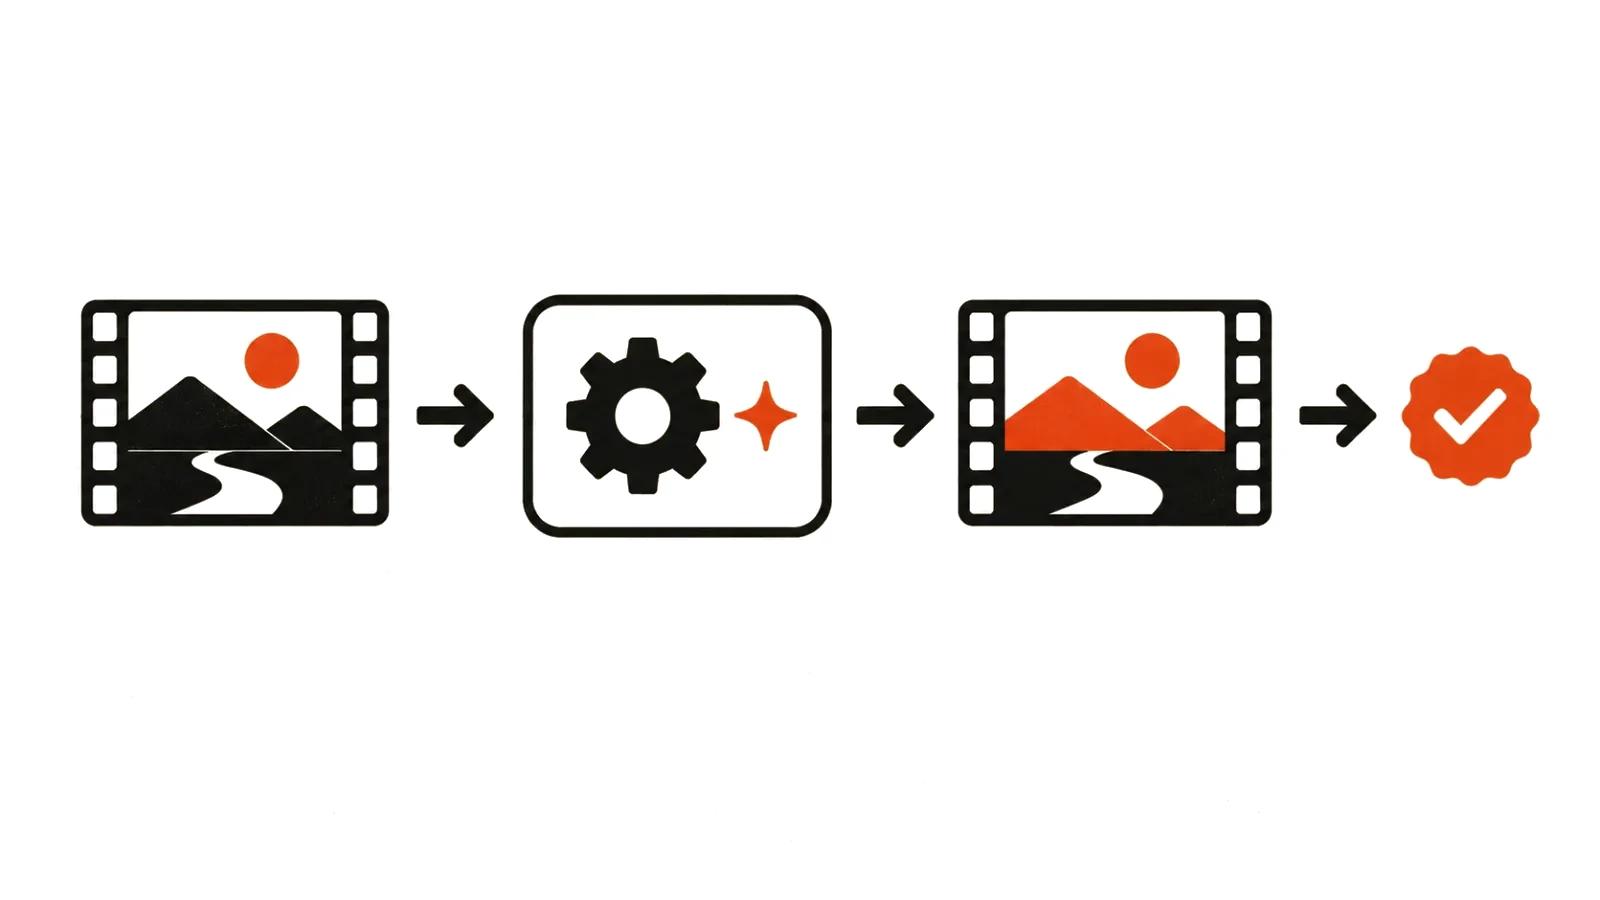
Первый режим это перенос стиля. Модель получает исходный ролик и текстовое описание, после чего перерисовывает кадры, сохраняя траекторию движения. У Kling модели 3.0 и O1 принимают видео на вход и поддерживают работу с элементами сцены (карта возможностей (https://kling.ai/document-api/guides/capability-map/video)). В документации fal тот же режим описан как правка существующего видео по инструкции с сохранением исходной структуры движения (fal Kling O1 (https://fal.ai/docs/model-api-reference/video-generation-api/kling-o1-edit-video)).
Второй режим это замена и удаление элементов. Runway в модели Aleph 2.0 обещает локальные правки: меняется только то, что вы просили, остальное остаётся как было, а опорой служит отредактированный кадр (анонс Aleph 2.0 (https://runway.com/news/introducing-aleph-2-and-edit-studio)).
Третий режим это анимация персонажа по управляющему видео. Здесь на вход идут фото персонажа и ролик с движением, а выход это тот же персонаж, повторяющий мимику и жесты. Открытая модель Wan-Animate-2 весом 14B вышла в августе 2026 под лицензией Apache 2.0, работает с разрешением до 720p и в базовой конфигурации рассчитана на восемь ускорителей A800 (карточка модели (https://huggingface.co/Wan-AI/Wan2.2-Animate-2-14B)).
Три режима стоят по-разному и требуют разной подготовки. Стиль требует описания, замена элементов требует маски или текстовой инструкции, анимация требует управляющего видео приличного качества.
Рабочий процесс: пять шагов
Порядок, который экономит генерации.
- Отрезать короткий фрагмент. Пять до десяти секунд с одним действием. Чем короче, тем меньше шансов, что модель поплывёт.
- Выбрать один тест. Первый прогон делают на низком разрешении и на одной сцене, чтобы понять, как модель читает описание.
- Зафиксировать движение. Камера в исходнике должна двигаться плавно. Резкий рывок или сильный зум модель повторит с артефактами.
- Менять по одному признаку. Стиль, потом свет, потом детали фона. Три изменения в одном запросе дают неуправляемый результат.
- Принимать в движении. Смотреть ролик целиком. На паузе дрожание не видно, на воспроизведении глаз его ловит.
Где модель ломает кадр
Лица. На крупном плане мимика теряет мелкие движения, глаза перестают согласовываться с речью. Обходить это можно средним планом, но не всегда.
Руки и мелкие предметы. Пальцы слипаются, посуда меняет форму между кадрами, текст на упаковке превращается в узор.
Быстрое движение. Бег, танец, спорт дают смазы и двойные контуры. Помогает замедление исходника перед переделкой.
Длина. У Kling 3.0 диапазон от 3 до 15 секунд, у Veo 3.1 клип длится 4, 6 или 8 секунд (документация Gemini API (https://ai.google.dev/gemini-api/docs/veo)). Длинную сцену собирают из нескольких фрагментов, и стыки надо прятать руками.
Звук. Перенос стиля не переносит аудио. Дорожку берут из исходника или собирают заново.
Права на исходник
Здесь начинается часть, о которой вспоминают поздно. Переделка создаёт новое произведение на основе чужого. Если исходник снят вами или оплачен по договору с исполнителем, вопросов нет. Если это сток, смотрите лицензию: часть лицензий запрещает производные работы и использование в обучении.
Если в кадре люди, нужно согласие на использование изображения. Для сотрудников это отдельный документ, для моделей и актёров пункт в договоре. Замена лица на чужое без согласия человека превращает производственную задачу в риск претензии.
И третье: маркировка. Синтетический материал всё чаще требует пометки, правила по странам отличаются. Об этом отдельный разбор про маркировку ИИ-контента.
Смета и объём
Переделка считается по секундам исходника и по числу вариантов. Десять роликов по пятнадцать секунд на три стиля это сорок пять клипов, и каждый надо принять глазами.
Для ручной работы есть смысл считать по готовым роликам: ручные ролики от 16 000 ₽, включая раскадровку и приёмку. Для потока считают по просмотрам: от 0,10 ₽ за просмотр при объёме от ста роликов в месяц. В потоке переделка обычно нужна там, где делают массовые вертикальные ролики: одна сцена размножается на десятки версий.
Есть и другой путь: когда исходники уже есть и нужна сборка без перерисовки, работает монтаж из исходников вроде Mosaic Motion, и это дешевле генерации. Когда же задача в едином стиле на весь канал, помогает изготовление видео с помощью нейросетей по одному регламенту на все выпуски.