Что HeyGen добавил в голос
В ноябрьском разделе changelog HeyGen появилась запись про аудиотеги. Методы POST /v3/models/audio/tts и /tts/stream принимают их прямо в тексте: [whispers], [laughs] и остальные из списка. Всего поддерживается 201 тег.
Работает это не на всех голосах, и здесь главная тонкость. Публичные и instant-голоса исполняют теги на всех трёх моделях HeyGen Voice. Профессиональные клоны голоса теги не исполняют, и шёпота со смехом от них не дождаться.
Проверить просто. Возьмите фразу со смехом, прогоните её через публичный голос и через свой клон, послушайте оба файла. Так сразу видно, в голосе дело или в тексте.
Cinematic Avatar: аватар и голос как актёры шота
На стороне HeyGen Video поменялся вызов POST /v3/videos с type «cinematic_avatar»: он теперь принимает модель heygen_video_1. На выходе 16:9 или 9:16, 720p, длина от 5 до 15 секунд, до трёх аудиореференсов вместе с картинками и видео.
Практический смысл в том, что аватар со своим голосом перестаёт быть отдельной дорожкой, которую потом приклеивают к картинке. Он становится актёром внутри шота: движение, реплика и звук рождаются в одном проходе. Для сцены на десять секунд это ровно то, что нужно, а минута диалога всё равно собирается из кусков.
Higgsfield Intone: подсказки в квадратных скобках
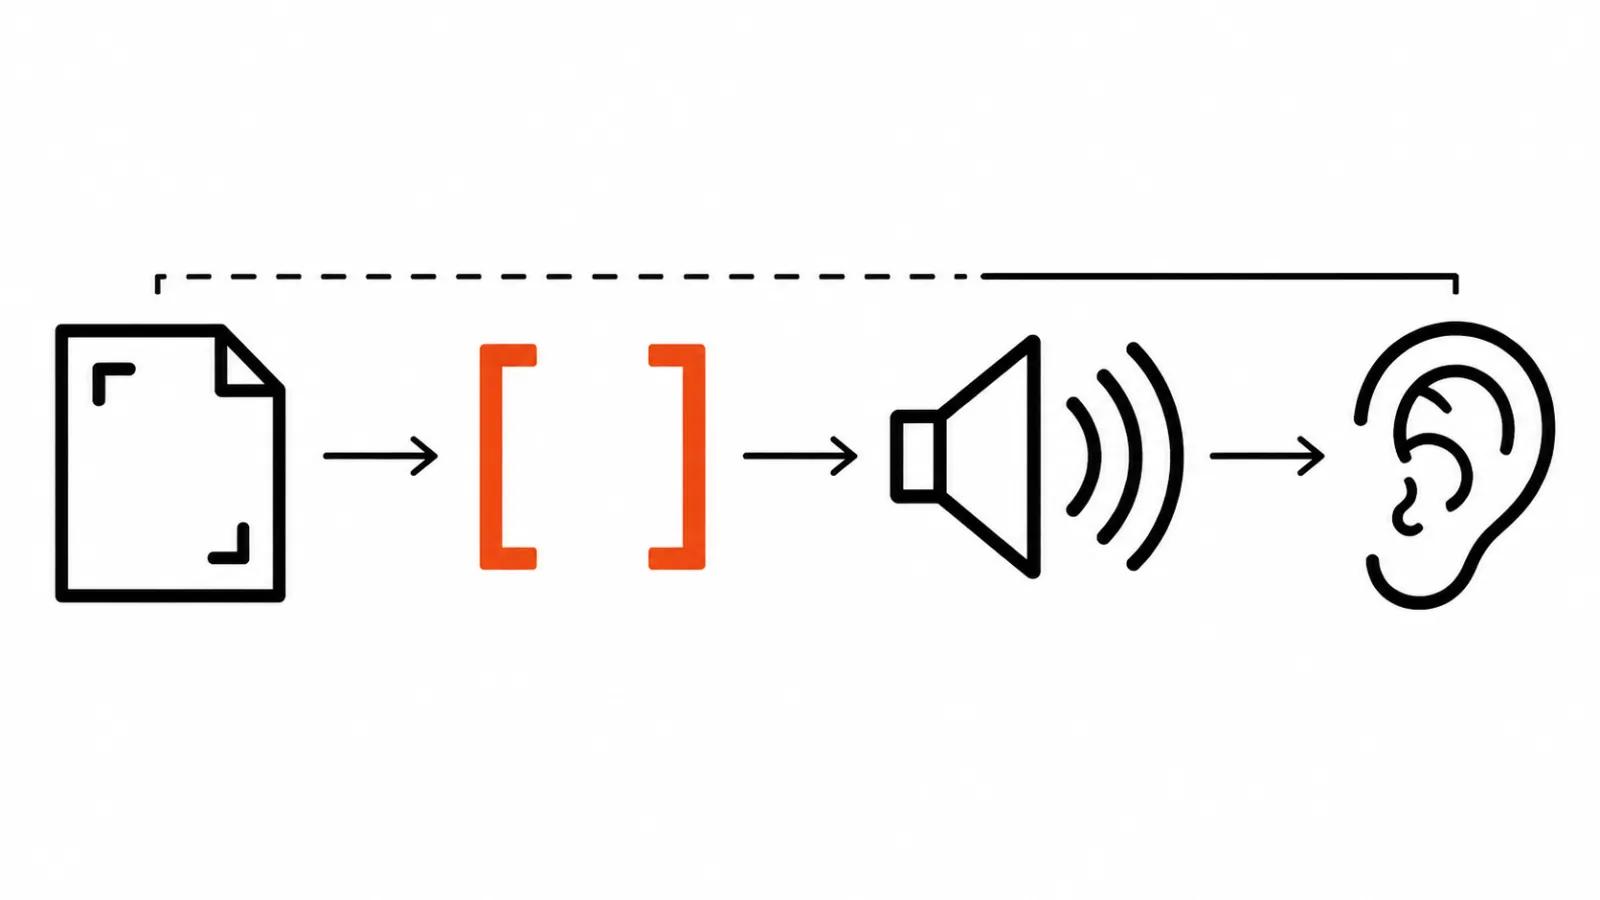
30 октября 2026 года Higgsfield выложил Intone в своём changelog. Инструмент собирает говорящего персонажа из трёх частей: персонаж (загруженное фото, в том числе своё, или герой из AI Influencer), локация и речь. Речь подаётся записью или генерируется на месте. На выходе видео с липсинком и одним голосом от сцены к сцене, до 30 секунд речи за генерацию.
Подача задаётся подсказками в квадратных скобках, например [smirks] или [short pause]. Рядом с этим 720p или 1080p, пять соотношений сторон и необязательный промпт для движения и камеры. Ограничение по 30 секундам означает, что длинный монолог режется на реплики, и каждая реплика проверяется отдельно.
Как создать ии видео с текстом и голосом: пять шагов
Рабочая схема для обоих сервисов выглядит так.
- Текст под голос. Короткие фразы, одна мысль на строку, без вложенных придаточных. Голос читает так же, как вы пишете: чем длиннее период, тем ровнее и мертвее подача.
- Теги. Один или два на абзац, в начале той фразы, где меняется состояние. Пять тегов подряд звучат как пародия, слушатель это слышит сразу.
- Голос. Для тегов берите публичный или instant-голос. Клон оставляйте для тех мест, где нужен узнаваемый тембр, и не ждите от него эмоций.
- Проверка на слух. Слушать целиком, не по фрагментам. Отдельный тег может звучать убедительно, а на стыке двух абзацев даёт провал.
- Сборка видео. Аватар, липсинк, тайминг. В HeyGen это шот на 5-15 секунд, в Intone сцена до 30 секунд речи, и склейка идёт на монтаже.
Нейросеть для генерации видео с голосом: где она ломается
Первое место: клон. Если весь ролик озвучен профессиональным клоном, теги в тексте просто не сработают. Проверять голос до начитки. После начитки поздно и дорого.
Второе: длина. Пятнадцать секунд шота и тридцать секунд сцены диктуют ритм. Текст, написанный под минутный монолог, придётся переписать, иначе реплика обрывается на полуслове.
Третье: контекст. Instant-голос из картинки в HeyGen берёт атмосферу фона, тихую комнату или шумную улицу. Для рекламы это хорошо, для объяснения на десять минут шумная улица мешает.
Четвёртое: набор возможностей вокруг голоса вырос за октябрь. Speech to speech переозвучивает запись до 300 секунд instant-голосом с теми же словами и таймингом, HeyGen Voice 1 Turbo снижает задержку instant-голосов, превью голоса показывают до генерации. Всё это про экономию дублей, и всё это надо проверять на своих текстах.
Квадратные скобки как общий язык режиссуры
Мой довод простой: два сервиса с разной архитектурой пришли к одному синтаксису. HeyGen держит теги на уровне API, Higgsfield на уровне промпта сцены, а на выходе автор пишет одно и то же: [whispers], [laughs], [short pause], [smirks]. Это уже не фича одного вендора, это способ разговаривать с моделью о подаче.
Отсюда следует практика. Текст ролика стоит хранить отдельно от генерации, с тегами внутри, чтобы переносить между сервисами. Если через месяц голос подешевеет у другого вендора, вы меняете инструмент и оставляете сценарий.
Второй вывод про людей. Режиссёр голоса раньше работал на студии с диктором: подходил, просил «тише, с усмешкой, пауза». Теперь эта же работа выглядит как правка текста, и делать её может автор сценария. У нас есть общий гайд по озвучке, там про выбор голоса и начитку, а здесь речь про управление подачей внутри строки.
Мой вывод
Теги не отменяют проверку на слух, они сокращают число дублей. На короткой сцене выигрыш очевиден, на длинном монологе всё решает монтаж.
Что делать первым делом: переписать сценарий короткими фразами, поставить по одному тегу на абзац, прогнать через публичный голос, послушать и только потом трогать аватар. Для короткой сцены на одну-две реплики хватает шота HeyGen, для говорящего персонажа в кадре удобнее Intone с его скобками и пятью соотношениями сторон.
Где схема не спасает, так это на сложной сцене: перебивки, смена локаций, реакция героя на реплику партнёра. Здесь нужен человек за монтажом, и ручные ролики от 16 000 ₽ остаются точкой отсчёта по трудозатратам. Если задача в повторяемых коротких репликах, подойдут ИИ-аватары и один шаблон на серию.
Отдельно про ожидания. Аудиотеги в HeyGen добавили в ноябре, инструмент Intone вышел 30 октября, обоим меньше недели. Первые ролики на них ещё не набрали статистику, так что цифры по вовлечению брать неоткуда. Смотрите на свою нишу и свою длину, демо из changelog статистику не заменяет.