Что придумали в K2V
12 ноября 2026 на arXiv вышла работа «K2V: Generative Keyframing For Physically Plausible Video Generation». Авторы Felix O'Mahony, Daniel Olmeda Reino, Roberto Cipolla и Ayush Tewari. Кембриджский университет и Toyota Motor Europe, номер 2611.17324. Название переводится скучно, генерация ключевых кадров для физически правдоподобного видео, а за ним стоит перераспределение работы между двумя моделями.
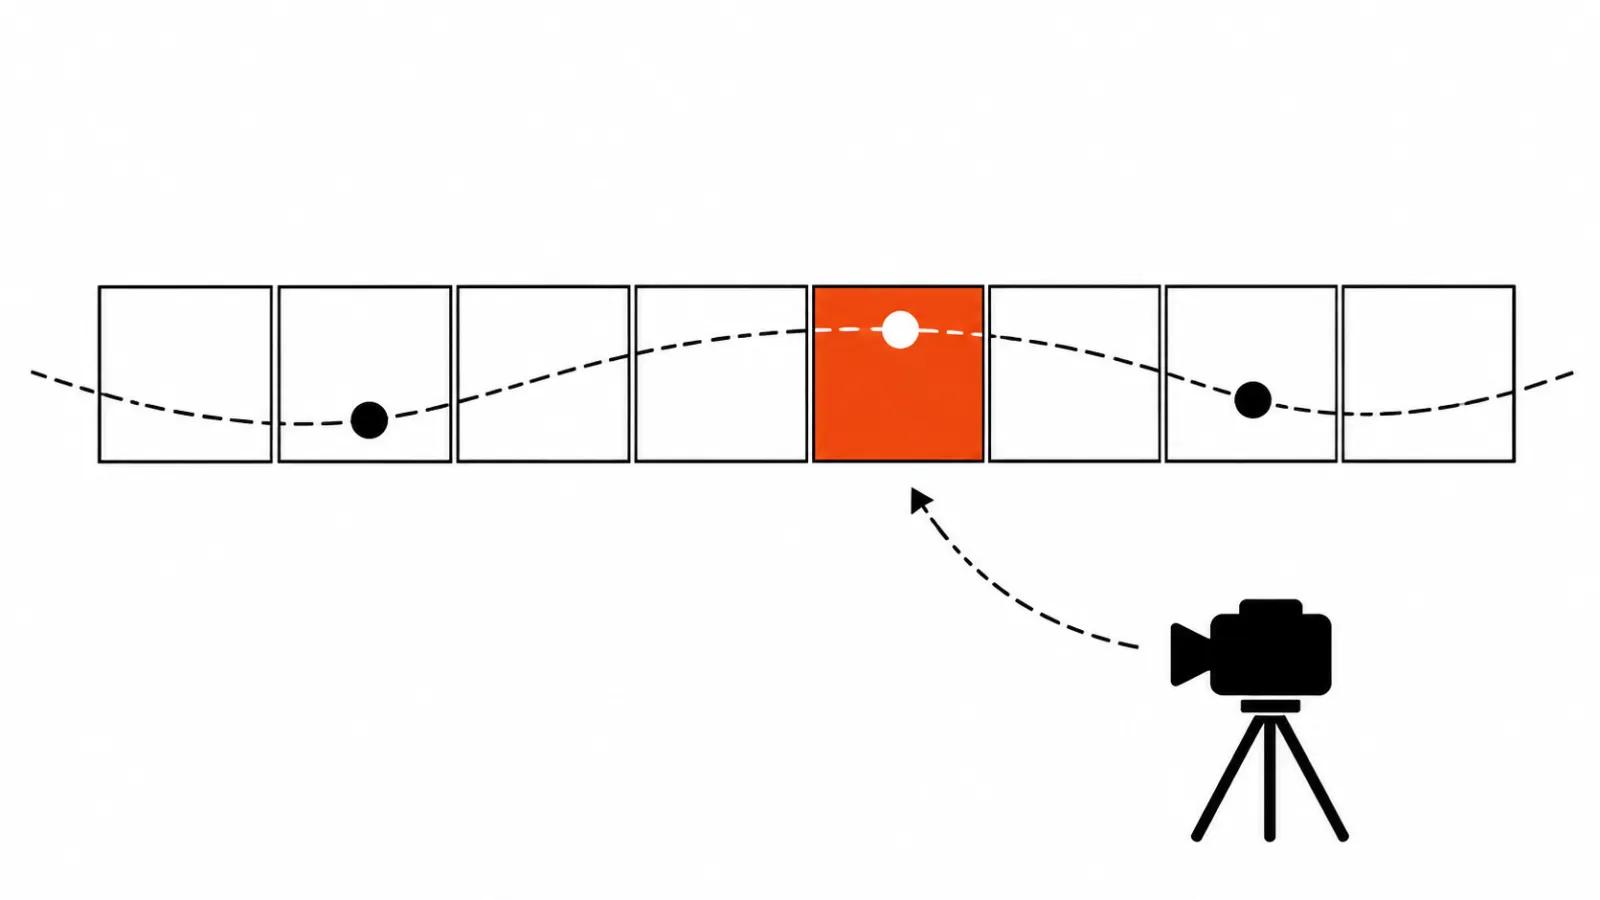
Одна видеомодель делает всё: читает промпт, придумывает движение, рисует кадры. K2V делит обязанности. Языковая модель рассуждает словами о том, что должно произойти, и собирает ключевые кадры в те моменты, где физика решается: удар, падение, касание. Видеомодель получает эти кадры как условие и заполняет промежутки между уже правильными состояниями.
Задача поставлена честно: считать отдают тому, кто рассуждает текстом, рисовать тому, кто умеет рисовать.
Почему нейросети для создания реалистичных видео врут про физику
Видеомодель обучена делать похоже, физику она не считает. Красивая дуга полёта мяча для неё такая же допустимая картинка, как настоящая парабола. Ошибку видно не всегда: кадр выглядит живым, а рука проходит сквозь стол или вода наливается в стакан под странным углом.
Именно это измеряют тесты Physics-IQ, VideoPhy-2, PhyGenBench и PhyWorldBench, на них и опираются авторы. У нас есть разбор бенчмарка физики на PhyRubric, и даже сильные модели там далеки от идеала. Такие тесты дают проценты попаданий вместо слов «выглядит убедительно».
Разделение труда: слова, кадры, промежутки
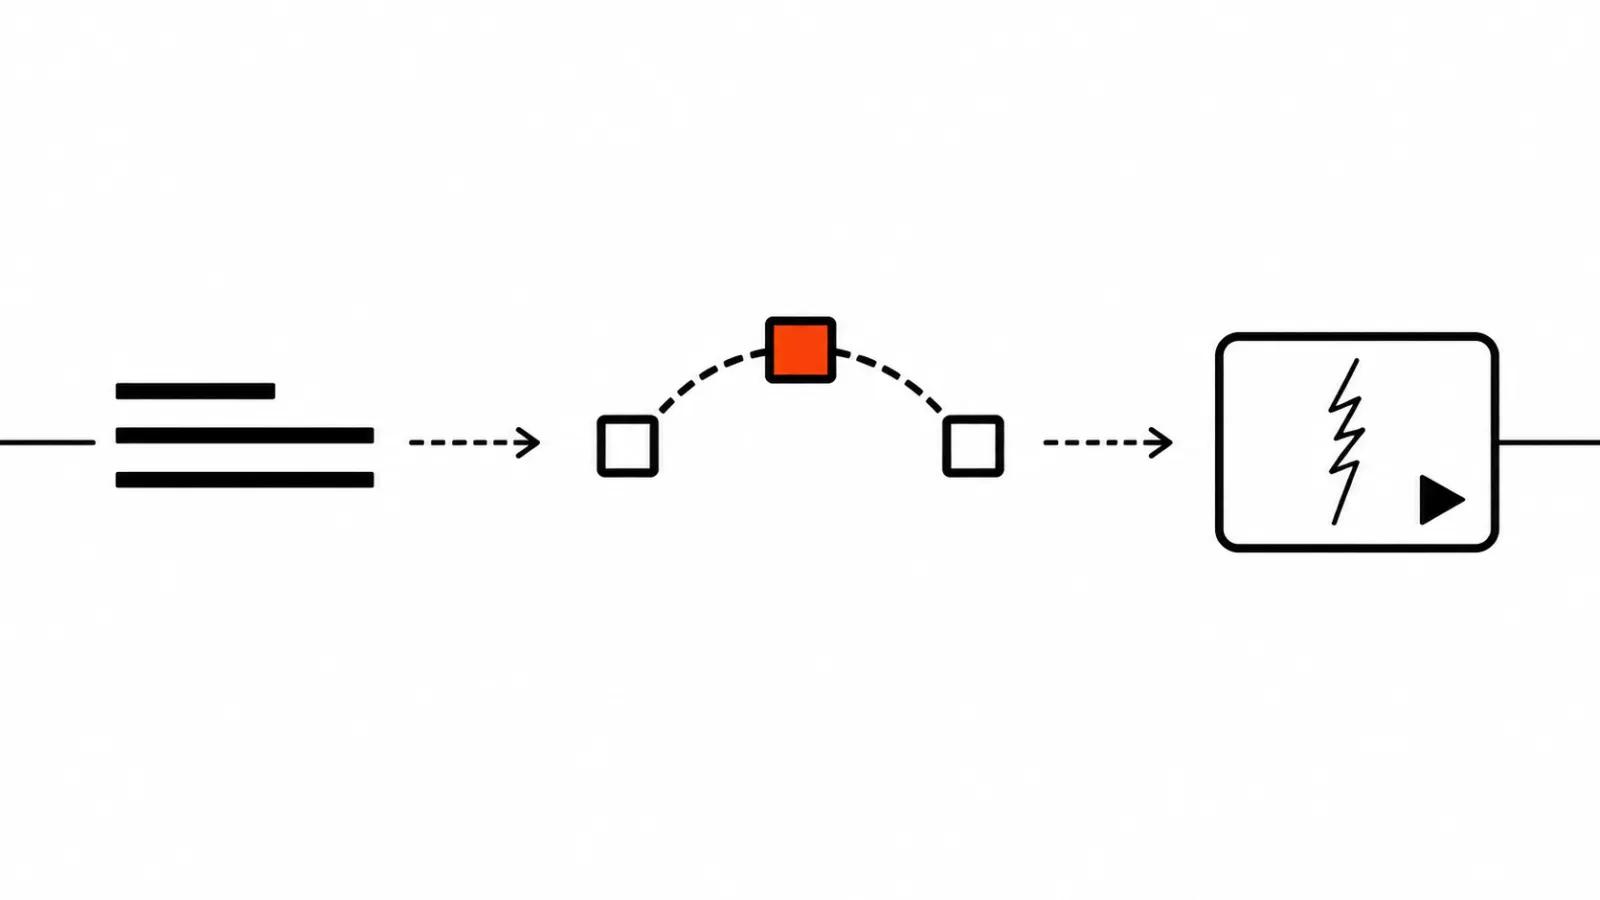
Внутри K2V три роли, и это самое интересное в статье.
Планировщик. Агент на Gemini 3.8 Flash делает несколько вызовов подряд, расписывает, что должно случиться по ходу движения, и решает, какие состояния важны. По таблице 4 в статье на одну задачу Physics-IQ уходит 6,1 вызова, на задачу PhyGenBench 10,1.
Художник ключевых кадров. Gemini 3.1 Flash Image правит и дорисовывает кадры на этих опорных точках: 1,7 картинки на Physics-IQ и 2,9 на PhyGenBench.
Исполнитель. Wan2.2-14B получает готовые кадры как условие и один раз генерирует ролик, заполняя переходы между ними.
Ключевые кадры в ИИ-видео обычно ставят на входе и на выходе клипа, а тут их расставляют по ходу действия, ровно туда, где модель чаще всего ошибается. Получается просьба «сделай так, вот в этих трёх состояниях» вместо «сделай красиво».
Что показывают цифры авторов
Результат по тексту статьи: заметно лучше существующих подходов, лучший результат на Physics-IQ Verified и PhyGenBench. Это их собственные прогоны на двух тестах, без рецензии и без сторонней проверки, и держать в голове эту оговорку стоит.
Слабое место предсказуемое. Качество упирается в то, насколько точно планировщик описал физику словами: неверно понял столкновение, и ключевой кадр выйдет таким же неверным, только сделанным уверенно.
Сколько стоит такой ролик
Авторы посчитали деньги, редкая для исследовательской работы любезность. Таблица 4, цены на 8 октября 2026, пересчитываю в рубли по 84.
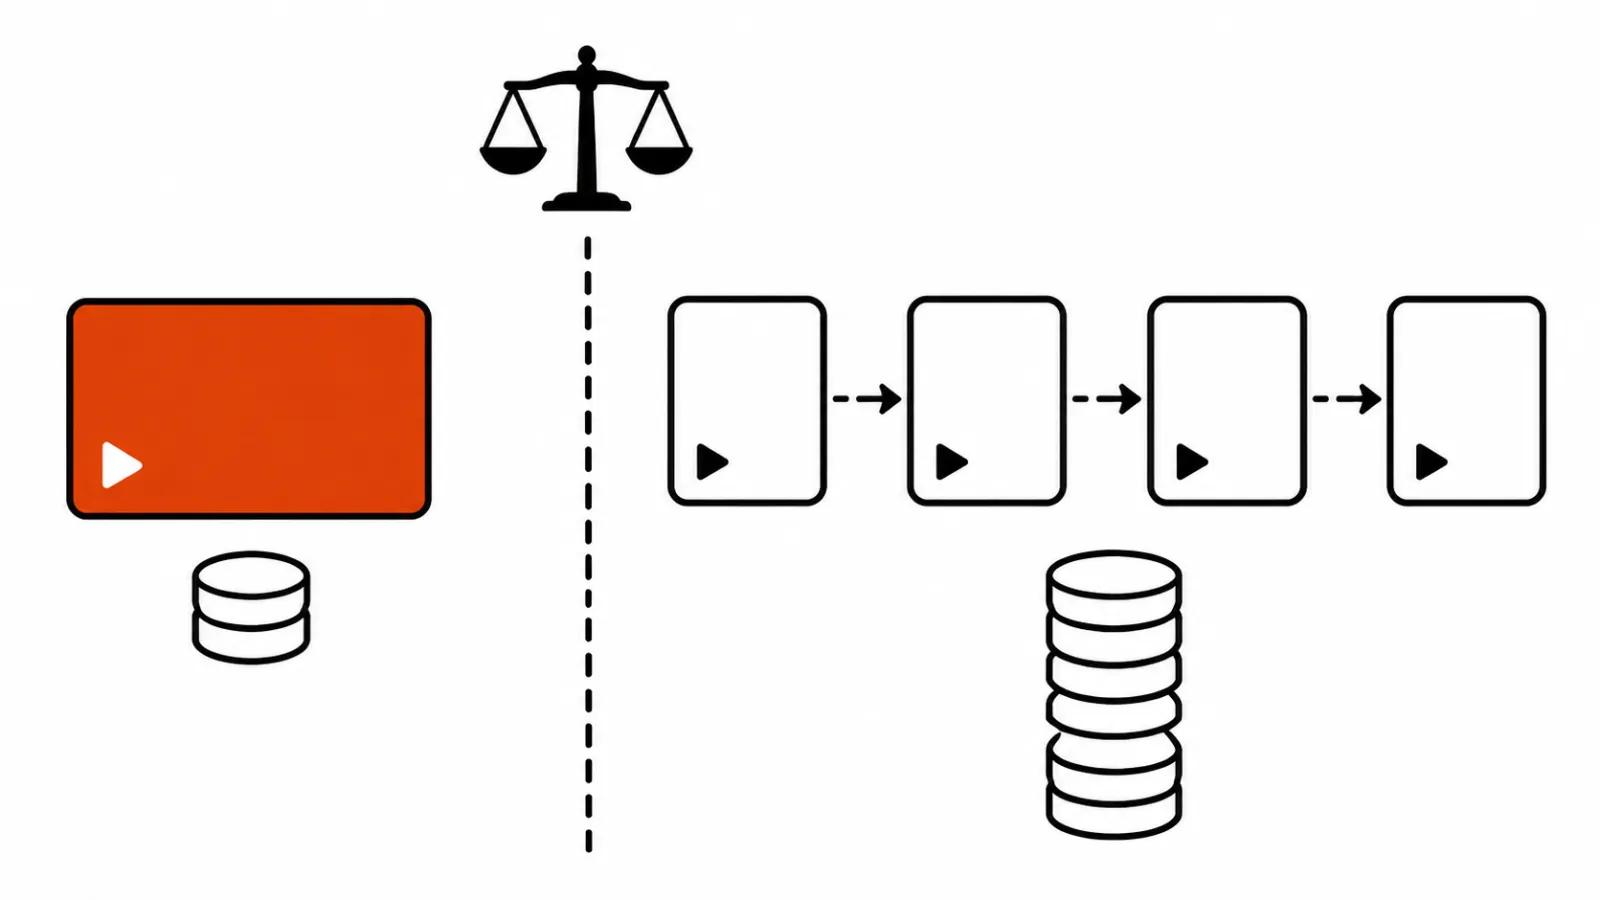
Генерация видео: один ролик Wan2.2-14B, около 14 ₽. Планирование и правки кадров идут по вызовам и картинкам, в сумме на Physics-IQ выходит 39 ₽ за ролик, на PhyGenBench 50 ₽.
Для сравнения в статье стоит система NEWTON, которая обходится в 246 ₽ за ролик: там четыре прогона Seedance 2.0 Fast. Разница в пять-шесть раз в пользу K2V: видеогенерация идёт один раз вместо четырёх и на открытой модели.
Считаю этот пункт важнее бенчмарка. Пока ролик стоит десятки рублей, можно позволить себе пробы и переделки, и именно на пробах появляется качество.
Что здесь не так
K2V это исследовательская работа. Продукта нет: ни сервиса, ни подписки, ни очереди заданий, ни гарантий, что подход доживёт до релиза в таком виде. Повторить схему самому можно только частично: языковая модель и генератор картинок доступны, а связка с открытой видеомоделью требует сборки на своей машине.
Второе. С NEWTON в таблице сравниваются деньги, а качество авторы проверяют на своих тестах. О вашем материале это говорит мало: в кадре лицо, упаковка и свет.
Третье. Метрика физической правдоподобности остаётся грубой. Пока она считается процентами на наборе сцен, победа в ней означает победу на этом наборе.
Ключевые кадры руками: что повторяется уже сегодня
Главный вывод из работы касается порядка работы, и его можно применить без всякого K2V.
Разбить движение на моменты, где что-то решается. Удар, падение, касание, смена направления. Это те три-четыре точки, где модель обычно и врёт.
Для каждой точки сделать кадр: нарисовать, взять из референса или собрать в редакторе. Кадр должен быть правильным по позе и контакту, потому что дальше модель будет опираться на него.
Остальное отдать видеомодели: переходы, размытие, движение камеры. С этим она справляется увереннее, когда опорные точки заданы.
Проверять стыки. Смотреть надо на вход в ключевой кадр и на выход из него: там видно, держит ли модель физику или начинает додумывать.
Это же аргумент в пользу ручной сборки важных сцен. Когда ролик делается видео нейросетями, ключевые кадры в дорогих местах рисует человек, и брак не уезжает в тираж. Для рекламы это особенно важно: рекламный ролик с ударом, наливом или падением почти всегда содержит момент, где физика видна крупно. Ручные ролики у нас идут от 16 000 ₽, и там за такие кадры отвечает человек.
Мой вывод
Идея с разделением труда кажется мне важнее конкретных процентов в статье. От одной видеомодели годами ждали две разные вещи: считать и рисовать. K2V показывает, что их можно развести, и собирает связку из языковой модели, генератора картинок и открытой видеомодели.
Практический вывод на этот месяц простой. Ключевые кадры в важные моменты действия задают физику надёжнее длинного промпта с её описанием. Если сцена содержит удар, падение или касание, ставьте кадр на этот момент и не ждите, что модель догадается сама.
Порядок «сначала опорные состояния, потом переходы» стоит забрать себе сейчас, потому что он не зависит от того, чем закончится история K2V.