Что именно вышло 26 октября
Порция arXiv за 26 октября принесла четыре препринта, которые не связаны, но решают один класс задач. Речь про согласованность: между кадрами, между камерами, между голосом и губами.
SyncVid генерирует несколько видео одной сцены с разных точек, AudioLift делает объёмную говорящую голову из одной фотографии, DirCast собирает телевизионную трансляцию в реальном времени, X-Dubbing переносит речь на другой язык с привязкой к таймингу и картинке. Все четыре текста выложены 26 октября.
Это не релизы продуктов, кода и весов может не быть. Дальше разбор заявлений авторов и следствий для практики.
1. SyncVid: несколько камер из одного ролика
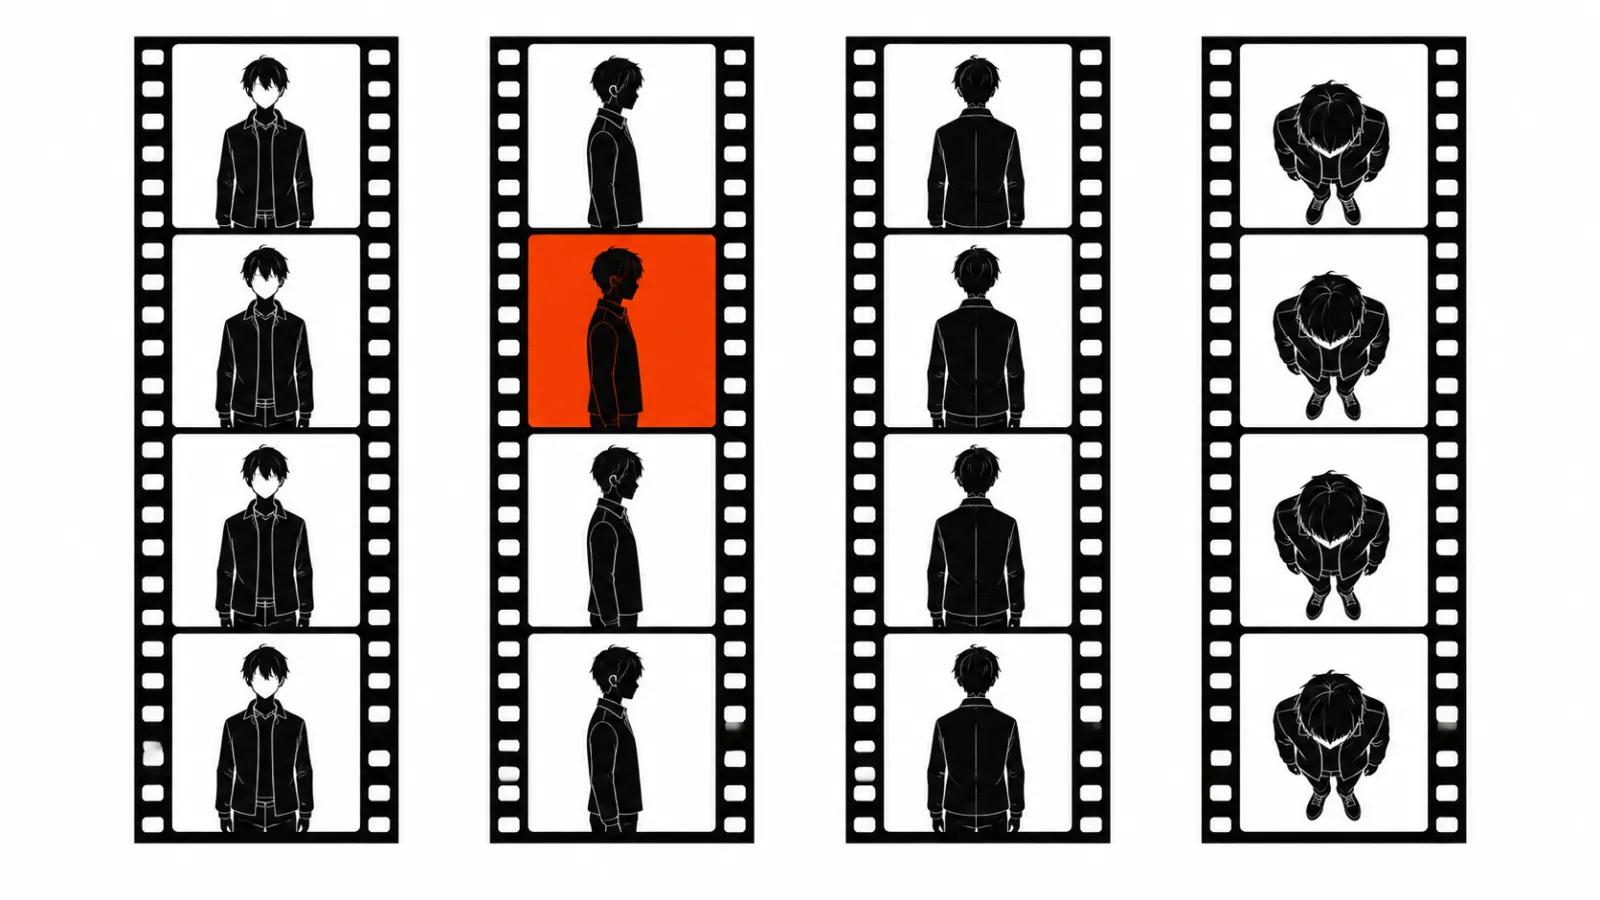
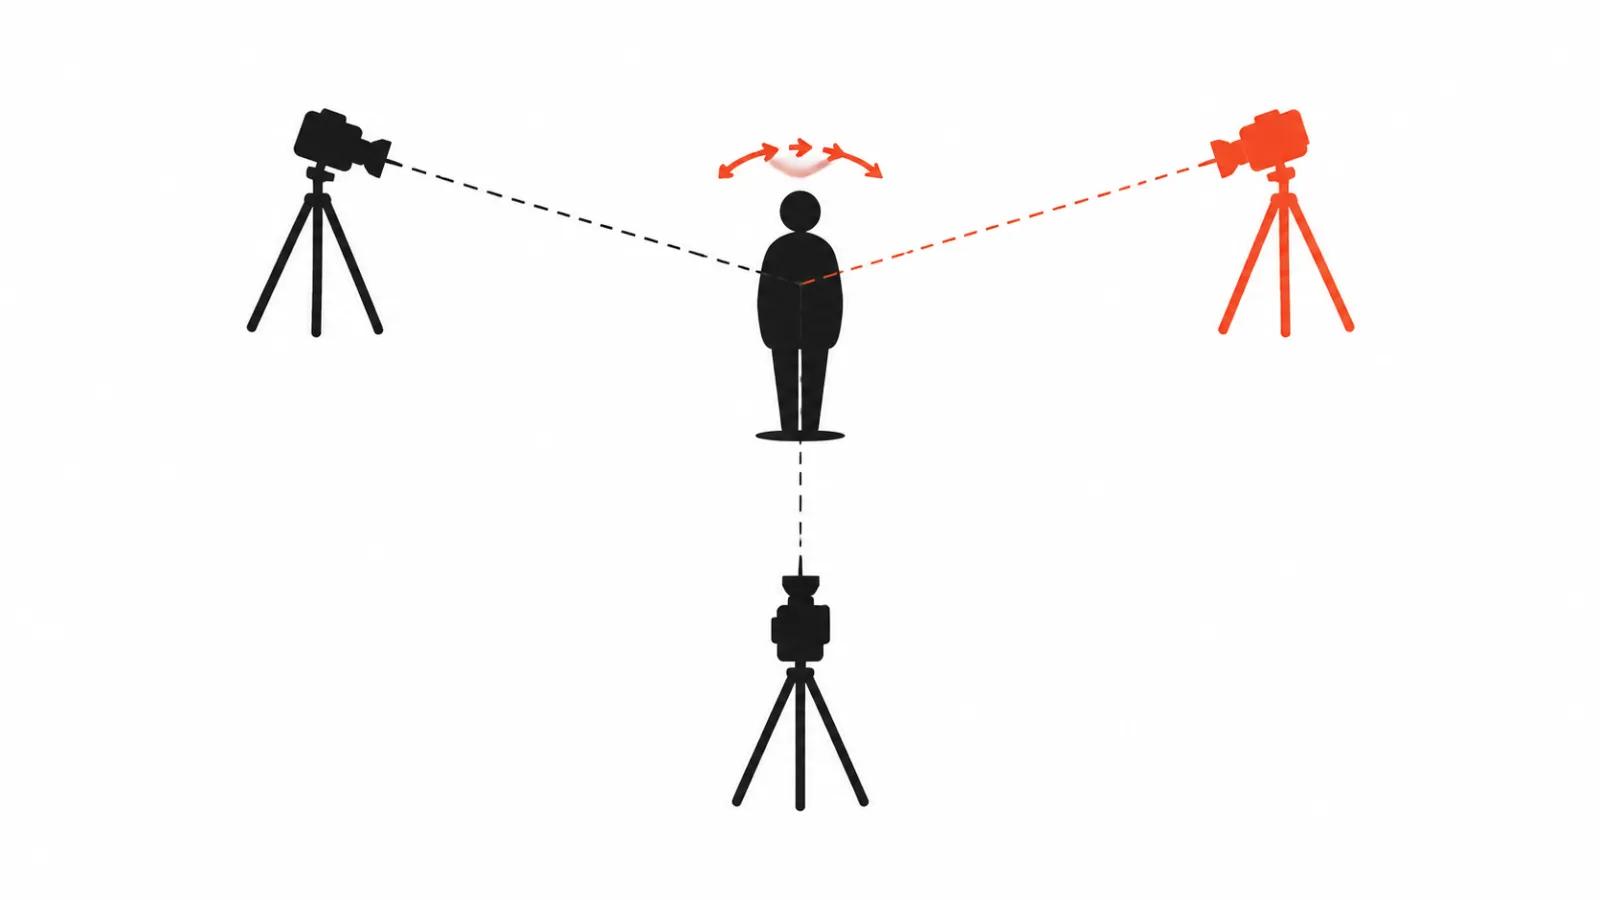
Задача простая: есть ролик с камеры А, нужен тот же момент с камеры Б, причём с покадровым совпадением движения.
Раньше управление камерой в видеодиффузии строили через эмбеддинги камеры, кросс-внимание между видами и геометрические условия. Для статичной сцены приём работает. Для мелкой динамической геометрии, которая должна оставаться согласованной между ракурсами и во времени, он разваливается.
Решение лежит в плоскости шума. Гауссов шум сэмплируют в каноническом трёхмерном пространстве, построенном по исходному видео, и растрируют его в целевые камеры. Независимая выборка в двумерной плоскости кадра больше не используется. Рендер даёт локальные корреляции между соседними пикселями, поэтому добавлена процедура cross-view-consistent whitening: она убирает корреляцию, сохраняя соответствие между видами.
Структурный шум работает как приор для предобученной модели видеодиффузии с LoRA-адаптером, архитектуру менять не нужно.
Почему это важно. Согласованность живёт в шуме, слои внимания остаются прежними. Такой приём дешевле переносится на новые модели: меняется база, адаптер и приём с шумом остаются. Для съёмок, где один дубль нужно разложить на несколько ракурсов, это прямой путь к экономии на второй камере.
2. DirCast: режиссёр и комментатор в одной модели
Живая трансляция киберспорта держится на двух людях: режиссёр решает, какая камера идёт в эфир, комментатор говорит поверх картинки. Оба работают вслепую, потому что не знают, что случится через секунду.
Потоковые видеоязыковые модели уже умели комментировать, но только готовый эфир, который собрал человек. DirCast ставит задачу иначе: модель получает сырые камеры всех игроков и должна сама и режиссировать, и говорить, опираясь только на прошлое.
Каждую секунду модель просматривает все камеры в низком разрешении, решает через модуль hold-or-switch, куда переключиться, и только выбранную камеру читает в высоком разрешении перед тем, как сказать фразу. Контекст хранит то, что уже ушло в эфир, и то, что было сказано, остальные виды истекают. Стоимость обработки потока любой длины остаётся ограниченной.
Датасет собрали авторы: 27 матчей Dota 2 профессионального уровня, камера на каждого героя, решения человеческого режиссёра и комментарии кастеров. Против правил и zero-shot режиссёров модель выигрывает, включая GPT-5. Комментарий DirCast выиграл 29,2 процента сравнений против GPT-4o по протоколу Proact-VL, у сильнейшего из одиннадцати потоковых комментаторов, которые смотрят человеческий эфир, результат 19,4 процента.
Почему это важно. Здесь в одной модели соединены решение о монтаже и речь. Для онлайн-трансляций и вебинаров это означает, что режиссёрская работа становится функцией модели, а человек остаётся на постановке задачи и на редактуре.
3. AudioLift: говорящая голова из одного портрета
Трёхмерные говорящие аватары обычно строят на параметрических моделях лица, таких как 3DMM или FLAME. Компактное представление движения ограничивает выразительность и мешает с аксессуарами: головной убор в такую схему вписывается плохо.
AudioLift обходится без параметрических моделей и без оптимизации под каждый экземпляр. Схема из двух этапов: синхронная генерация видео с нескольких ракурсов, затем устойчивая к несогласованностям гауссова реконструкция, которая восстанавливает связную геометрию полной головы из одного портретного изображения.
Авторы заявляют, что метод ловит более экстремальные выражения лица, даёт лучшую геометрическую полноту и держит согласованность по всему диапазону в 360 градусов. Видео с нескольких ракурсов здесь работает как промежуточное представление: картинки выступают мостом между звуком и трёхмерной моделью.
Почему это важно. Если приём подтвердится на живых людях, производство цифровых аватаров упростится до одной фотографии. Для говорящего аватара в видео это снимает главный барьер: необходимость сканирования.
4. X-Dubbing: дубляж с привязкой к артикуляции
Дубляж упирается в тайминг. Языки различаются длительностью, ритмом и артикуляцией, и синхронный по смыслу перевод часто не помещается в исходную длину реплики.
X-Dubbing формулирует задачу как совместную: перевод речи в текст с учётом времени плюс синтез речи с учётом видео. Dubbing Translator выдаёт сценарий с временной структурой, Voice Actor озвучивает его в синхроне с исходником, оба опираются на единый языконезависимый бюджет времени. Транслятор дообучают по обратной связи от синтезированной речи, чтобы сценарий сразу давал синхронный дубляж.
Парные данные дубляжа при этом не нужны: компоненты учатся на парах речь-текст и на одноязычных аудиовизуальных данных. Метрики в работе две: изохрония и аудиовизуальное соответствие. По ним X-Dubbing обходит недавние базовые решения.
Почему это важно. Дубляж перестаёт быть отдельной услугой с отдельной студией. Он становится параметром генерации, который можно включить на этапе сборки ролика.
Что общего у четырёх работ
Тема одна: согласованность. SyncVid держит её в пространстве и времени, DirCast в решениях и речи, AudioLift между звуком и геометрией, X-Dubbing между языком и губами.
Второе общее место: почти везде обходятся без переобучения тяжёлой базовой модели. LoRA-адаптер, промежуточное представление, обратная связь от синтеза.
Третье: данные. DirCast построен на 27 матчах с решениями живого режиссёра и комментариями кастеров.
Где нейросеть для видео пригодится на практике
Для контента, который делают видео нейросетями, первый эффект очевиден: один исходный дубль раскладывается на несколько ракурсов, и вертикальная реклама 9:16 собирается из того же материала, что и горизонтальная версия.
Трансляции и вебинары получают автоматического режиссёра: нагрузка на оператора падает, комментарий можно включить отдельной дорожкой. Там, где нужен живой человек в кадре, остаются ручные ролики.
Если дубляж становится функцией сборки, ведение YouTube-канала на два языка перестаёт требовать отдельной студии.
Ни один текст не даёт гарантий на промышленное качество. Всё это лабораторные результаты авторов, у DirCast к тому же один игровой жанр, у X-Dubbing сравнение с базовыми решениями по метрикам.
Что проверить, когда появится код
Смотреть стоит на три вещи. Открыты ли веса и код. Как метод ведёт себя на длинных роликах, где ошибка накапливается. Что с правами на обучающие данные, особенно про лица и голоса.
Пока это препринты. Любые обещания в них стоит читать как обещания авторов и проверять независимыми прогонами.