Что значит «губы попали в звук»
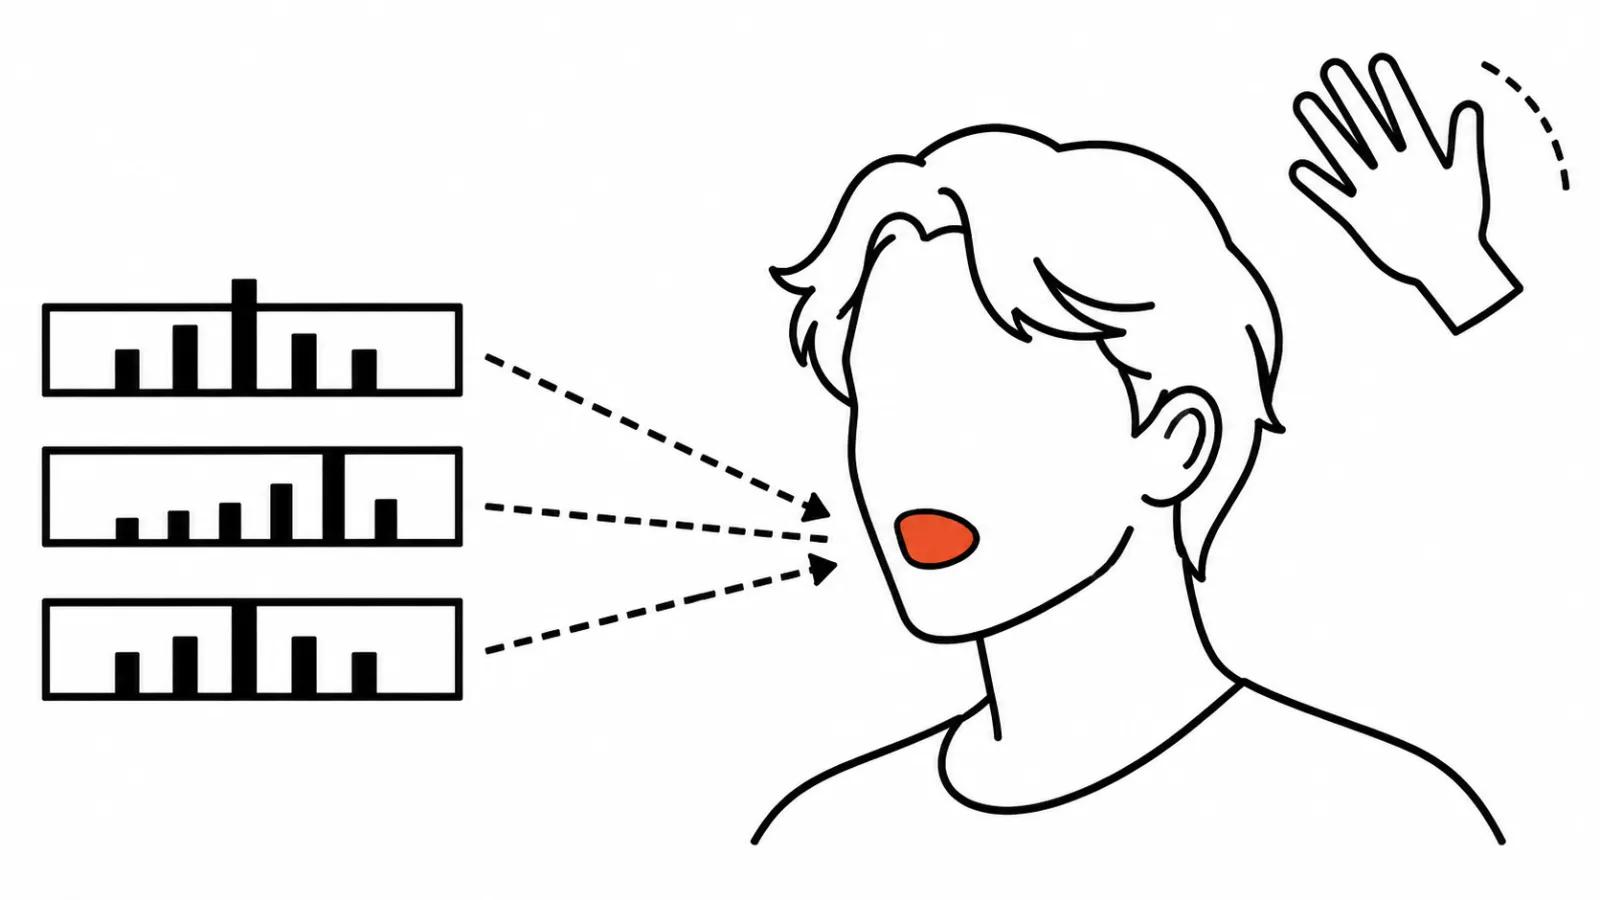
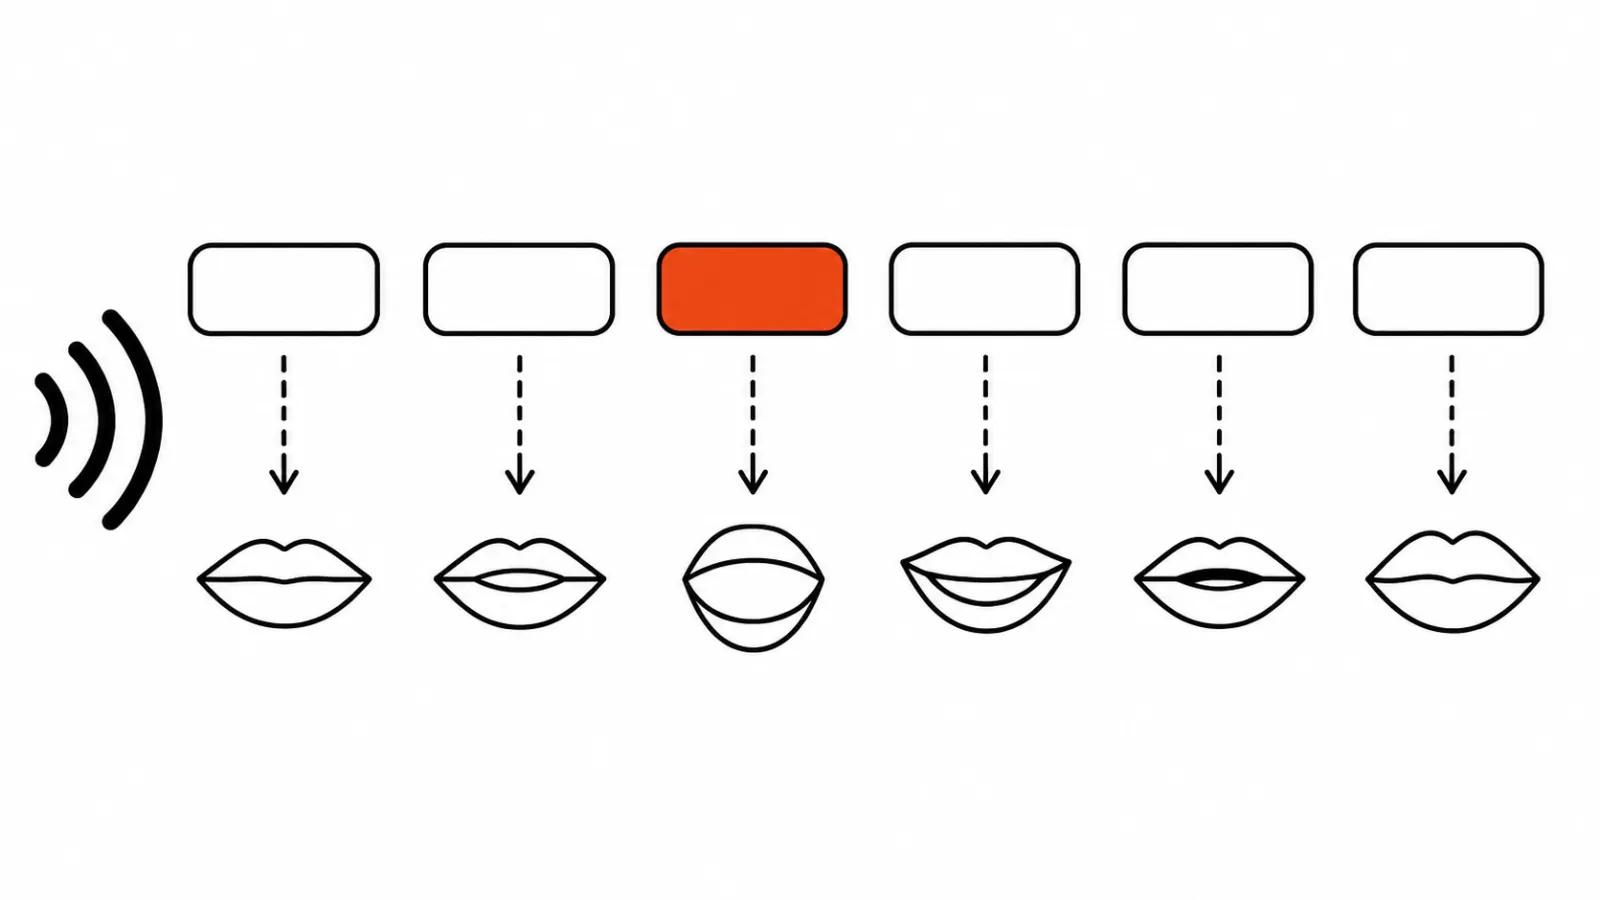
Эта фраза описывает узкий момент: человек произносит слово, и рот закрывается на том же кадре, где замолкает голос. Механика за этим простая. Звук режут на короткие отрезки, доли секунды. Каждому отрезку соответствует положение губ, языка и челюсти. Модель учится связывать звучание с формой рта и потом по новой дорожке дорисовывает лицо так, чтобы форма совпала.
Формулы тут не нужны, но граница понимания нужна. Совпадение рта с голосом это нижняя планка. Дальше зритель читает лицо целиком: моргание, наклон головы, движение плеч, жест, попавший на ударный слог. Когда всё это живёт отдельно от речи, ролик выглядит странно, даже если губы совпали идеально.
От накладного рта к видео, нарисованному по звуку
Старый подход работал как заплатка. Брали готовый кадр, находили область рта и подменяли её новой формой. Остальное лицо оставалось почти неподвижным. На короткой реплике это проходит, на длинной фразе видно: щёки не участвуют, челюсть стоит, граница заплатки выдаёт себя на свете.
Новый подход перестраивает кадр целиком по звуку. Видеомодель рисует лицо, голову и руки, ориентируясь на аудио. HeyGen в Avatar 6 (пресс-релиз 17 ноября) говорит об этом прямо: движение строится по аудио, модель читает скрипт и подачу и подбирает жесты. Gemini Omni 1.2 Flash в Google Cloud в тот же день обещает более естественный диалог, чище липсинк и несколько говорящих в одном ролике. Suno Visuals подхватывает слова песни и синхронизирует губы в клипе.
Runway Characters идёт дальше по частоте обновления: модель делает новые куски видео по четыре кадра на 24 к/с каждые 166,7 мс, чтобы речь и лицо шли без пауз. Четыре кадра это примерно шестая часть секунды, и такой шаг не даёт движению замирать между блоками.
Зачем модели длинное окно контекста
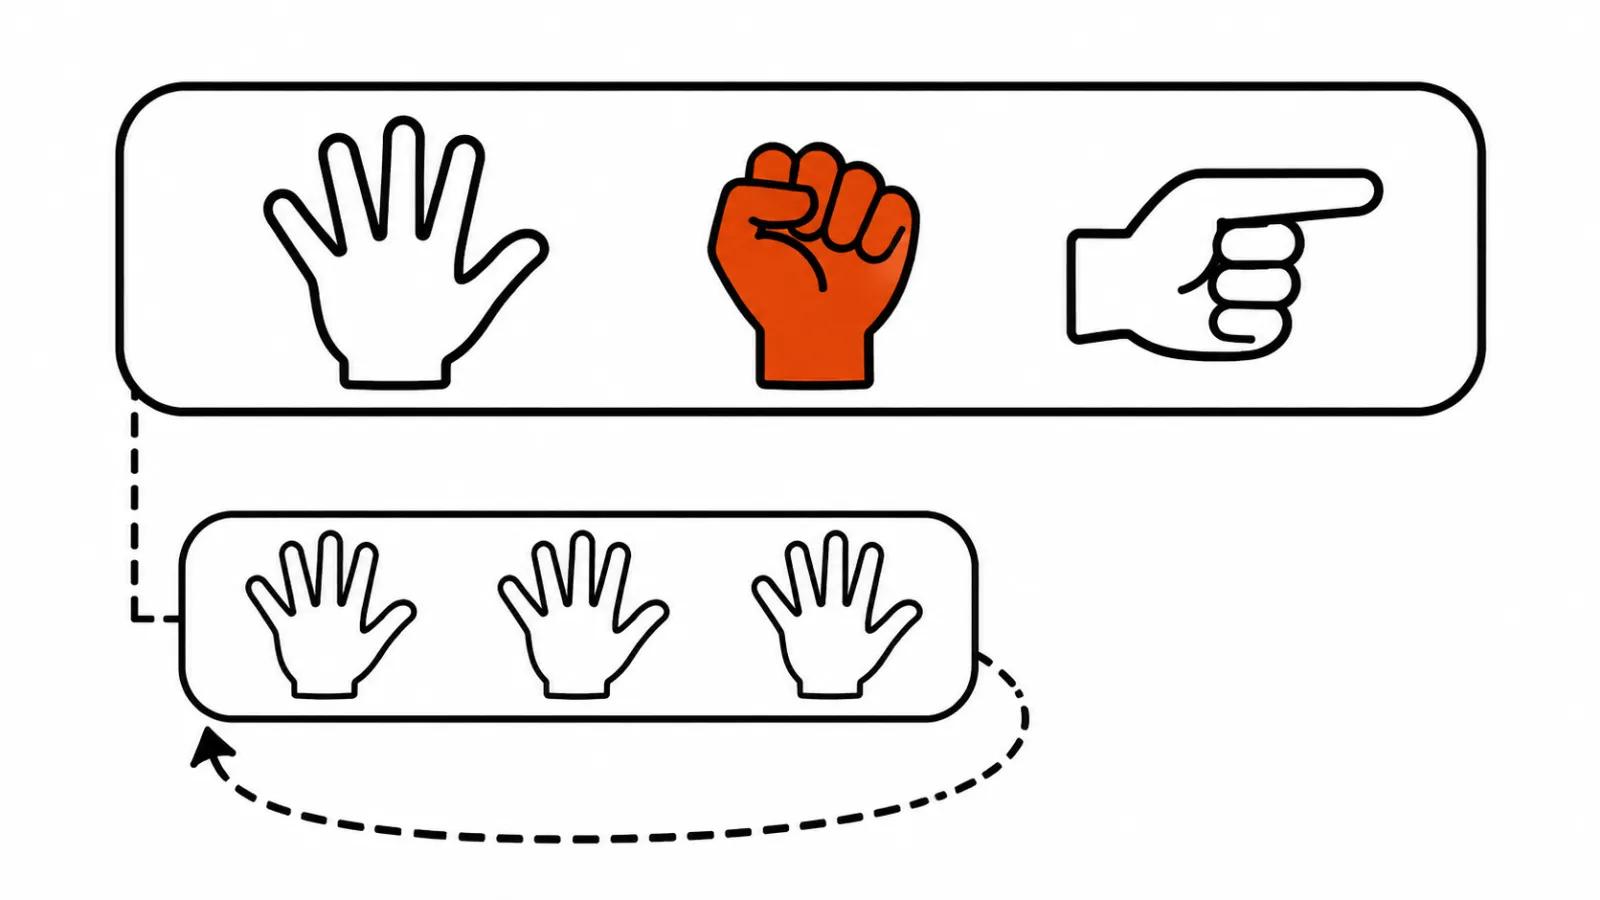
Короткое окно контекста означает короткую память. Модель видит несколько секунд звука и дорисовывает движение, помня только их. Потом она начинает отрезок заново, и жест повторяется: та же поднятая рука, тот же кивок, тот же поворот головы. На слух всё чисто, на глаз ролик читается как заевшая пластинка.
HeyGen в Avatar 6 увеличил окно примерно с 3 до 30 секунд. Модель помнит, какой жест уже был, и не выдаёт его снова. На тридцатисекундном ролике это заметно сильнее, чем на пятисекундной вставке. Для заказчика вывод простой: длинный кадр с говорящим человеком проверяют на повторяемость движений. Липсинк к десятой секунде обычно в порядке, а жесты начинают крутиться по кругу.
Почему синхронизация губ ломается
Причины повторяются. Шум и музыка в дорожке: модель слышит согласные хуже и ставит не ту форму рта. Чужой язык после перевода: артикуляция другой речи не совпадает с русскими звуками. Быстрая речь: на скорости модель не успевает за сменой слогов, и губы начинают жевать воздух. Закрытый рот: рука у лица, микрофон, край кадра.
Отдельный случай это профиль. В профиль видно мало, и модель достраивает губы по догадке. Отсюда правило съёмки: лицо анфас или в три четверти, рот открыт, ничто его не перекрывает. Для вертикальных роликов это значит ещё и достаточный отступ сверху, иначе рука в жесте уходит за границу экрана.
Как проверить готовый ролик за пять минут
Проверка занимает меньше времени, чем перегенерация. Смотреть надо на длинной фразе, где человек говорит без паузы секунд пять и больше, потому что там накапливается расхождение. Дальше согласные П, Б, М: на них губы должны смыкаться, и на стоп-кадре это видно.
Третье место это паузы. В тишине рот закрыт или расслаблен, артикулировать он не должен. Четвёртое: посмотреть со звуком на телефоне, потому что сжатие соцсети съедает мягкие движения и обнажает рывки. Пятое: прогнать один и тот же текст дважды и сравнить жесты. Если они совпадают кадр в кадр, окно контекста у модели короткое.
Согласие, проверка личности и водяные знаки
Личный аватар учится на записях человека, и HeyGen для него требует проверку личности. Для заказчика это значит: чужое лицо в ролике не проходит по документам сервиса. Для записи хватает примерно 30 секунд видео, и эти полминуты человек отдаёт добровольно, понимая, что модель будет говорить его голосом и его лицом.
Вторая часть это маркировка. Gemini Omni ставит на результат SynthID, невидимую метку, по которой происхождение можно проверить. Для рекламы это скорее плюс: подпись про нейросеть перестаёт быть вопросом честности и становится технической деталью.
Вывод
Порядок для нового проекта простой. Сначала тест на худшей фразе: длинной, с П, Б, М и паузой, секунд на пять. Потом решение про весь ролик. Если на тесте модель повторяет жест или мажет на смыкании губ, дальше будет то же самое, и второй прогон ничего не изменит.
Разрешение 2K я не считаю доказательством. Чёткая картинка с плывущим ртом выглядит хуже мягкой картинки с точной артикуляцией. Синхронизацию губ проверяют стоп-кадром, а цифра из описания модели тут ничего не доказывает.
Для линейки роликов с говорящим героем это уже рабочий инструмент. Аватар закрывает дешёвую часть задачи, когда видео нейросетями собирается пачками: говорящая голова для карточки товара, для объяснения услуги, для серии вставок в вертикальные сюжеты. Сильнее всего выигрывает вертикальная реклама, потому что лицо там крупное и любая рассинхронизация видна сразу.
Незакрытая тема это эмоция. Спокойную подачу модель держит, крик или шёпот пока требуют аккуратной записи и отдельной проверки. Смежная тема это то, как модель выбирает следующий кадр, потому что липсинк по сути частный случай предсказания кадра по звуку.
Смежные материалы: говорящий аватар в реальном времени.