Почему клип выглядит цельным, а внутри он нарезан
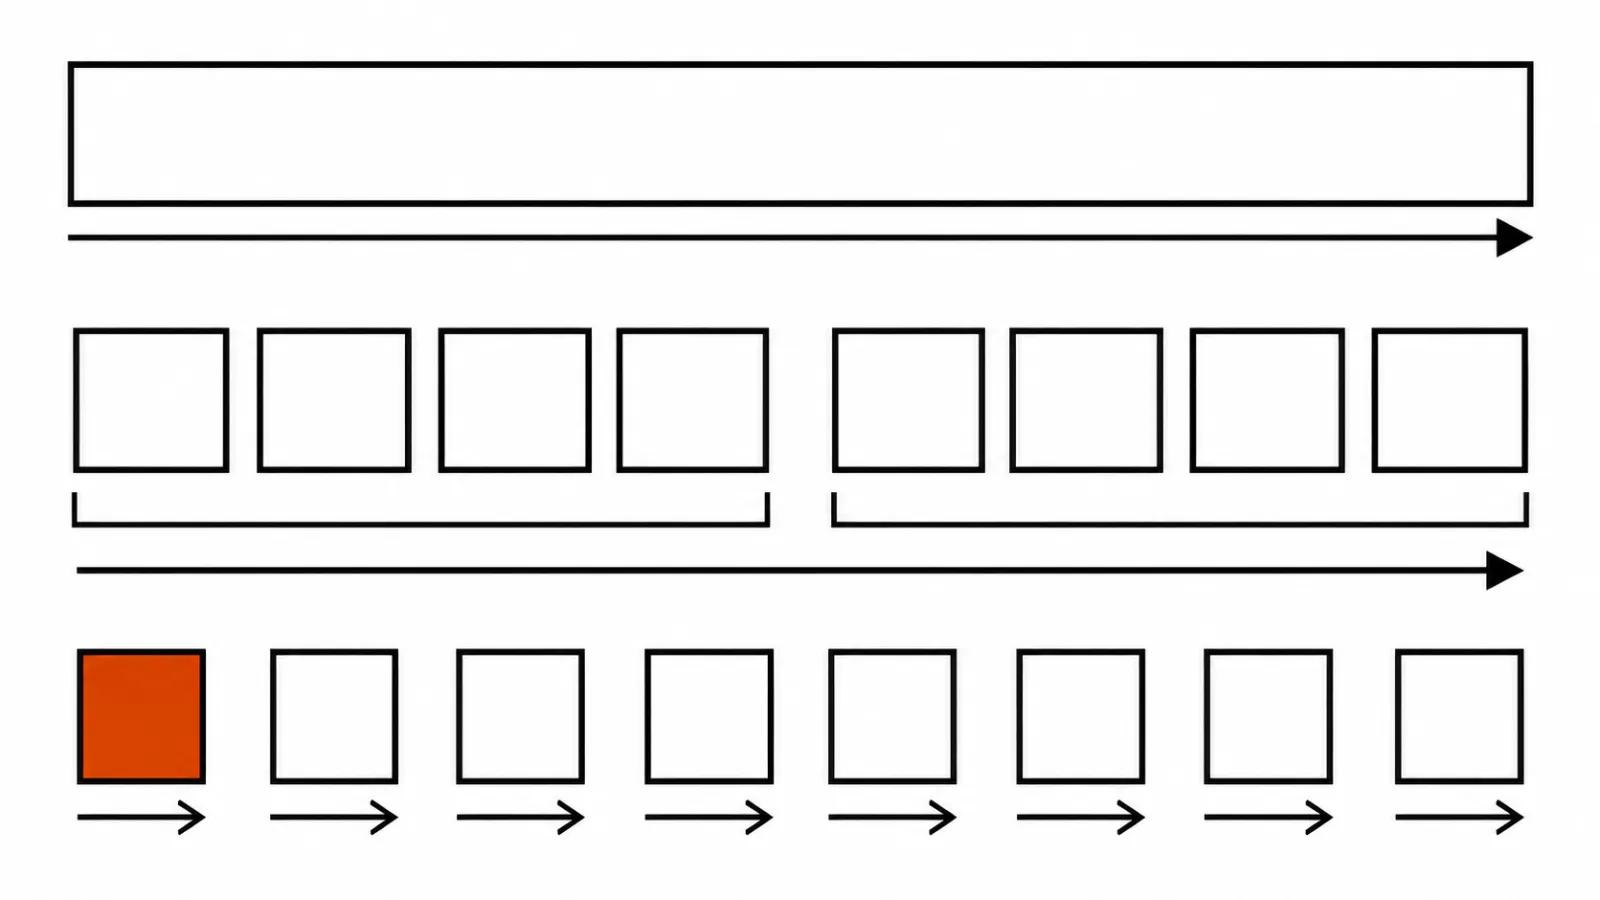
Вы пишете промт и получаете пять секунд движения. Внутри модель держит клип в сжатом виде, и дальше всё зависит от устройства: одни модели считают весь ролик сразу, другие идут блоками из нескольких кадров, третьи по одному кадру за шаг. От этого выбора зависят две вещи, которые замечает заказчик: скорость ответа на действие и то, насколько сцена уходит от задуманного к десятой секунде.
Слово «кадр» здесь ключевое. Потоковые модели предсказывают следующий фрагмент, опираясь только на прошлое, и размер этого фрагмента задаёт всю механику.
Как устроен генератор видео, который рисует клип целиком
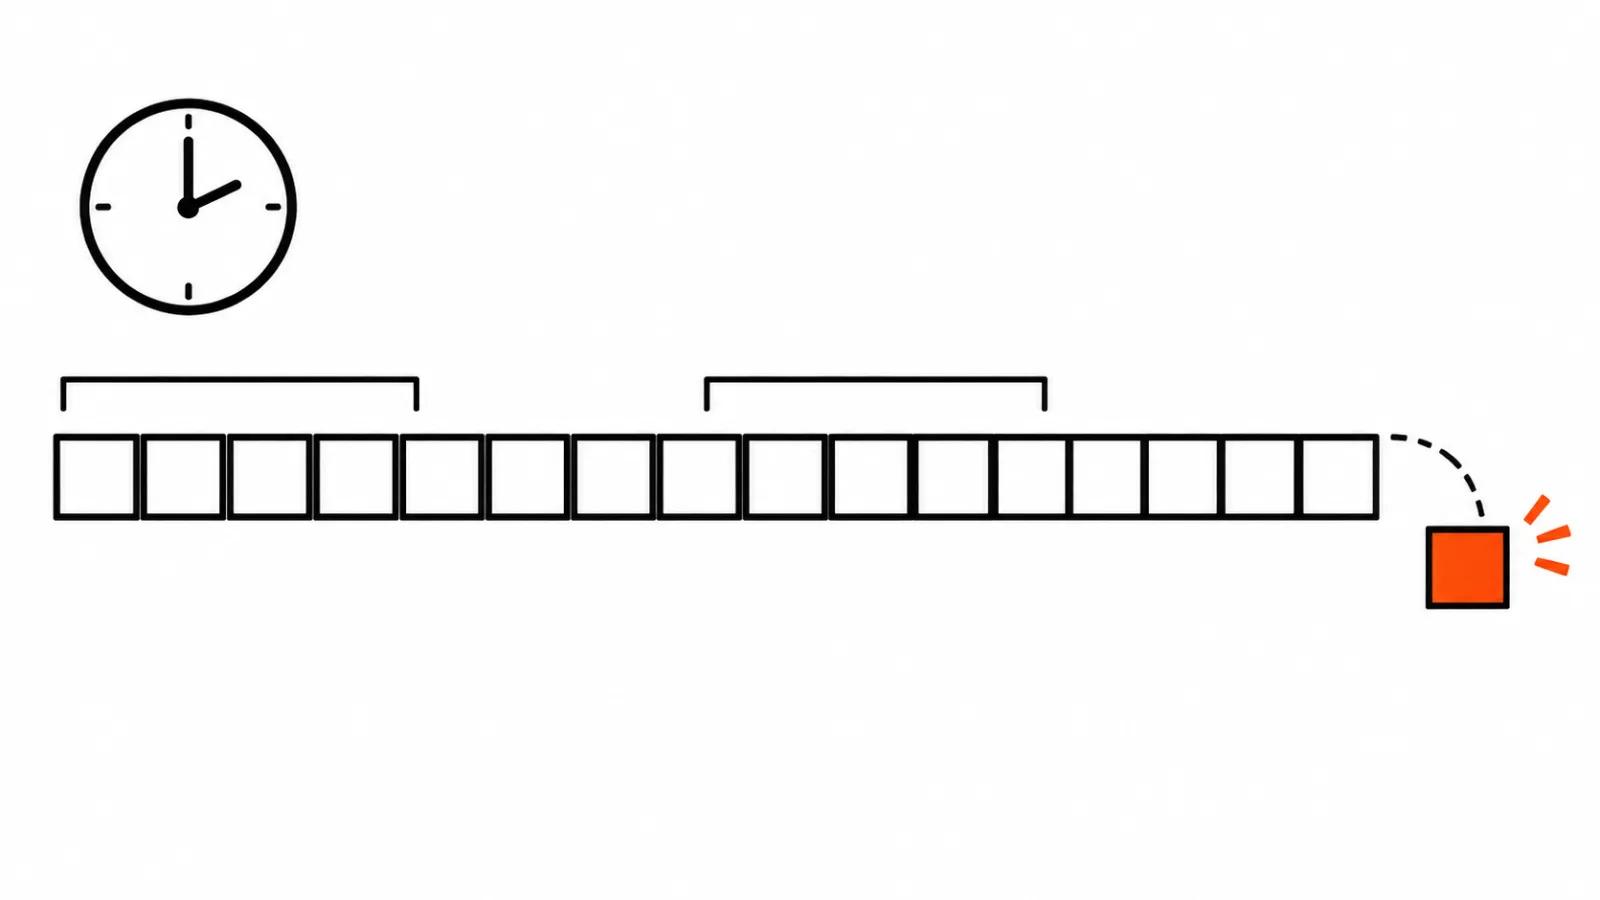
Передовые модели работают в латенте VAE. Автоэнкодер это компрессор: он сжимает картинку по пространству, а со временем научился сжимать и по времени. Сначала на кадр приходился один латент. Потом 3D VAE стали сливать несколько кадров в один латент, и такой латент уже не соответствует ни одному отдельному кадру. Учить модель так проще, потому что токенов меньше.
У этой схемы три счёта. Удвоение разрешения учетверяет число токенов. Условия из промта применяются к группе кадров, и отдельный кадр не получает свою поправку. А в интерактивном режиме каждый ответ ждёт, пока досчитается весь его блок из нескольких кадров. Про конвейер со шумом и шагами у нас есть разбор, как работает генератор видео, а здесь важен размер шага.
Как работает нейросеть видео, когда кадр идёт за кадром
Группа из Roblox, UC Merced, UPenn и UT Austin 12 ноября выложила статью «Back to Pixels: Lifting Latent Video Diffusion into Pixel Space» (arXiv 2611.17336) и модель PixVid. Её дообучили из Wan2.1-14B на примерно 1,3 млн клипов так, чтобы каждый кадр рождался сразу в пикселях. В таком режиме модель реагирует на действие уже в следующем кадре. Латентная модель отвечает только в следующем блоке, то есть с задержкой в несколько кадров.
Латент от этого хуже не стал, он дешевле обучается. Работа показывает другое: при покадровой генерации в пикселях модель выдаёт вдвое большее разрешение при том же числе токенов на кадр, точнее держит правку по карте глубины на быстром движении и отвечает на действие в следующем кадре. Для обычного ролика по промпту это почти неважно, для интерактива (игры, камера под управлением в реальном времени) это главное.
Как работают нейросети с видео в реальном времени
inclusionAI Duo v1 (GitHub inclusionAI/Duo, 13 ноября) генерирует видео и звук ответа кусками на общей временной шкале. Маски внимания держат причинность: модель не видит будущих входов, у неё есть прошлое и собственные уже сгенерированные кадры. Отдельная модель Intent решает, когда пора говорить. По пересказу AI Weekly куски выходят по 0,71 с.
lucidml/gta на Hugging Face (Apache-2.0, 11-12 ноября) идёт в сторону игр. У неё 630 млн параметров, архитектура Summaryformer, кадры генерируются по одному по нажатию WASD. Для монтажа такой интерфейс непривычен, зато видно, как выглядит генерация в реальном времени без очереди из блоков.
Память: почему старые кадры приходится сжимать
Модель, которая рисует кадр за кадром, быстро упирается в память. В gta каждый кадр хранится в двух видах. Сырой латент из 1008 токенов нужен для ближайшего движения, а 96 итоговых токенов держат дальний контекст, и старые кадры сжимаются в итоговые. Окно памяти доходит до 24 латентных кадров, это 96 обычных кадров, значит один латент покрывает четыре кадра. Бюджет внимания при таком сжатии 6528 ключей, при полной истории было бы 26 208.
Здесь видна общая логика живых моделей: подробно помнить последние секунды и коротко всё, что было раньше.
Откуда дрейф и что с ним делают
Если модель всегда видит только прошлое и свои же прошлые кадры, ошибки накапливаются. Лицо уезжает, рука меняет форму, надпись теряет буквы. Это тот же дрейф, который ловят в обычных моделях, только здесь у него есть архитектурная причина. Duo борется с ним двойной дистилляцией на собственных прогонах: модель учат на историях, которые она сгенерировала сама, и по README это часть рецепта. Насколько приём держит длинную сцену, по описанию не понять, нужны прогоны.
Гибрид: сжатое движение и пиксельные детали
В LTX-2.5, судя по блогу ComfyUI, движение, композиция и кадрирование генерируются в латенте, сжатом по времени в 8 раз, плюс набор ключевых кадров высокого качества. Дальше отдельная стадия пиксельной диффузии дорисовывает видео. Вместо обычного декодера VAE в этой версии стоит диффузионный декодер видео. Логика простая: дешёвые решения принимаются на сжатом уровне, дорогие детали добавляются там, где их видно.
Что это значит для заказа и для монтажа
Для заказчика разница видна в двух местах. Первое: задержка. Потоковая модель на блоках реагирует на команду только со следующим блоком, покадровая уже в следующем кадре. Второе: управляемость внутри клипа. Обычный генератор считает ролик целиком, перебить его на середине нельзя, правка означает новый прогон. Живые модели позволяют вести сцену как игру, зато каждая ошибка тянется дальше.
Для рекламы с точным действием по секундам видео нейросетями разумно собирать в несколько проходов и оставлять монтаж человеку. Если в ролике работает говорящий ИИ-аватар, логика та же: сначала проверить, как модель держит лицо на коротком куске, потом раскатывать на весь ролик. Про якорный кадр и первый шаг есть отдельный разбор, как картинка превращается в видео.