Что модель получает на входе
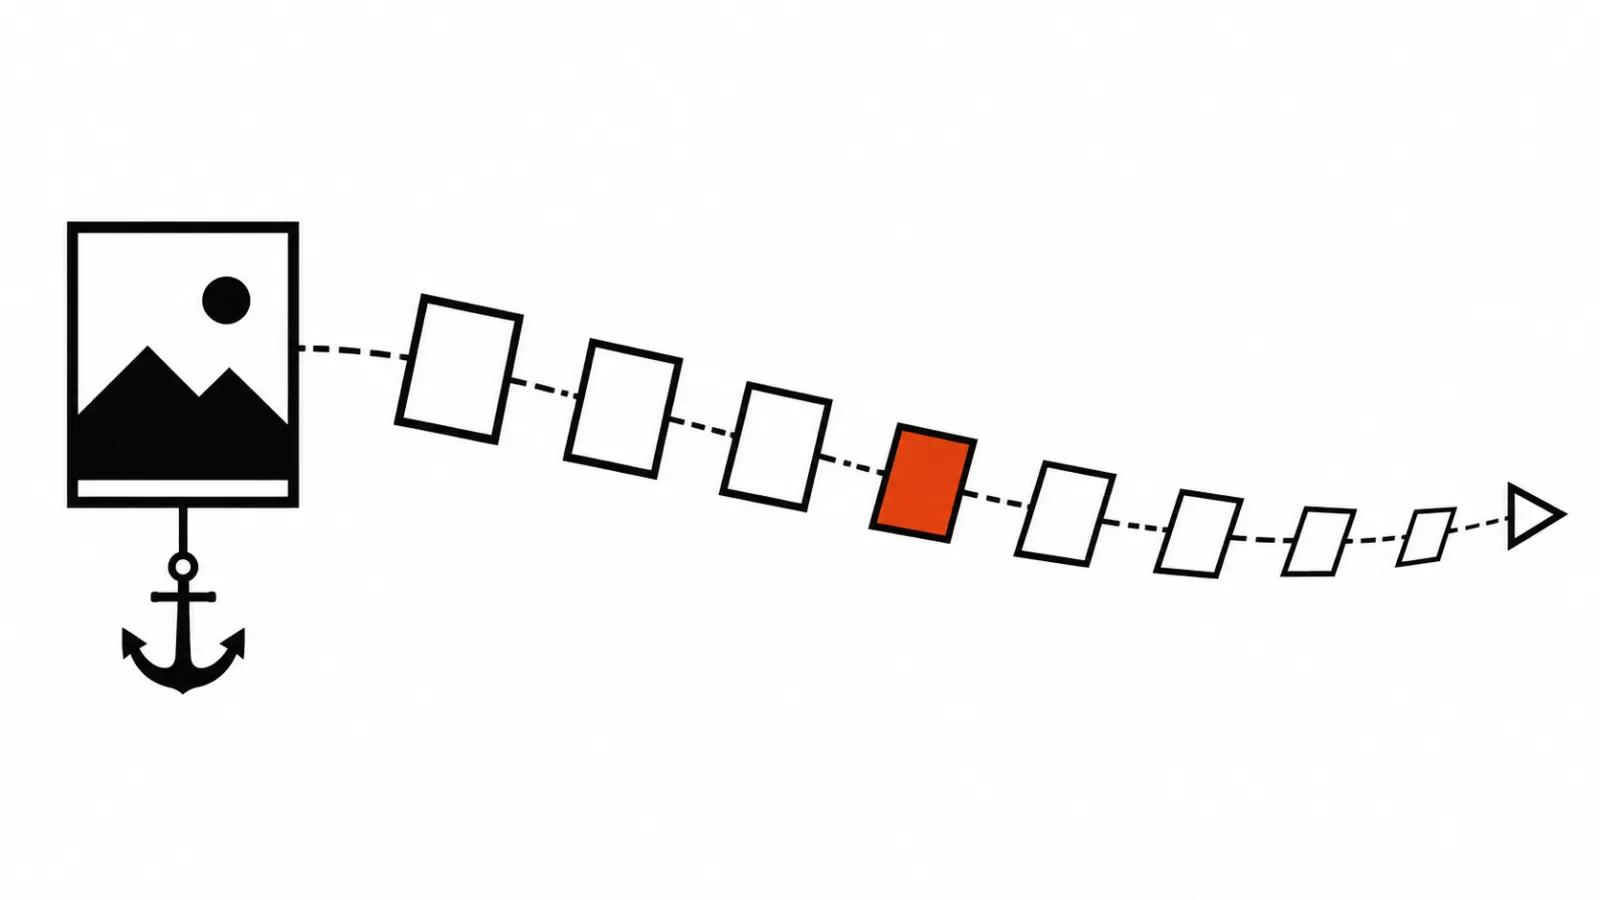
Картинка в режиме картинка-в-видео работает как условие всей сцены. Runway в официальном гайде Gen-4 Video Prompting Guide пишет прямо: входное изображение задаёт визуальную стартовую точку всего процесса, включая субъектов, композицию, цвета, свет и стиль. Дальше модель достраивает движение, опираясь на это условие.
Простой образ: картинка это якорь, к которому модель привязана в начале, текст это направление, куда её тянуть. Чем дальше от якоря, тем больше модель придумывает сама.
Два термина, которые дальше пригодятся. Якорный кадр это опорное изображение, с которого начинается генерация. Латент это сжатое представление кадров, с которым модель работает внутри и которое разворачивается в пиксели только на выходе.
Что генератор видео оживить фото берёт из картинки
Из фото модель берёт внешность героя, расстановку предметов, палитру, направление света и фактуру. Всё это считается уже заданным, поэтому Runway советует описывать в тексте движение. Гайд добавляет деталь, которую заказчики не любят слышать: подробный повтор деталей изображения в тексте может уменьшить движение. Чем старательнее вы перечисляете, во что одет герой, тем меньше он шевелится.
Runway считает картинку и текст одним общим промптом. Отсюда рабочее разделение: фото отвечает за то, как выглядит кадр, текст за то, что в кадре происходит. Если в промпте два абзаца про внешность и полстроки про действие, движение получится вялым.
Как это устроено внутри: сжатые кадры вместо пикселей
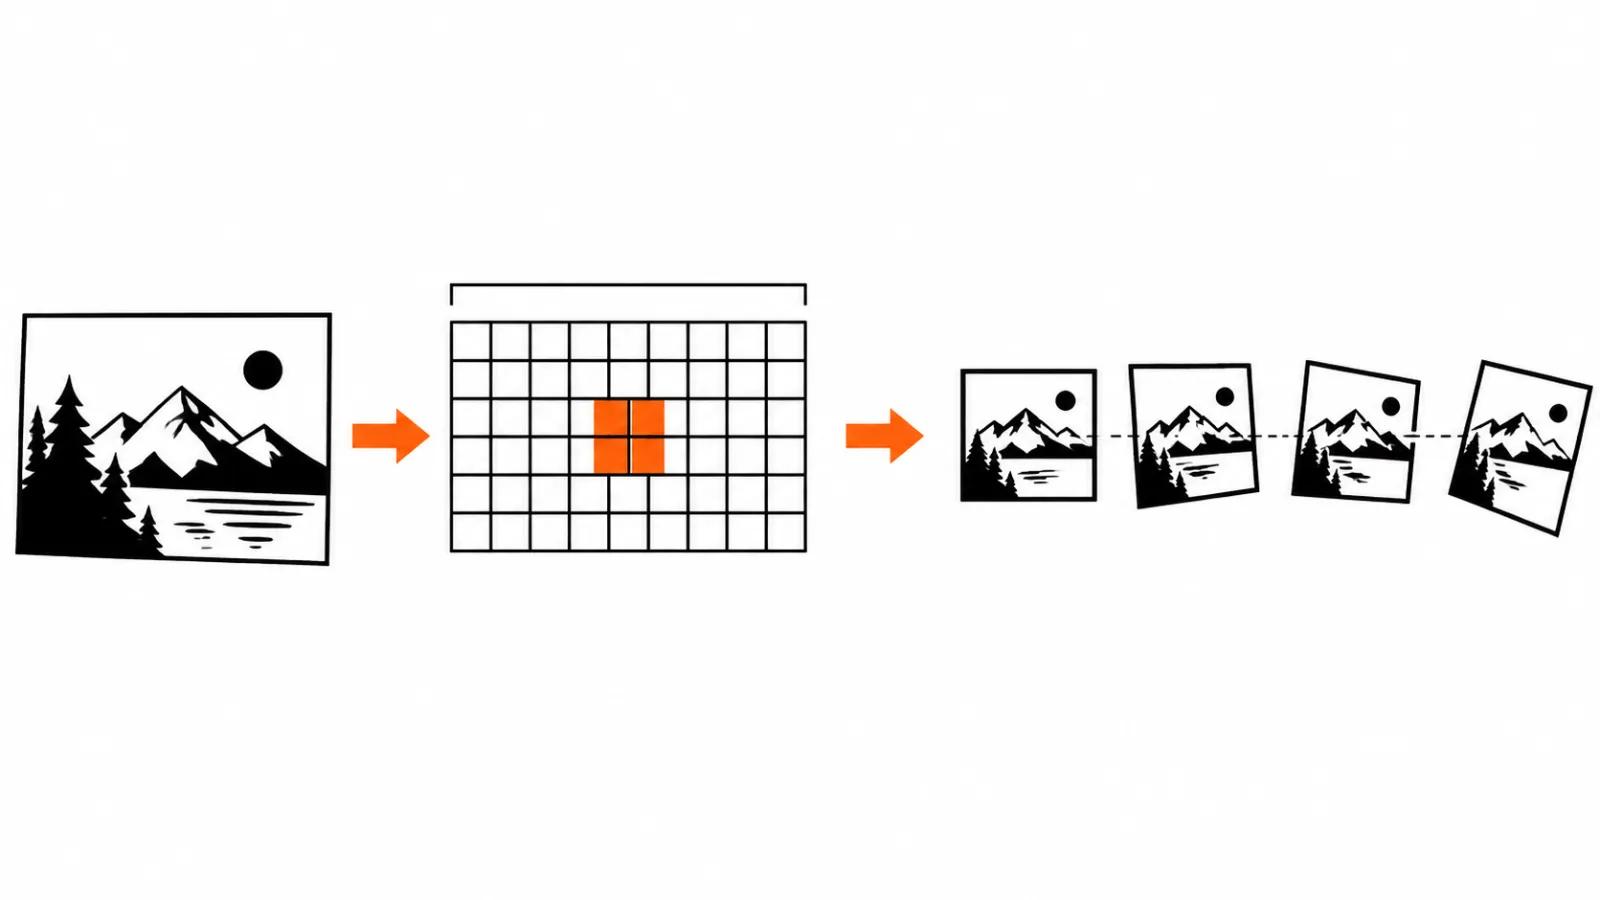
Открытая модель Vimoo 1.0 (документация и карточка по пересказу llms.blog от 9 ноября 2026) показывает схему, которая встречается и у других. Картинку кодирует отдельный кодировщик изображений SigLIP, видео сжимается и восстанавливается автокодировщиком Wan 2.2 VAE. Простыми словами: модель не рисует миллионы пикселей кадр за кадром, она работает со сжатым представлением, тем самым латентом, а полные кадры появляются на выходе. Модель думает конспектом.
Из этого следует практическая вещь. Мелкая деталь, которая плохо попала в конспект, может появиться не сразу или измениться по ходу ролика. На стоп-кадре этого не видно, на движении видно.
Почему первый кадр может не совпасть с картинкой
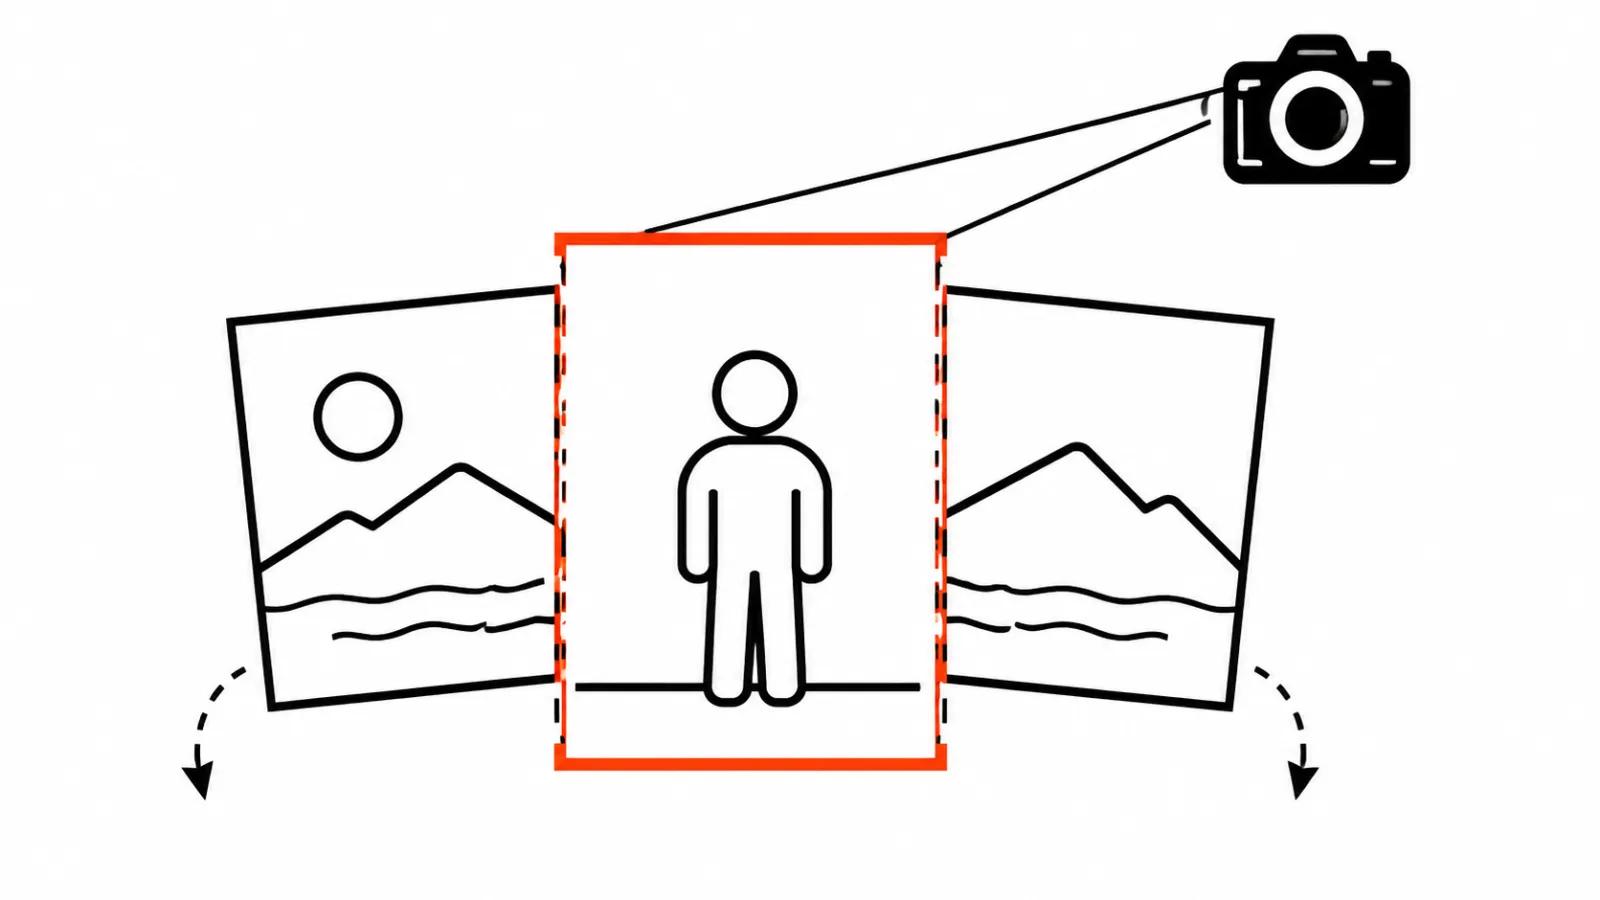
Документация Vimoo 1.0 называет две причины. Картинка масштабируется и обрезается по центру под формат ролика. Первый кадр не обязательно совпадает с ней пиксель в пиксель. Если фото горизонтальное, а ролик вертикальный, края уйдут, и герой окажется ближе к границе, чем на исходнике.
Отсюда практический совет: мелкие детали вроде принта на футболке, украшения или надписи на упаковке проверять в первом кадре отдельно, расхождение на них видно сильнее всего.
Держать ролик можно не только первым кадром. Гайд Google Gemini Omni описывает режим, где задают первый и последний кадр, а модель строит непрерывное видео между ними. В таком сценарии надо описать, что в первом кадре, какой путь проходит камера и что в последнем. Открытая Pika H3 Flex в Diffusers 0.43, по карточке от 12 ноября 2026, поддерживает первый и последний кадр по отдельности и вместе, плюс мультимодальные референсы. Устройство у моделей разное, поэтому проверять приходится на своём материале.
Почему длинный ролик уплывает
Во многих схемах модель держит недавние кадры подробнее, чем ранние. Показательный пример из мира моделей мира: lucidml выложила на Hugging Face world model по GTA (11-12 ноября 2026, пересказ ArtRealmAI), где стартовая картинка хранится в памяти всё время и никогда не вытесняется, последние два кадра держатся в полном разрешении, а старые остаются сжатыми конспектами. На длинных сессиях картинка всё равно уплывает.
Отсюда понятно, зачем нужны якоря и короткие куски. Kandinsky S2V 1.0 в Diffusers 0.43 оживляет человека по картинке и записи речи, генерирует кусками по 5 секунд и передаёт память между кусками через FramePack. Чем короче отрезок между опорными кадрами, тем меньше свободы у дрейфа. На длинном ролике без промежуточных опор ошибка накапливается, и первыми это выдают лицо, руки и фон.
Какую картинку давать
Формат. Картинка должна быть в пропорции ролика. Для вертикали это 9:16, иначе кроп по центру срежет края и сдвинет композицию.
Края. Субъект не у самого края кадра. При обрезке и движении камеры он уйдёт первым.
Чистота. Без артефактов на исходнике. Мелкий текст, лишние пальцы и размытые детали модель принимает за часть сцены и повторяет.
Один центр. Если в кадре три равных героя, модель может начать двигать всех, и внимание зрителя размажется.
Что писать в тексте
Текст отвечает за движение: что делает герой, как едет камера, что меняется в сцене. Одна мысль на шот. Описание внешности лучше не дублировать, модель получила её с картинки.
Последний кадр нужен, когда у ролика есть финальная точка: товар лёг в руку, герой повернулся к витрине, машина встала у подъезда. Тогда его готовят и описывают отдельно, как и первый. Если финала нет, хватает движения и одного якоря.
По этой схеме собирается серия: видео нейросетями делается потоком, где у каждого ролика свой якорный кадр и свой короткий текст про движение. Когда нужен один аккуратный ролик под конкретную задачу, это ручные ролики, там кадр доводит человек. Общий порядок генерации, от текста до готового файла, я разбирал в статье как работает генератор видео по шагам. Про управление опорными точками есть отдельный материал первый и последний кадр в ИИ-видео.
Мой вывод
Модель не оживляет фотографию в бытовом смысле. Она достраивает сцену от картинки, держит её как опору и постепенно теряет. Практика из этого простая: короткие отрезки, проверка первого кадра на совпадение с исходником, последний кадр там, где важен финал.
Если после первого прохода герой не похож на фото, я правлю вход и оставляю текст в покое. Другой кадр, другая пропорция, другой момент. Текст правит движение, внешность приходит из картинки.