Зачем нужен второй кадр
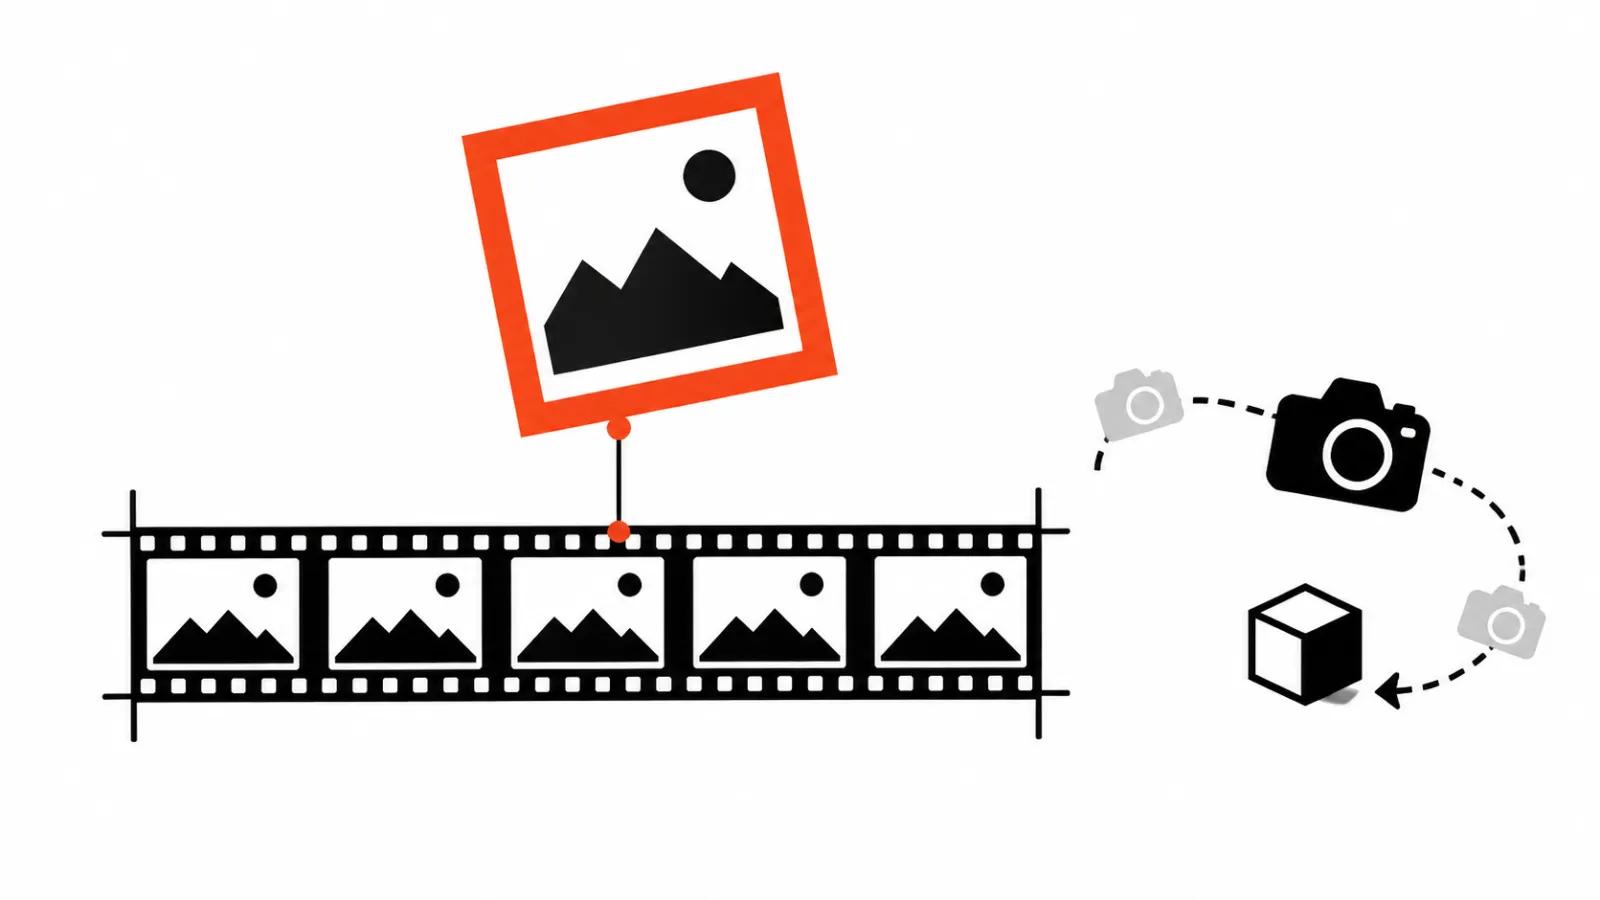
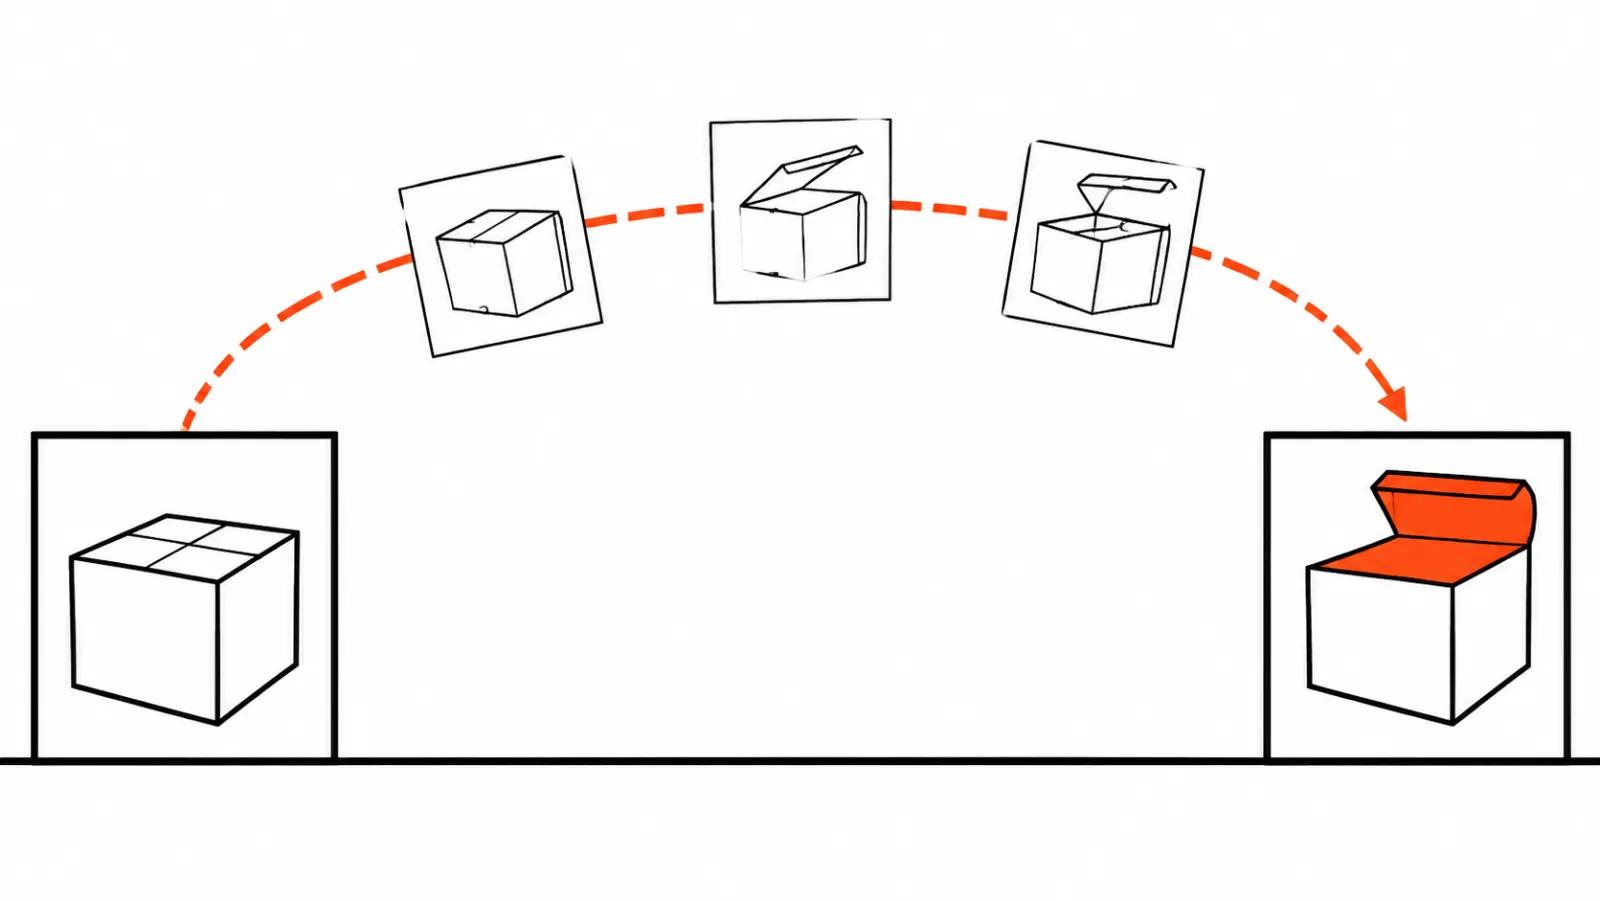
Одно фото оставляет модели слишком много свободы. Она сама решает, куда поедет камера, как повернётся предмет, что появится на заднем плане. С двумя кадрами задача сужается: есть начальная композиция и конечная, между ними нужно провести движение. Режим называется first frame и last frame, и в работе с товаром он самый предсказуемый.
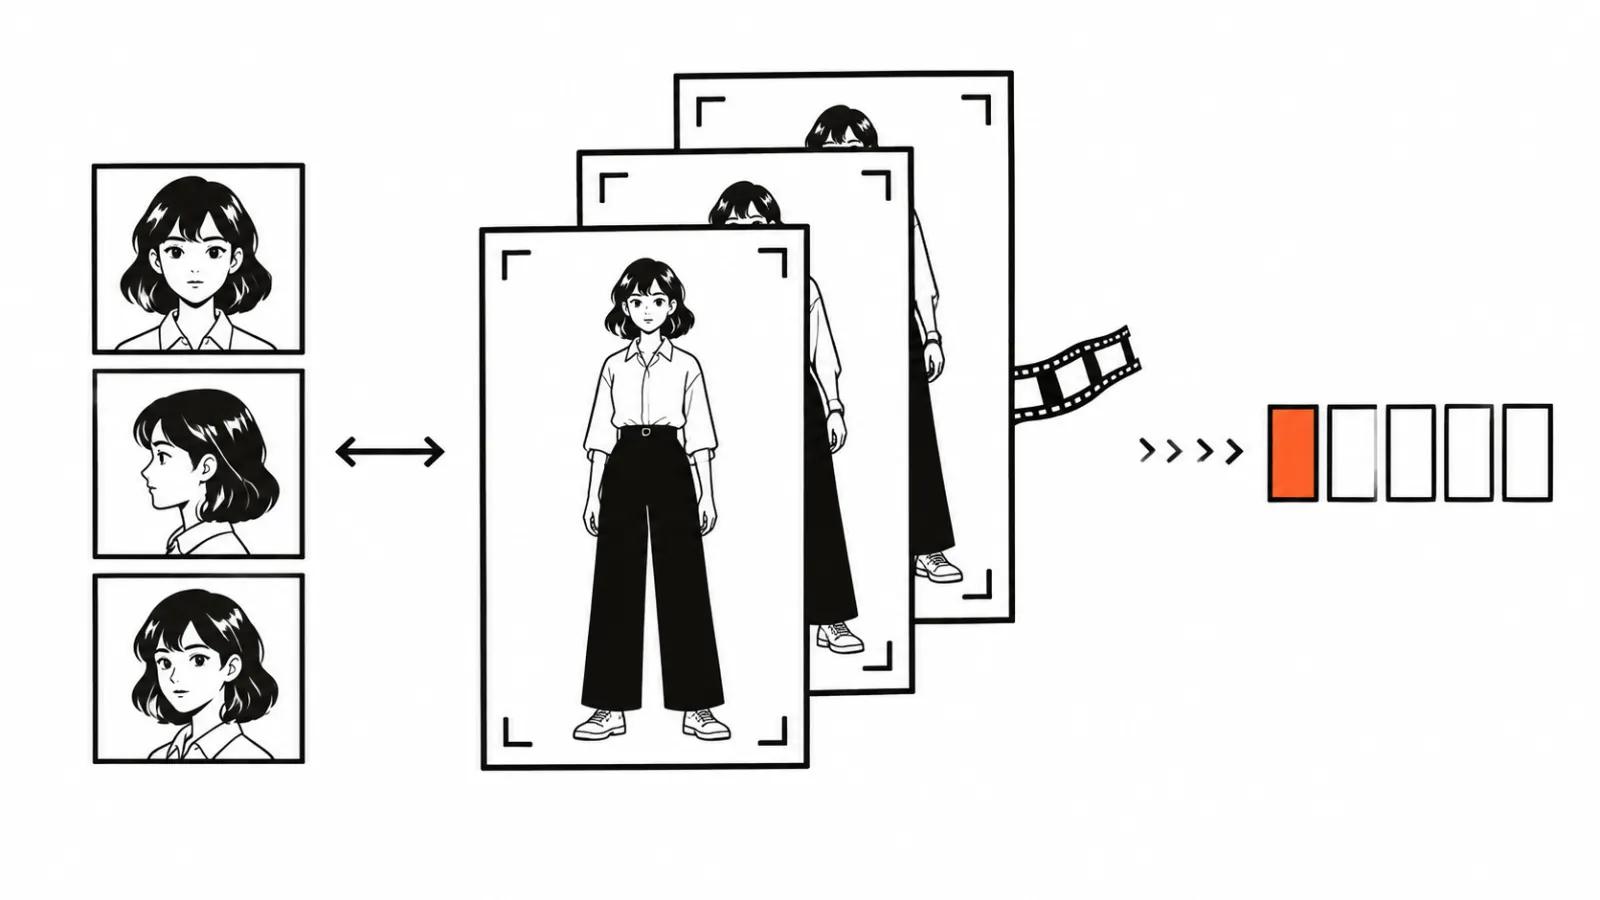
Сценарии, где он окупается сразу, повторяются из проекта в проект. Product reveal, когда в первом кадре коробка закрыта, а в последнем открыта. Проход через дверь, где старт это улица, а финал интерьер. До и после в одной композиции. Повороты в примерке одежды, где герой должен вернуться в ту же позу, из которой начал.
Во всех случаях модель решает узкую задачу. Ей не нужно придумывать ролик с нуля, она дотягивает одну картинку до другой. Чем меньше свободы, тем меньше сюрпризов на выходе, и это главный аргумент за вторую картинку.
Генерация видео по картинке нейросетью: как это работает
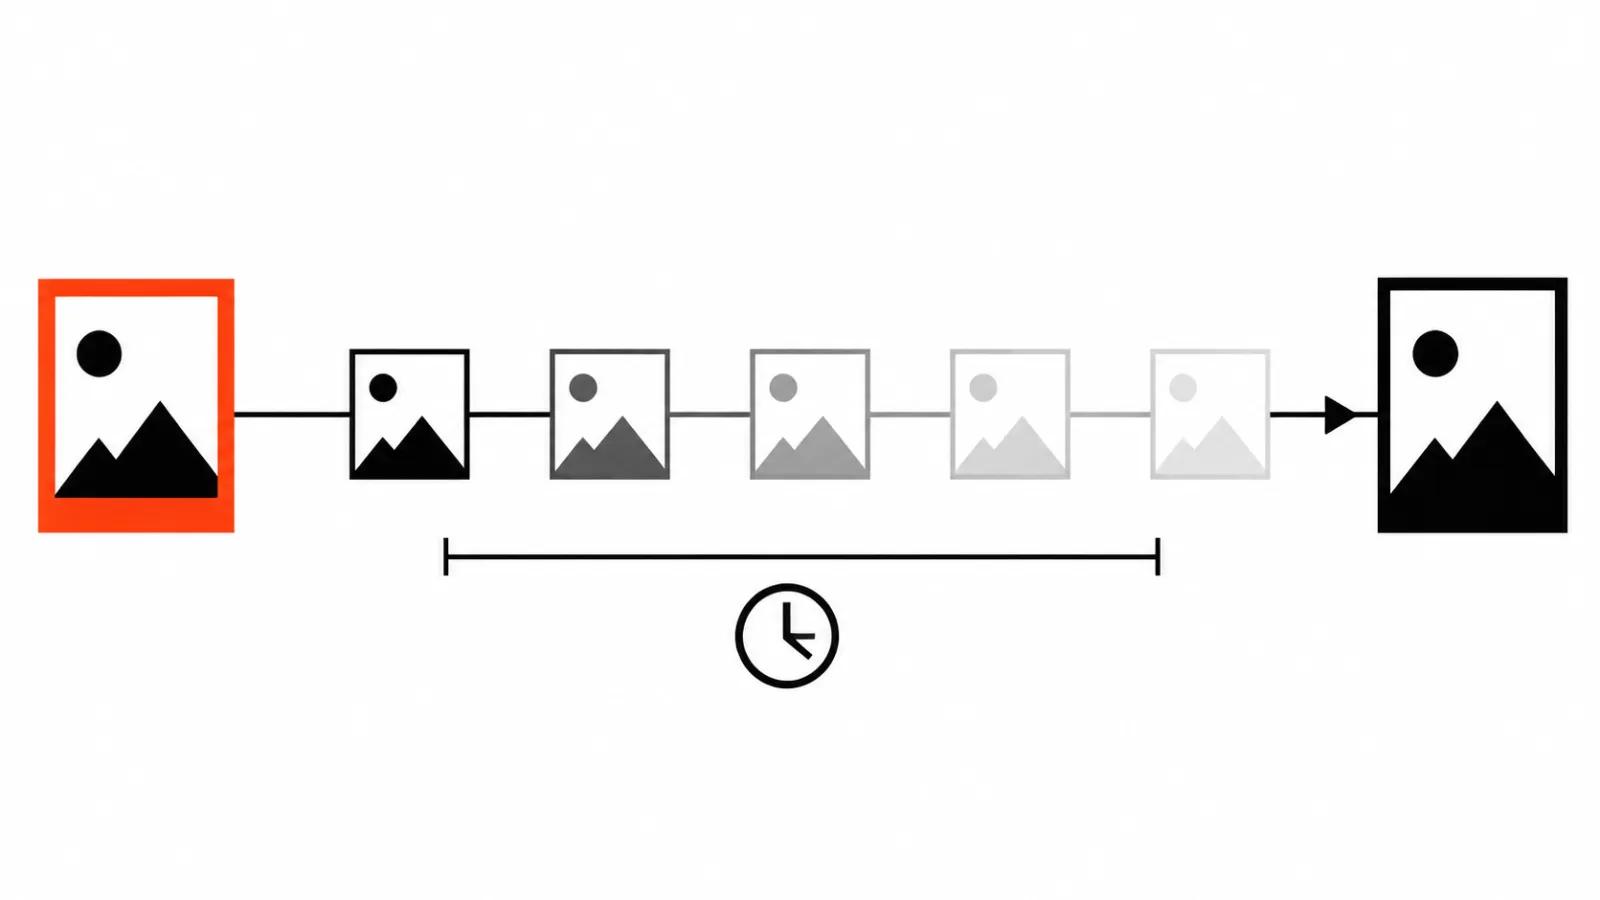
Схема простая. На входе две картинки и промпт, на выходе ролик, в котором первый кадр совпадает с первой картинкой, а последний со второй. Между ними модель строит промежуточные кадры. Качество перехода зависит от того, насколько две картинки согласованы между собой, и это единственное, что вы контролируете до генерации.
По свежим демо Gemini Omni 1.2 Flash от Google видно, что согласованность первого и последнего кадра стала плотнее, чем у прошлых версий. По заметкам API у части провайдеров путь с last frame у этой модели ограничен 3-10 секундами, тогда как обычный text-to-video уходит до 15 секунд. Короткий отрезок здесь не минус. На длинном переходе модель успевает насочинять больше, и это заметно на руках и мелком тексте.
Как создать видео из фото нейросетью: порядок из пяти шагов
Шаг первый: подготовить два кадра. Один фокус, одно освещение, один ракурс сцены. Если на первом кадре свет из окна, а на втором из лампы, переход будет читаться как склейка двух съёмок, и никакой промпт это не вылечит.
Шаг второй: выбрать длительность. Рабочий диапазон 3-10 секунд, начинать лучше с нижней границы. Три секунды дают чистый переход и почти не оставляют модели места для импровизации. Длину всегда можно нарастить позже, а вот вырезать лишнее движение из готового клипа не получится.
Шаг третий: написать промпт. Он описывает движение и только его. Камера медленно наезжает, крышка поднимается, свет остаётся прежним. Если начать переписывать объект, модель примется менять его форму и цвет, и последний кадр разойдётся с картинкой, которую вы дали.
Шаг четвёртый: проверить на 100% zoom. Смотреть руки, лицо и логотип. Пальцы и мелкий текст это первые места, где появляется морфинг, и в окне предпросмотра его не видно.
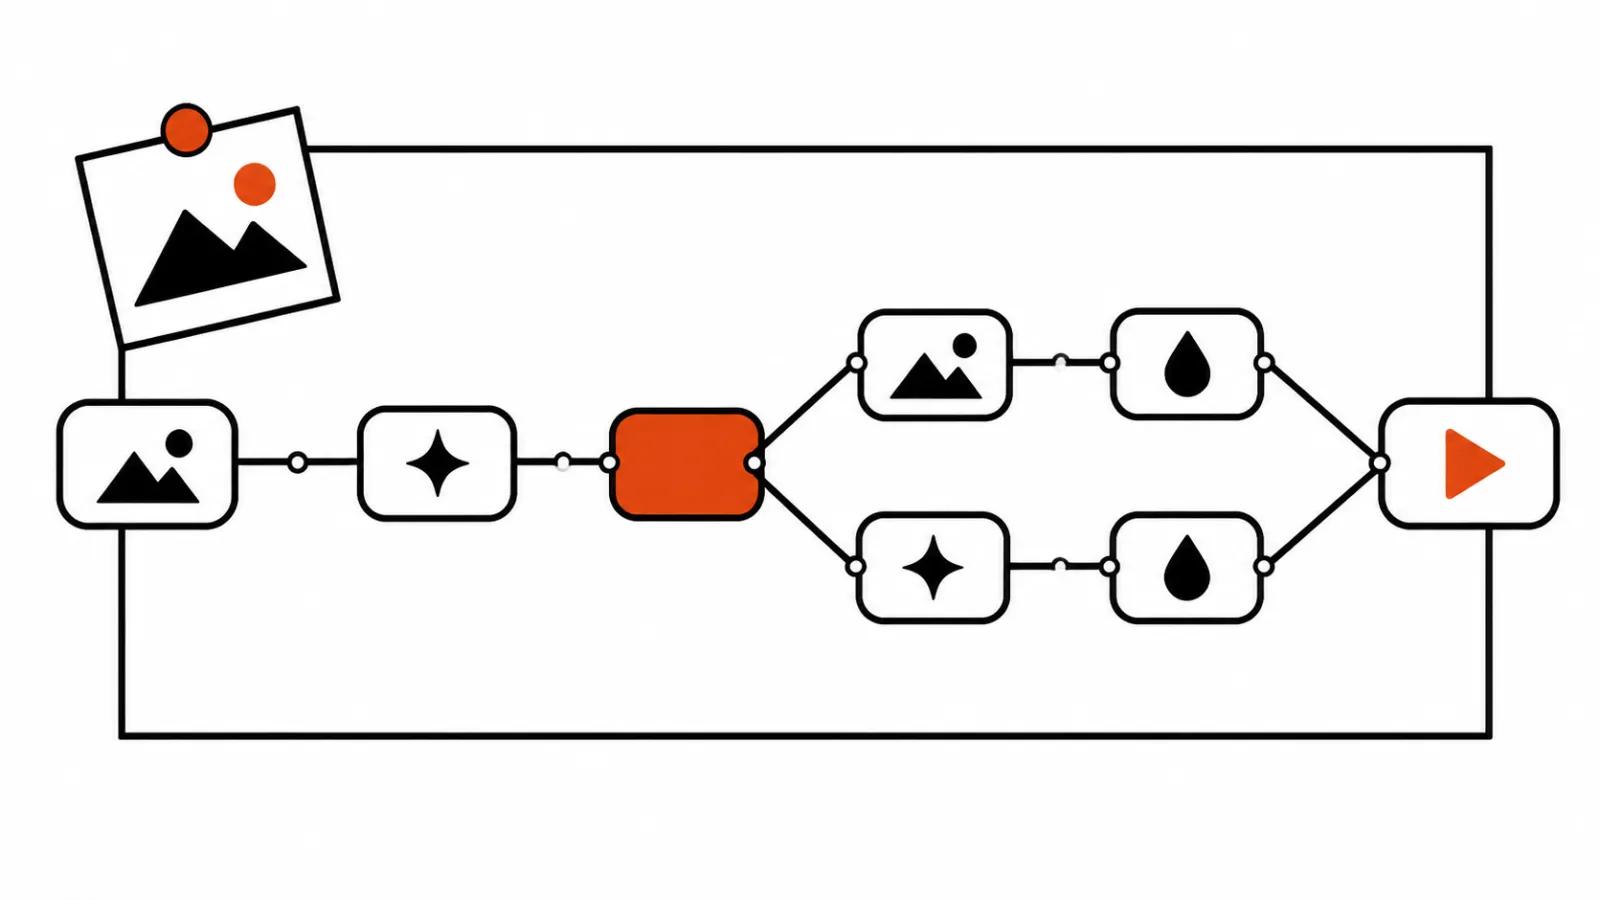
Шаг пятый: разобраться с провалом. Способов два. Укоротить клип вдвое или добавить промежуточный кадр, если инструмент поддерживает middle keyframe. Kling через Felo такой кадр принимает, и лишняя точка в середине часто спасает переход, который не собирался.
Видео по картинке нейросетью: где переход ломается
Первое место это разный масштаб. Две картинки, снятые с разного расстояния, дают зум, которого вы не просили. Камера начинает приближаться, хотя в задаче был поворот, и композиция финала приезжает крупнее задуманного.
Второе это мелкая геометрия. Пальцы, ремешок, тонкая оправа очков. Модель считает такие детали приблизительно, и на движении они плывут. Проверять надо именно те участки, где объект меняет угол.
Третье это текстуры с рисунком. Логотип, надпись, полоска на упаковке. К концу перехода буквы съезжают и вытягиваются, а заметно это только в полном масштабе. Если в кадре есть брендированный элемент, финальный кадр лучше делать отдельной картинкой с уже правильным логотипом.
Четвёртое это прозрачные и блестящие поверхности. Стекло, фольга, жидкость. Здесь физика перехода остаётся на совести модели, и обещать клиенту честное отражение я не стану.
Инструменты: три класса
Первый класс это image-to-video с явными first и last: Gemini Omni, Kling, а также Seedance и Wan в агрегаторах, где режим вынесен в отдельное поле. Второй класс это keyframe-подход в духе Pika, где кадры задаются последовательно и переход собирается из нескольких опорных точек. Третий класс это чистое text-to-video без контроля кадров, и там последний кадр придётся досочинять промптом.
Выбирать стоит по задаче. Для товара и упаковки нужен первый класс, потому что финал задаётся картинкой. Для движения персонажа в кадре часто хватает keyframe. Общий базовый разбор фото-в-видео у нас уже есть, если нужен контекст по моделям и первым шагам. Здесь речь про узкий инструмент управления, и есть он не у всех.
Вертикальная реклама: финал фиксирую кадром
Мой рабочий приём простой. Финальный packshot я делаю отдельной картинкой и ставлю его последним кадром. Промпт при этом описывает только подъезд камеры. Так упаковка приходит в кадр в том виде, в котором её согласовал клиент. Модель не трогает финал, она отвечает только за путь до него.
На серии версий это экономит больше всего. Один и тот же финал держит единство серии, меняется только вход: другой ракурс, другой свет, другой персонаж. Два кадра вместо надежды на текст экономят примерно три регена, когда камера уехала не туда. По опыту это самая частая статья переделок в вертикальных роликах.
Для рекламных серий приём встроен в вертикальную рекламу, где версии собираются пачкой под площадки. Когда нужен полный контроль над каждым кадром и съёмка с человеком на площадке, есть видео нейросетями как общий формат и ручные ролики для проектов, где за кадр отвечает оператор.
Мой вывод
Первый и последний кадр это самый дешёвый способ поставить модели рамки. Он не делает физику честной, стекло всё равно может повести себя странно, и идеальный проход через дверь я клиенту не обещаю.
Практика у меня такая. Три секунды, две согласованные картинки, промпт про движение, проверка на полном масштабе. Если переход поплыл, сначала укорачиваю, потом добавляю средний кадр, и только после этого меняю инструмент. Такой порядок дешевле, чем перебирать модели наугад.