Как работает генератор видео: от ряби до картинки
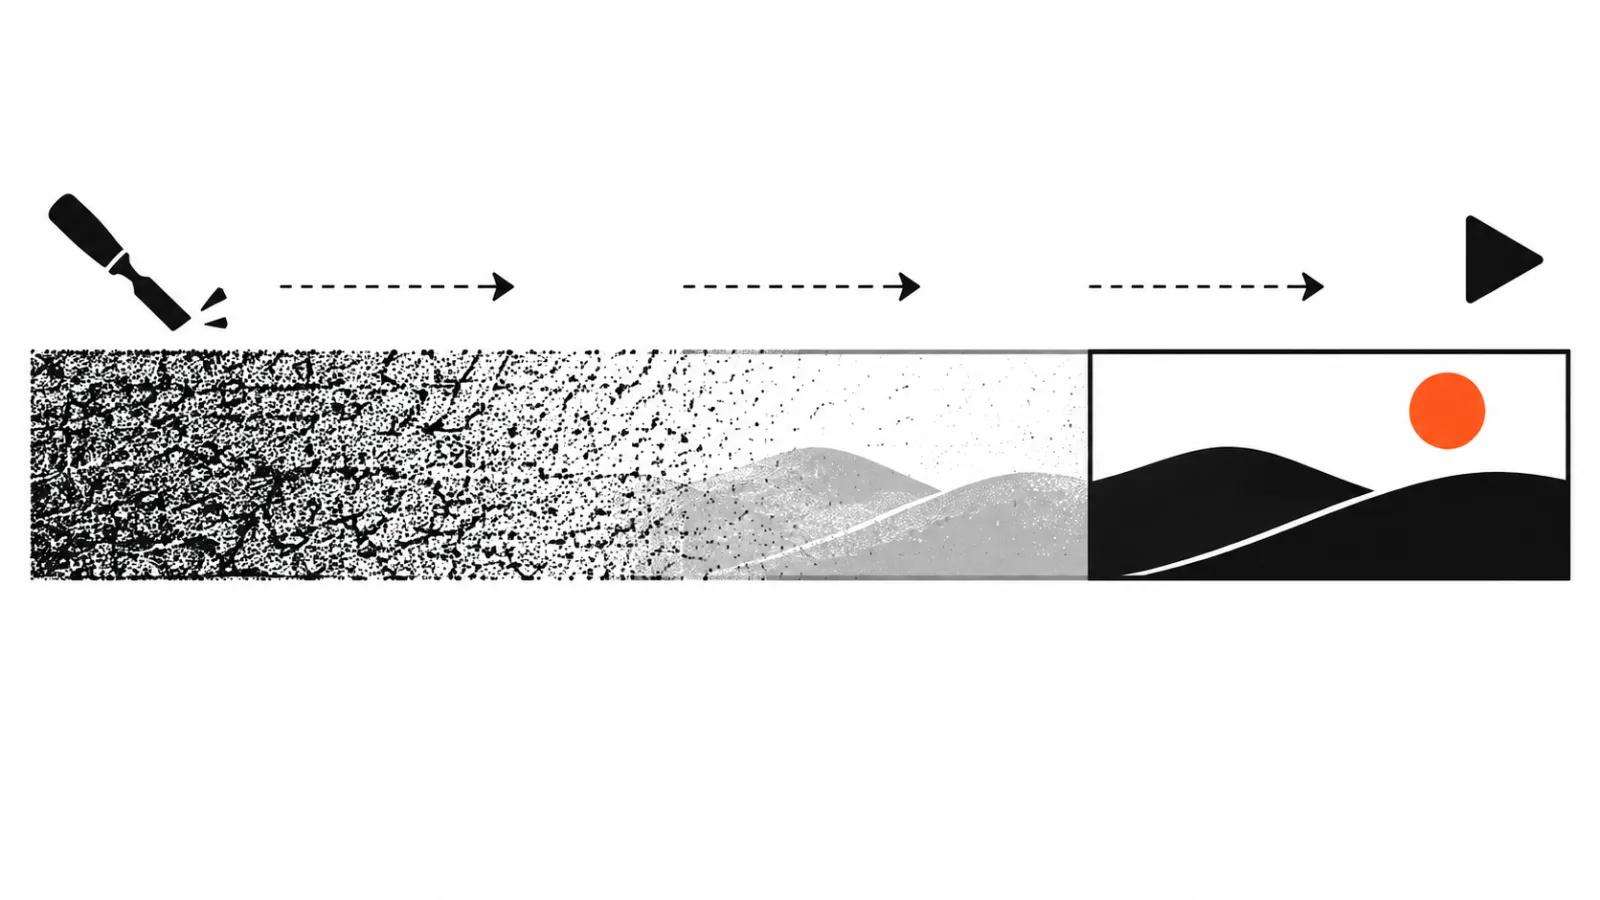
Генератор видео начинает с шума. Представьте рябь на старом телевизоре, только в цвете и в движении: на входе у модели нет ни одного узнаваемого предмета. Дальше она за несколько шагов убирает шум, и на каждом шаге картинка становится ближе к тому, что написано в промпте. Шаг это один проход модели, после которого видео чуть чище. Никакой склейки из готовых кадров не происходит, клип рождается прямо из этой ряби.
Аналогия простая. Скульптор снимает лишнее с блока камня, модель снимает лишнее с шума. Разница в том, что скульптор видит свою работу, а модель на каждом шаге сверяется с текстом промпта и с тем, что у неё уже получилось.
Почему работа идёт в сжатом виде
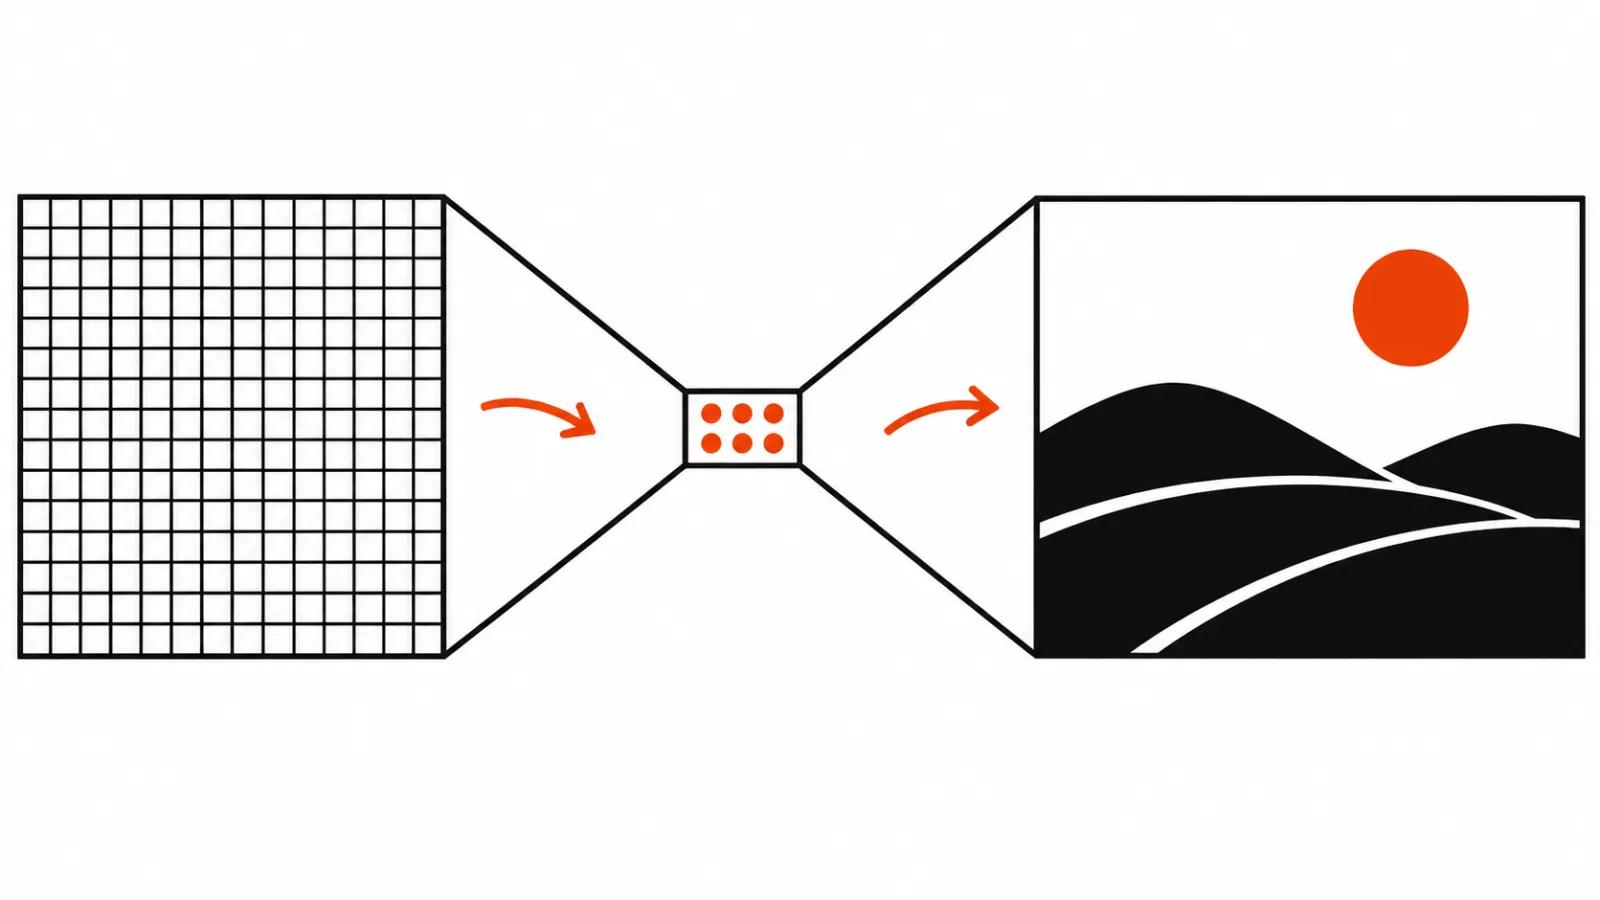
Модель считает не в пикселях, ей так слишком дорого. Работа идёт в латенте, это короткое описание видео, из которого потом разворачивают картинку. Разворачивает отдельная сеть, декодер, чаще всего варианта VAE.
Насколько сильно сжатие, видно по цифрам из реальной модели. У MiniMax H3 один токен покрывает 4 кадра по 32×32 пикселя, такие данные приводит команда pi-H3 в блоге от 10 ноября 2026. Токен здесь единица описания, примерно как один символ в тексте. Кадр целиком в такое описание не помещается, помещается его общее содержание.
Отсюда первое практическое следствие. Мелкие детали страдают первыми: текст, пальцы, черты лица в общем плане. Им достаётся очень мало места в сжатом описании, и внимания от модели они получают меньше всего. Это одна из причин, почему в ИИ-видео плывут надписи и руки, других причин тоже хватает.
Как создают ИИ видео: клип целиком, без сборки из кадров
Кадры в готовом клипе согласованы между собой, и причина в том, как модель считает. Она генерирует весь клип сразу как один объём, все кадры вместе, поэтому движение получается непрерывным по построению. При подходе кадр за кадром, где следующий кадр дорисовывают по предыдущему, ошибка может копиться и к концу сцены расходиться.
Это общий принцип современных видеомоделей. Как именно каждая из них устраивает память между кадрами, зависит от модели.
Что решает каждый шаг
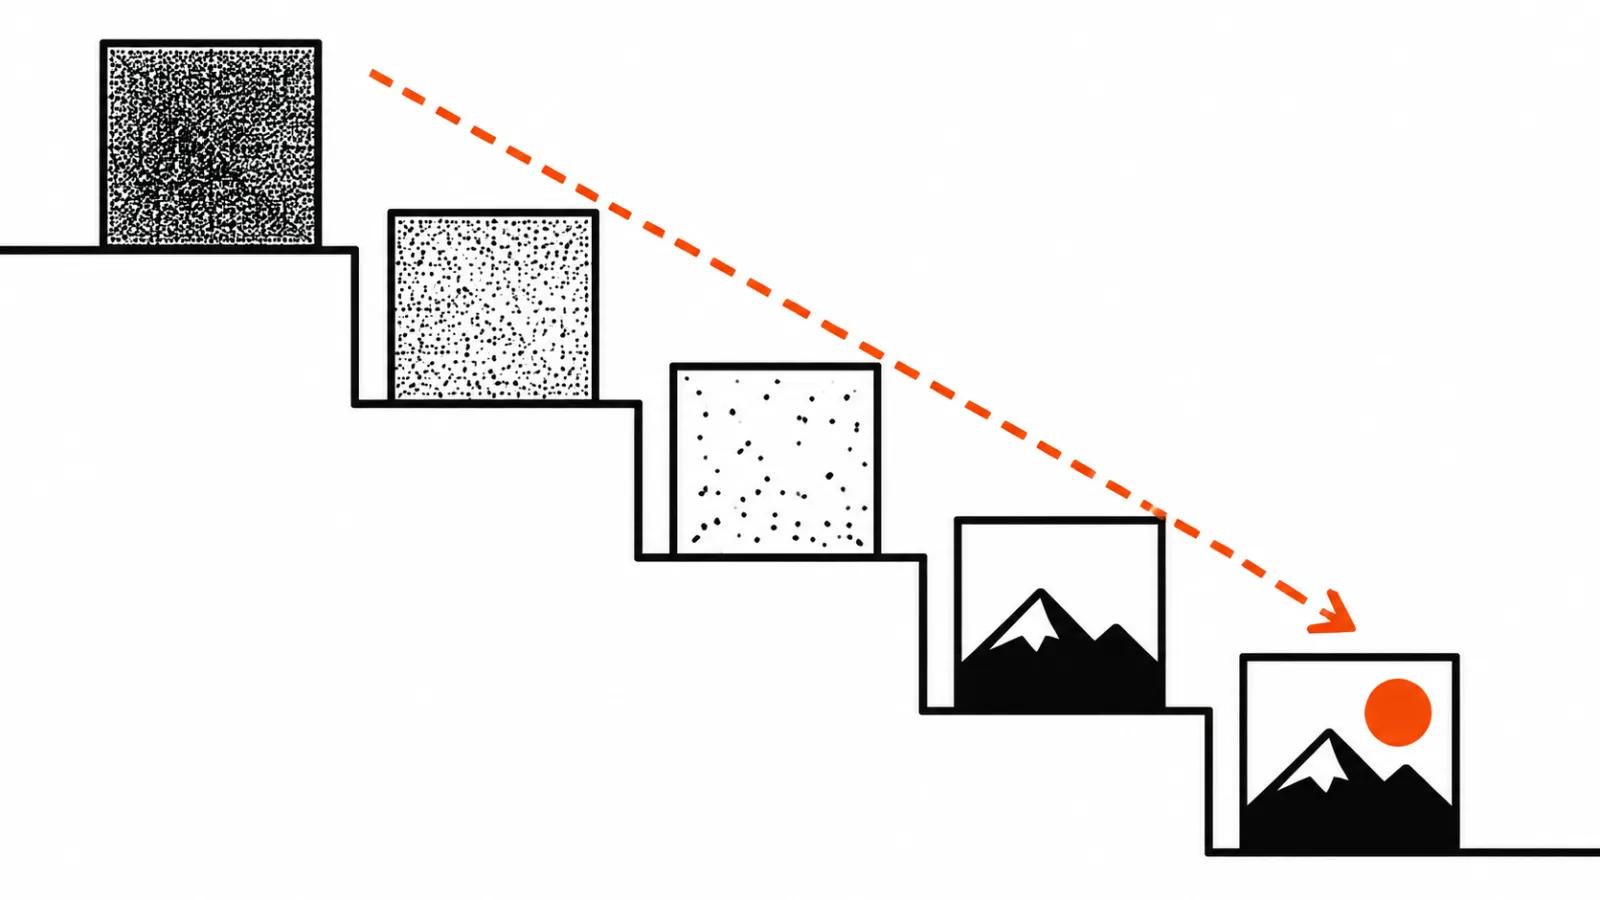
У шагов разная работа. Первый задаёт композицию и движение: где стоит герой, куда едет камера, что вообще происходит в кадре. Последние доводят детали: кожу, ткань, мелкие предметы. Обычно внутри диффузии работа распределяется именно так.
Наглядно это видно по лестнице шума из карточки HyperFlow, где на 4 шага приходится такой ряд уровней шума: 1 → 0,68 → 0,21 → 0,04 → 0. Единица это чистый шум, ноль это готовое видео. Уровень шума падает с 1 до 0,68 и сразу до 0,21: самые крупные решения о том, что будет в кадре, принимаются на первых шагах. Последние шаги мелкие, на них обычно уже ничего не переставить, остаётся подчистить.
CFG и негативный промпт
Классический приём в диффузионных моделях называется CFG, classifier-free guidance. Каждый шаг модель считает два раза: один раз с промптом, второй раз без промпта, а разницу между двумя результатами использует как подсказку, куда двигаться. Смысл в том, что модель сильнее держится текста.
Цена у приёма прямая: работа удваивается, время генерации тоже. Поэтому часть новых моделей обходится без CFG. HyperFlow работает без него по карточке модели, и там негативный промпт не нужен: запрещать нечего, второго прохода без промпта просто нет.
Быстрые режимы: 4 шага, 6 шагов, 8 шагов
Меньше шагов значит быстрее. Модели учат этому специально, приём называется дистилляцией: быстрая модель-ученик тренируется повторять результат медленной модели-учителя и делает то же самое за меньшее число проходов.
Конкретика из первоисточников 10 ноября 2026. HyperFlow H3 Flash выпускает видео за 4, 6 или 8 шагов: 4 для скорости, 6 как баланс, 8 для качества, так написано в карточке на Hugging Face. pi-H3 работает за 2-4 шага, а на последнем шаге выдаёт пиксели сразу, без декодера. Пять секунд видео у неё собираются за 3,8 с на одной B200.
Цена скорости и что из этого следует заказчику
У быстрых режимов есть обратная сторона. Авторы pi-H3 пишут, что у других быстрых версий H3 движение бывает урезанным и механическим. За pi-H3 не отвечу, у неё свои заявления, а общее правило простое: чем сильнее сжато число шагов, тем выше шанс потерять живость движения.
Поэтому быстрые режимы это черновик и подбор вариантов. Дешёвый способ проверить идею, сравнить два-три движения, выбрать композицию, пока не поздно. В Google Flow у Omni 1.2 Flash разрешение 360p стоит треть цены 720p, и на пробах это экономит заметно.
Финал собирают на полном качестве. Если на финале плывёт текст, надпись лучше наложить в монтаже: титры в редакторе дают резкие буквы, и генератору не приходится угадывать шрифт.
Разумный порядок такой: черновики на быстрых режимах и низком разрешении, финальные кадры через видео нейросетями с проверкой каждого кадра глазами. Для рекламы с жёстким текстом в кадре подходят ручные ролики от 16 000 ₽, там надписи и графика ставятся руками. Что даёт контроль через опорные кадры, разобрано в материале про ключевые кадры в ИИ-видео, а опыт MiniMax H3 собран в отдельной заметке.
Что с этим делать заказчику
Генератор видео это шум, который несколько раз подчищают по тексту промпта, и каждый проход стоит времени и денег. Понимание шагов даёт простую выгоду: видно, где экономить, и не приходится ждать от черновика качества финала.
Если из статьи запомнить одну вещь, пусть это будет лестница шума. Первый шаг решает композицию, последние доводят детали, и повторный прогон не спасёт сцену, у которой не задалась композиция.