Почему трек диктует монтаж
Песня приходит с готовым каркасом: вступление, куплет, припев, иногда бридж и финальный припев. У каждой части своя плотность событий, и кадр под неё подбирают до генерации. Когда клип собирают наоборот, от понравившихся сцен, работа превращается в подгонку: сцена длиной четыре секунды не влезает в двухсекундную долю, и на стыке видно рывок.
Мой порядок такой. Сначала сетка битов и границы фраз по восемь тактов. Потом смысл: что происходит в куплете, что в припеве, где кульминация. И только затем сцены, привязанные к фразам. Такой план занимает вечер и экономит неделю.
На сетке видно ещё одну вещь. Припев почти всегда повторяется, и второй заход требует вариации. Один и тот же кадр дважды читается как ошибка монтажа. Вариация бывает дешёвой: другой ракурс, другой свет, крупнее план.
Что нейросеть делает с голосом
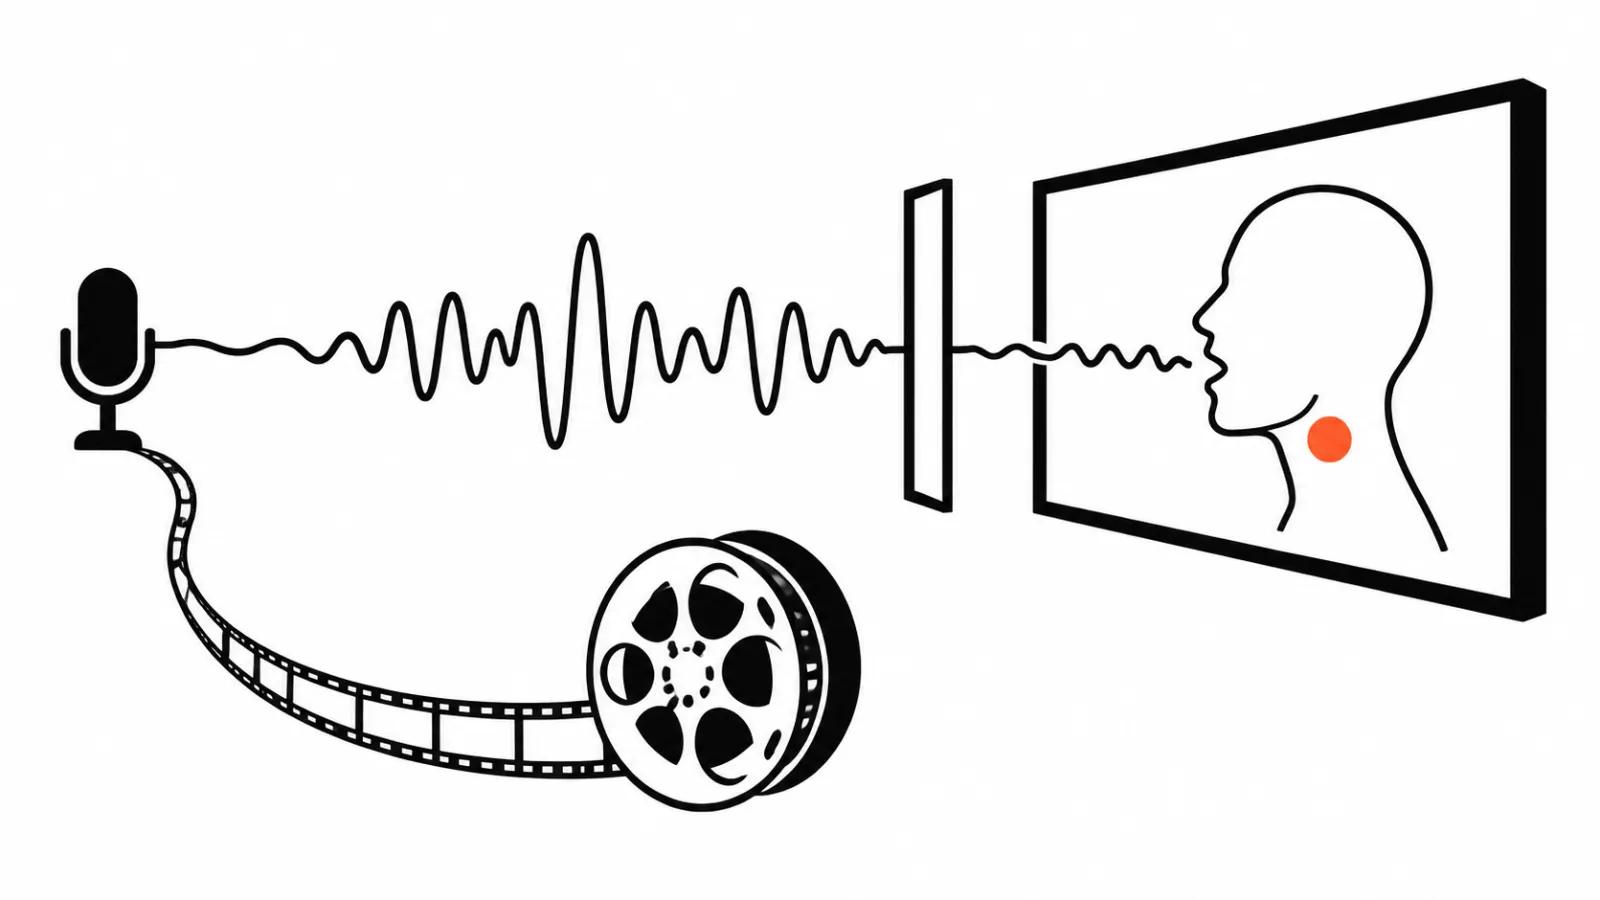
Лип-синк модель получает видео и аудио, дальше перерисовывает артикуляцию под дорожку.
В документации sync. labs сказано, что lipsync-2 и lipsync-2-pro считают видео независимыми кусками по две секунды и им нужна естественная речевая моторика в исходнике. На статичных фрагментах лип-синк не срабатывает, даже когда звук есть. sync-3 устроен иначе: он строит общее понимание человека на весь план и генерирует все кадры сразу, поэтому швов между кусками нет. Разрешение лица там же: 512 на 512 у lipsync-2 и lipsync-2-pro, нативные 4K у sync-3. Перекрытия, профиль и частично закрытые лица тянет sync-3, у младших моделей это слабое место. Параметр температуры управляет выразительностью артикуляции, по умолчанию 0,5, и доступен у двух младших моделей.
Практический вывод простой: под лип-синк нужен живой фрагмент, где человек говорит. Застывшее лицо под песню не оживёт, сколько дублей ни делай.
Раскадровка по битам
Запрос «создать клип по песне нейросеть» описывает половину работы. Вторая половина начинается на бумаге.
Я делю трек на фразы по восемь тактов и ставлю на каждую фразу две или три сцены. При 120 ударах в минуту такт это две секунды, фраза шестнадцать. Сцена живёт от пяти до восьми секунд, и это удобная длина для генерации: успевает произойти одно событие.
Дальше распределяю роли. В куплете работает повествование: среда, герой, движение. В припеве держат лицо и ритм, потому что зритель в этот момент подпевает. На бридже можно позволить паузу и общий план, там внимание провисает у всех.
Отдельно помечаю кадры, где будет текст. Если в кадре появляется строчка песни, под неё нужно место, и лучше нижняя треть. Текст, который скачет по всему экрану, отвлекает от артикуляции.
Лип-синк: где он держится
Лип-синк ставят на припев и на две-три крупные фразы, где герой смотрит в камеру. Остальное собирается движением, светом и монтажом.
Так дешевле и честнее. Синхронизация всего трека подряд выглядит механически: рот двигается, глаза живут отдельно. У младших моделей кусок длится две секунды, и на длинной дистанции швы между кусками становятся заметнее.
Мой список стоп-кадров для лип-синка короткий. Профиль, рука у лица, микрофон в кадре, сильное движение головы. Всё это модели младшего уровня ломают, и переделка стоит дороже, чем другой ракурс на съёмке.
Права на музыку решают раньше монтажа
Самая дорогая ошибка в клипе по песне случается до первого кадра. Музыка, взятая без разрешения, приходит заявкой от правообладателя.
Справка YouTube описывает Content ID так: загрузка автоматически сканируется по базе аудио и видео, которую предоставили правообладатели. Совпадение даёт заявку, и дальше владелец выбирает одно из трёх действий: блокировать просмотр, показывать рекламу и делиться доходом с загрузившим или просто отслеживать статистику. Любое из этих действий может действовать по странам отдельно.
Для клипа это значит, что права проверяют до раскадровки. Трек, который нельзя использовать в размещении, не спасает никакая анимация.
Сколько кадров нужно на три минуты
Считаю на пальцах. Три минуты при 120 ударах в минуту это 180 секунд, то есть 90 тактов и примерно 11 фраз по восемь тактов. По две-три сцены на фразу выходит 25 или 30 сцен. Для генерации это реальный объём на несколько дней, для монтажа один длинный вечер. Смета на клип на заказ считается по сценам, минуты в ней ничего не объясняют.
Если сцен меньше двадцати, клип начинает тянуть: одна и та же картинка держится слишком долго. Если больше сорока, зритель не успевает прочитать ни одну и воспринимает ролик как нарезку. Здесь помогает тот же приём, что в рекламе: одна сцена, одна мысль.
Вертикальная версия и титры
Песня почти всегда живёт в двух пропорциях. Горизонталь для площадки и вертикаль для ленты. Я делаю сразу две композиции, потому что перекадрирование из 16:9 в 9:16 срезает края и убивает общий план.
Вертикальная версия требует другой крупности. Человек в кадре занимает больше места, фон уходит в размытие, а межкадровая динамика читается быстрее. Из одного трека массовые вертикальные ролики собираются по тому же принципу: первая секунда решает, останется зритель или нет.
Титры с текстом песни лучше отдавать файлом. Справка YouTube принимает .srt и .sbv в простом UTF-8, разметку и стили такие файлы не передают, зато время и текст читаются точно. Для лирики это дешевле, чем жечь текст в кадр.
На пересборке видео нейросетями выигрывает: правка одной сцены не тянет за собой всю съёмку. Если считать бюджет заранее, полезно сравнить два подхода на цифрах из статьи про то, сколько стоит снять клип.
Вывод
Клип по песне нейросетью начинается с сетки битов и понимания, какие фразы будет петь герой. Лип-синк у младших моделей идёт кусками по две секунды, права проверяют до первой сцены, а число сцен считается из длительности трека.
Такой порядок не делает клип гениальным. Он делает его предсказуемым, и это ровно то, чего не хватает большинству заказных работ.