Что появилось 17 ноября
Репозиторий cyberterm/ComfyUI-OmniLoRA на GitHub создан 17 ноября, лицензия Apache 2.0. Внутри набор нодов для обучения LoRA прямо в графе ComfyUI. LoRA это небольшая добавка к большой модели, которая учит её одному персонажу, предмету или стилю: весит она десятки или сотни мегабайт и подключается к основной модели в момент генерации.
Главная деталь в описании такая: обучение идёт на той модели, VAE и текстовом энкодере, которые уже стоят на холсте. Отдельный тренер, второе окружение и перенос весов между программами здесь не нужны. Внешних pip-зависимостей тоже нет: набор берёт torch, safetensors и Pillow из самого ComfyUI. Для человека, который собирает ролики, это значит, что тренировка и съёмка живут в одном окне.
Зачем сборщику роликов LoRA персонажа для видео
Ролик живёт один раз, серия живёт месяцами. Как только заказчик просит «того же героя, но в другом месте», начинается борьба за лицо: референсы, сиды, пересборка промпта и всё равно третий кадр с другим подбородком. Разбор про ИИ-персонаж для видео я писал именно об этом, и вывод там был скучный: характер держится на весах модели.
LoRA меняет постановку задачи. Вы один раз учите модель конкретному лицу, товару или манере, а дальше подключаете файл к любому запросу и получаете похожего героя в новой сцене. Для серии вертикальных роликов с одним ведущим это разница между ручной сверкой каждого кадра и нормальным производством. Сборка ролика нейросетями работает так же: чем стабильнее входные данные, тем меньше переделок на выходе.
Как обучить LoRA в ComfyUI: один Queue
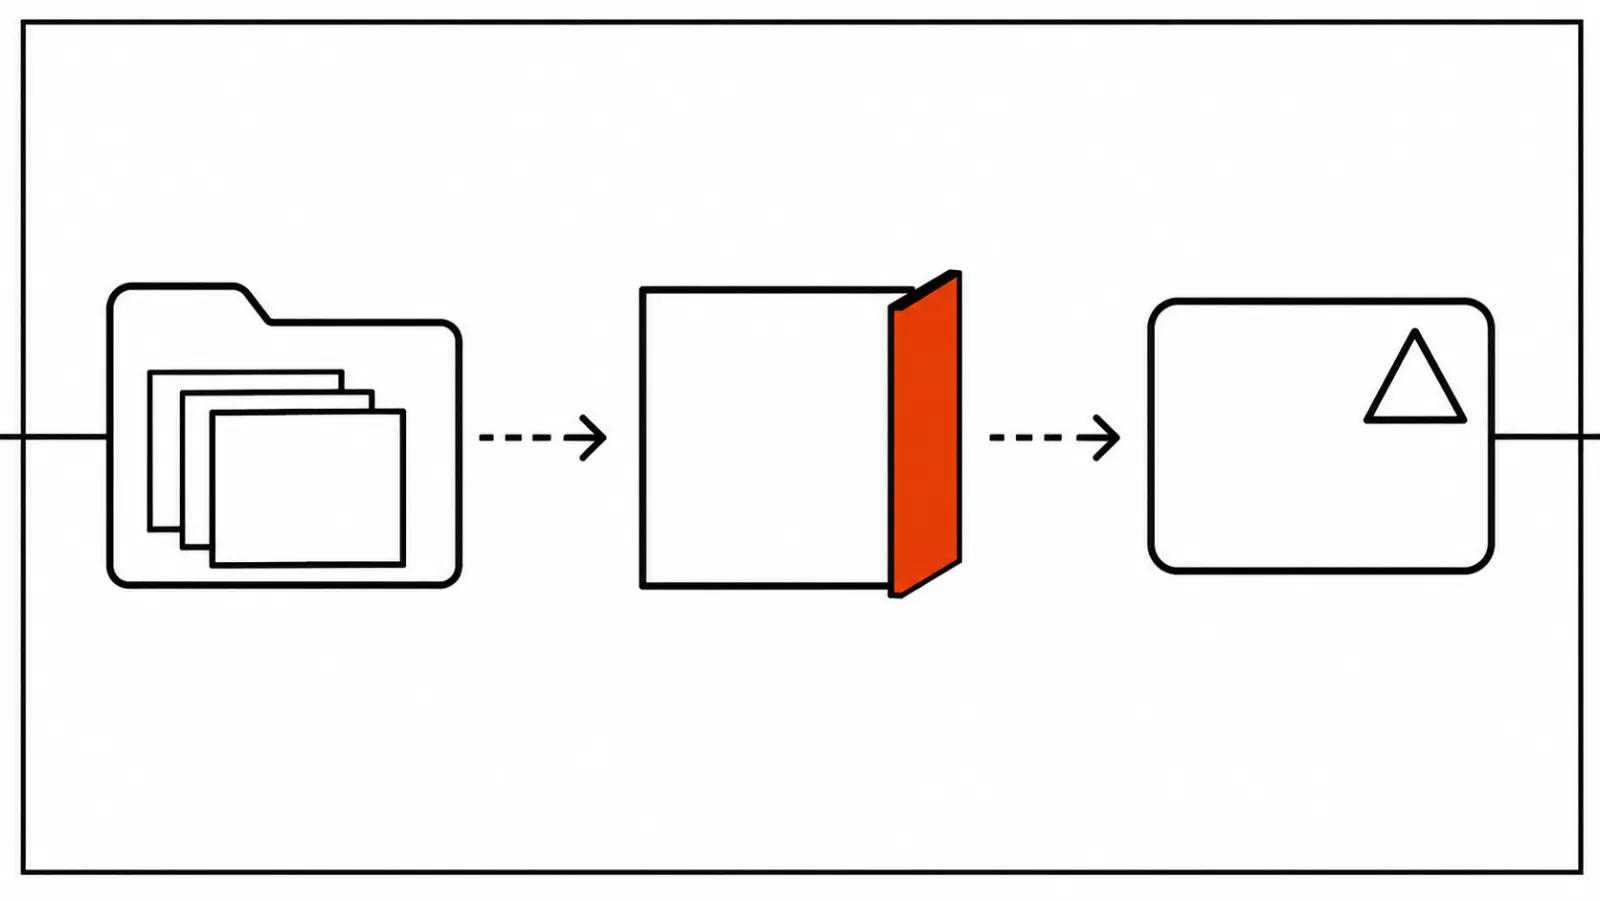
Установка обычная для ComfyUI: через ComfyUI Manager, поиск по слову OmniLoRA, либо git clone в папку custom_nodes. Дальше в репозитории лежит пример example_workflows/omni_lora_basic_workflow.json. В графе выбираете модель, текстовый энкодер и VAE, указываете папку с картинками и слово-триггер, нажимаете Queue. Готовый .safetensors ложится в ComfyUI/models/loras/, а пропатченную модель можно сразу подать в KSampler и смотреть первый результат.
Подписи к картинкам необязательны: набор подставит подпись по умолчанию плюс ваш триггер. Это экономит время, но качество связки «слово и объект» будет грубее, чем при ручных описаниях. Если картинки с прозрачным фоном или с маской, обучение сосредоточится на объекте и фон не запомнит. Для товара на белом фоне это удобно, для героя в интерьере придётся решать, что именно должно остаться в весах.
Стартовые цифры из README
Цифры в README стоит взять за точку отсчёта, дальше подгонять под материал.
Персонаж или предмет: 10-25 картинок, 800-1500 шагов, rank 32.
Стиль: 25-100 картинок, 1500-3000 шагов.
Быстрый тест: 5-12 картинок и 300-500 шагов, чтобы понять, попали ли вы в лицо, до основного прогона.
Видеокарта на 8-12 ГБ: оптимизатор adafactor и выгрузка слоёв в оперативную память.
Мой совет по шагам простой: начинайте с теста на десятке картинок. Короткая проба дешевле долгого прогона, который учил не того человека.
Модели, видеокарты и оговорки
По README поддерживаются Flux в версиях 1, 2 и 3 Klein, Qwen-Image, Wan 2.1 и 2.2 (видео и картинки), HunyuanVideo, LTX-Video, SDXL, SD 3.5 и другие модели, включая квантованные FP8, INT8 и GGUF. Железо перечислено широко: NVIDIA CUDA, Intel Arc, AMD ROCm, Apple MPS, DirectML и даже CPU. Для видео интереснее всего то, что в списке есть видеомодели Wan и LTX-Video.
Теперь оговорка, которая важнее списка. Проекту пара дней. Длинный перечень моделей и видеокарт это заявление автора, замеров по каждой модели в репозитории нет. Fervor Creative AI 18 ноября написал то же самое: список широкий, проверок мало, начинать стоит с маленького прогона. Я бы добавил: ставьте проект на тестовую ветку ComfyUI, а рабочую сборку держите отдельно, пока не увидите стабильный результат на своём материале. Выпуск про ComfyUI 0.43 и три новости показывает, как быстро меняется само ядро, и custom_nodes ломаются на обновлениях чаще, чем хочется.
Где здесь риск
Первый риск технический. Свежий набор нодов ломается на обновлении ComfyUI или на нестандартной квантованной модели, и выясняется это в середине работы.
Второй риск юридический, и он серьёзнее. LoRA на лицо человека означает обучение на его фотографиях. Обучать на своём материале, на съёмке с согласием модели или на фото товара от клиента это нормально. Тянуть кадры из чужого ролика или соцсетей не стоит, даже если технически получается похоже. Права на исходные картинки проверяются до прогона.
Третий риск содержательный. Десять картинок в одном свете дают LoRA, которая знает только этот свет. В новой сцене герой поплывёт, и это будет выглядеть как ошибка модели.
Мой вывод
OmniLoRA закрывает дырку, которая мешала многим: раньше своя LoRA требовала отдельного пайплайна и терпения, теперь всё сводится к папке с картинками и одной кнопке. Для студии, которая делает серии с одним героем или одним товаром, это прямая экономия времени. Ручные ролики выигрывают так же: персонаж перестаёт быть лотереей в каждом кадре.
Я бы не строил на этом процессе производство в первую неделю. Схема такая: тест на десяти картинках, проверка лица на новых сценах, и только потом основная серия. И отдельно проверенные права на каждую картинку в датасете.