ElevenLabs открыла SFX v3 в API: ИИ звуки для видео уходят в код
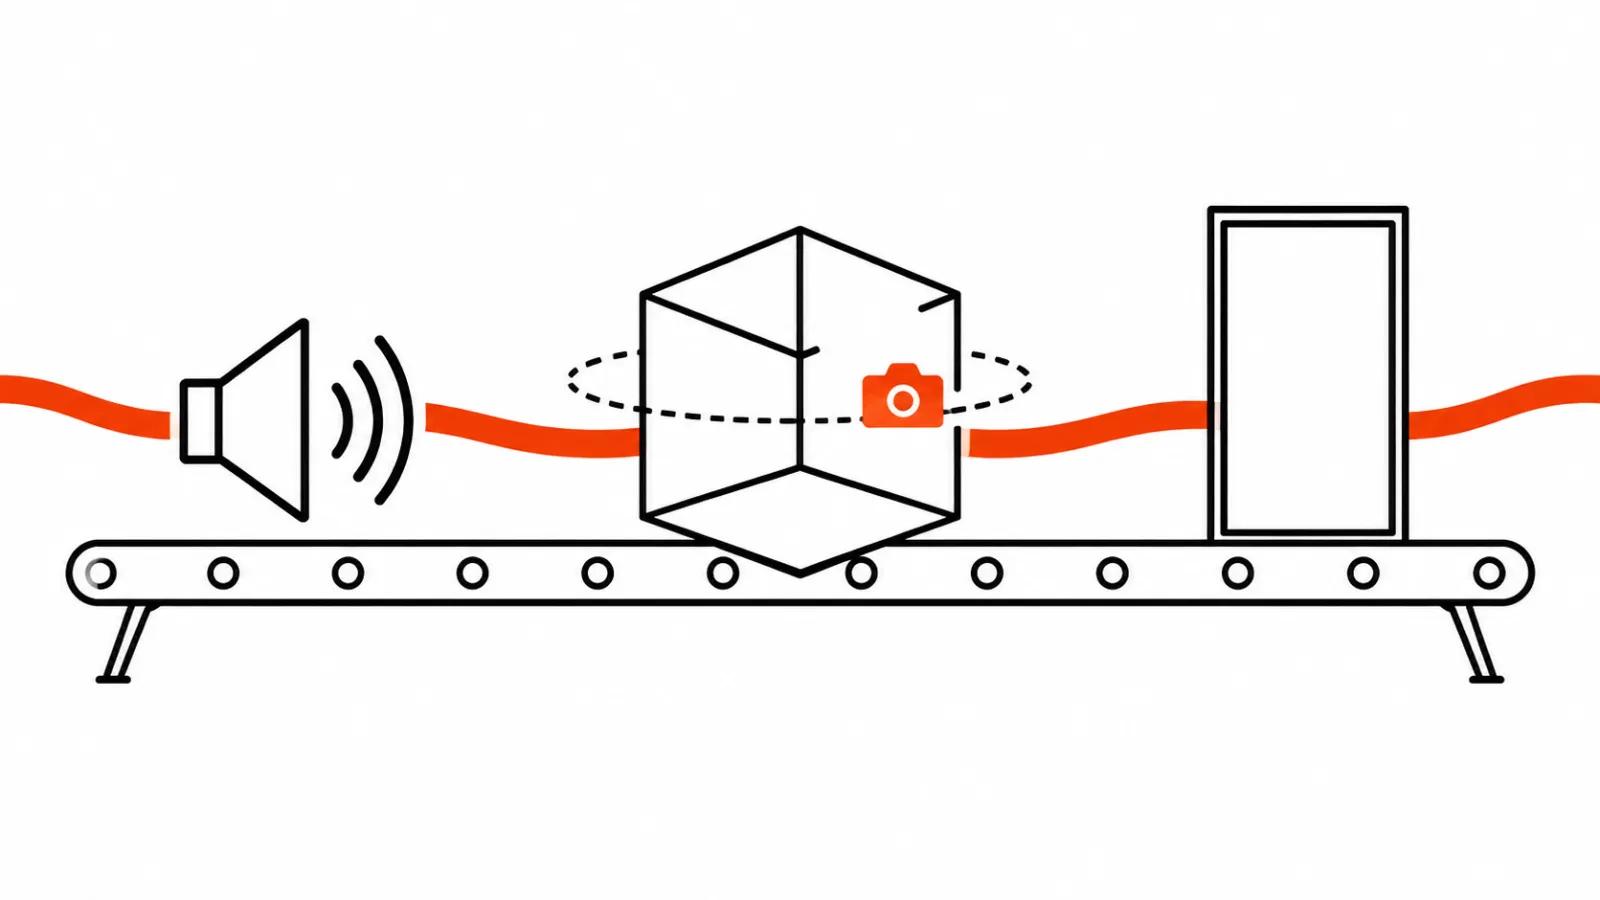
2 ноября ElevenLabs выложила модель звуковых эффектов SFX v3 для разработчиков. В API она вызывается через model_id eleven_text_to_sound_v3 на том же эндпоинте генерации звука, что и предыдущая версия. Раньше звук к ролику делали в приложении: набрать промпт, послушать варианты, скачать файл, подставить в монтаж.
Промпт модель понимает по частям и держит порядок событий: сначала шаги по гравию, потом металлическая дверь. Длину эффекта она подбирает сама по описанию, а точный тайминг задаётся параметром duration_seconds. Для конвейера это удобно: звук приходит туда же, где собирается картинка.
prompt_influence, луп и старая модель
Насколько строго модель держится промпта, задаёт параметр prompt_influence, по умолчанию он равен 0,3. Значение низкое, поэтому результат может уйти от описания. Если звук уплывает, ElevenLabs советует поднять параметр: чем он выше, тем точнее модель держится текста и тем меньше разброс между генерациями.
Зацикливание звука пока работает только на v2. У v3 лупа нет, и фоновый шум под длинную сцену придётся делать на старой модели либо склеивать в монтаже.
Почему это важно: звук внутри конвейера
Один ролик в неделю спокойно живёт на подписке и ручной сборке звука. Двадцать роликов в день руками не собираются: каждый переход, каждый удар и каждая дверь съедают минуты, а на потоке это часы.
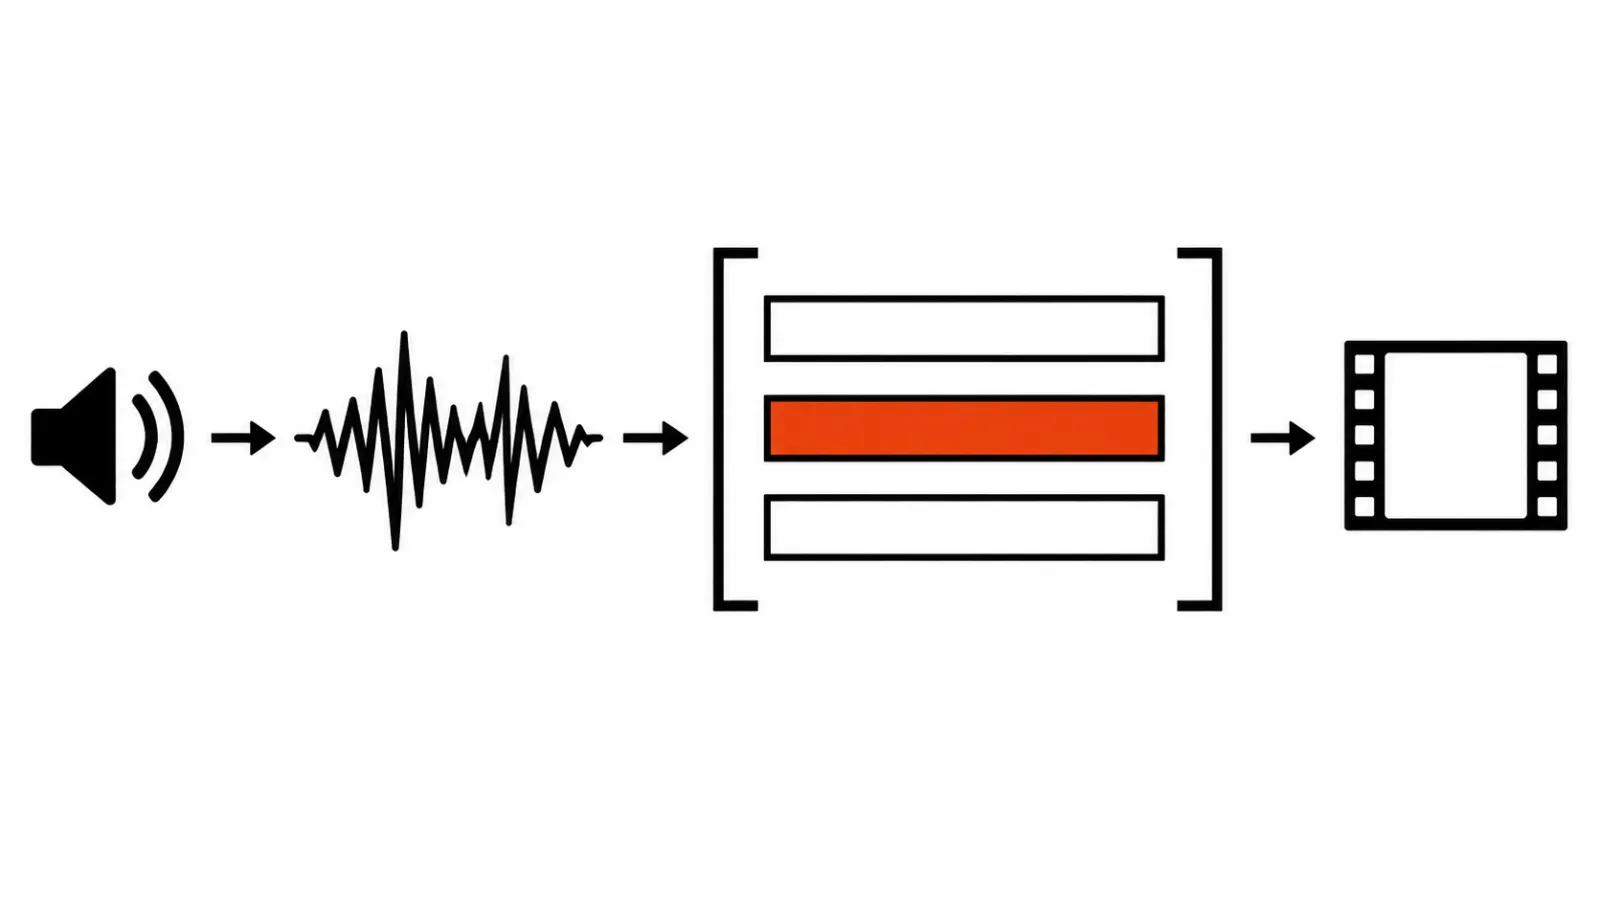
API меняет схему. Промпты к звуку можно держать в том же скрипте, что и промпты к сценам, а результат класть сразу в тайм-лайн. Про то, как ElevenLabs генерирует звуки для видео в приложении, мы писали в день запуска, здесь важна вторая часть, доступ из кода.
На потоке звук и есть типичное узкое место: картинку генерируют пакетно, а звук дописывают по одному ролику, потому что каждый требует прослушивания. Отсюда и смысл API, который снимает ручной проход по файлам.
Практический шаг простой: взять три ролика из архива, прогнать звук через API и сравнить с тем, что выходит руками. Если разница в пользу API, дальше это вопрос шаблона.
MiniMax H3 и ORB360: из статичной демки в интерактив
1 ноября аккаунт Hailuo AI в X показал, что связка открытой видеомодели MiniMax H3 и LoRA ORB360 стала интерактивной. До этого это была статичная демка. Что именно теперь можно делать со сценой, в посте не расписано. Компания намекает на VR как следующий шаг.
Отдельной документации нет, есть только пост. Контекст даёт тест от 13 октября: Hailuo показывала, как автор оживил чёрно-белую мангу со свободной камерой на H3 плюс ORB360. Лицо персонажа держится, если передать его референсом.
Почему это важно: от ролика к сцене
Открытая модель плюс LoRA двигаются в сторону сцены, по которой можно ходить камерой. Для одного ролика это пока не нужно, для раскадровки и превиза полезно: режиссёр смотрит на пространство, а картинка вторична.
Смысл связки в другом. Открытую модель можно дообучить под узкую задачу и получить поведение, которого в базовой версии нет, и это дешевле, чем ждать обновления от лаборатории.
Цен и сроков нет, поэтому строить план производства на анонсе рано. Смотреть стоит за одним: появятся ли документация и веса LoRA в открытом доступе. Пост в X пока единственный источник.
Drama916: новости нейросетей для видео с хакатона Qwen
2 ноября в блоге Alibaba Cloud вышла статья о проекте Drama916 с Global AI Hackathon Series with Qwen Cloud. Проект получил Blog Post Award и решает одну задачу: превращает идею в вертикальную историю 9:16.
Модели Qwen пишут сценарий, планируют сцены и прорабатывают персонажей, видеомодель Wan рендерит кадры. Цепочка короткая: идея, структура истории, готовое вертикальное видео. Это хакатонный проект, у Alibaba Cloud он описан как пример работы с Qwen, продуктовой упаковки и цен нет.
Почему это важно: мини-дорамы собирают по шаблону
На рынке вертикальные мини-дорамы уже собирают по шаблону: языковая модель пишет, видеомодель рисует. Порог входа падает, потому что съёмочная группа заменяется связкой моделей и одним человеком на монтаже.
Узкое место при этом остаётся в сценарии и ритме. Модель пока собирает историю по готовой структуре, а удержание зрителя решают сценарист и монтаж. Про рынок и форматы мы писали отдельно.
Для рекламы это меняет порядок работы: идея проверяется до съёмок, а вертикальный формат видно сразу на выходе, без отдельной верстки под 9:16.
Вывод: ИИ видео новости 3 ноября про одно и то же
Все три новости про одно: генерация уходит внутрь конвейера. ElevenLabs отдаёт звук в API, MiniMax собирает интерактивную сцену из открытой модели и LoRA, Alibaba показывает связку текстовых моделей и видеомодели в одном проекте.
Для бизнеса выигрывает тот, у кого собран процесс. Самая новая модель без процесса даёт один ролик и вечер ручной склейки.
Если роликов много и они короткие, работает поток вертикальных роликов: один шаблон, много версий, предсказуемая цена за штуку. Если нужен ролик под задачу, есть смысл посмотреть, как сделать видео нейросетями: там про путь от брифа до готового файла.
Первое, что стоит сделать на этой неделе, это выписать, где в вашей цепочке звук, сцена и монтаж делаются руками. Список таких мест и есть план автоматизации.