Три дорожки звука в одном ролике
Ролик из шотов это три звуковые дорожки. Первая это голос. Вторая это музыка и общий фон, который держит сцену. Третья это эффекты: шаги, скрип, удар, шум улицы. Ошибка новичка в том, что все три пытаются получить из модели одним нажатием, а потом полдня сводят то, что не сошлось.
Порядок работы со звуком определяет картинка. Если в кадре человек говорит крупным планом, разница между звуком, который родился вместе с видео, и звуком, который записали отдельно, видна по губам за полсекунды. Если в кадре продукт, руки, город, машина, голос не обязан совпадать с мимикой, и его спокойно пишут после монтажа картинки.
Дальше пять решений, которые принимают до первого шота. Где живёт голос, что модель делает сама, где её звук ломается, когда синхрон губ нужен отдельным проходом, и почему субтитры идут в самом конце.
Где живёт голос
Схем две. Первая: голос внутри промпта, модель генерирует реплику вместе с губами, и синхрон получается как побочный эффект. Вторая: голос отдельным файлом, а картинка генерируется без речи. Выбор зависит от трёх вещей: длина реплики, количество дублей, требования к тембру.
Короткая фраза на три-шесть секунд дешевле по времени в первой схеме. Монолог на сорок секунд и серия из двадцати шотов с одним героем надёжнее во второй, потому что тембр и темп держит один файл вместо двадцати генераций с разным настроением.
Тут же решается, сколько шотов нужно. Раскадровка влияет на звук напрямую: чем короче шот, тем меньше шансов, что модель успеет договорить, и тем больше склеек придётся прятать под музыку. Как резать ролик на шоты, я разбирал отдельно, там же видно, почему длинную реплику лучше дробить по смыслу.
ИИ видео со звуком: что реально даёт модель
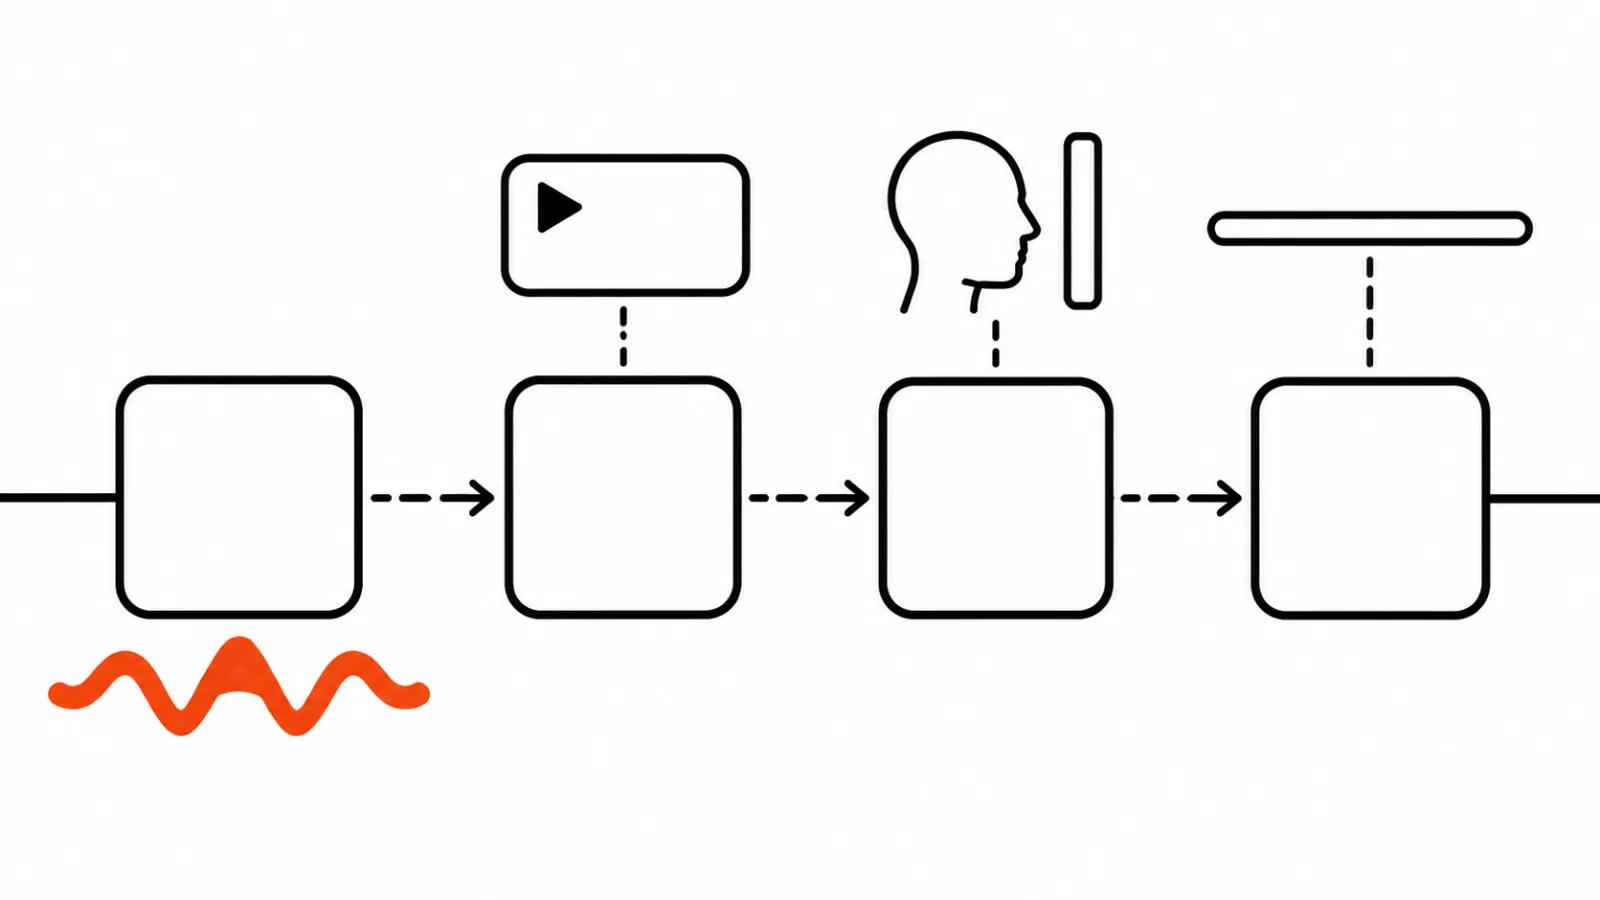
Kling 4.0 по гайду на kling.ai выдаёт двухканальное стерео и более точный синхрон губ. В списке языков девять: китайский, английский, японский, корейский, испанский, португальский, немецкий, французский, хинди, плюс диалекты и акценты вроде американского или британского английского. Реплику в промпте пишут в кавычках на нужном языке, а рядом описывают возраст, тембр, темп и эмоцию говорящего.
Отдельным блоком AUDIO в том же гайде советуют перечислить, кто молчит, какие фоновые звуки остаются и нужна ли музыка. Этот блок экономит больше времени, чем кажется: половина брака в озвучке приходит из того, что модель добавила второй голос за кадром или вписала музыку поверх реплики.
Для заказчика вывод простой: короткую реплику на языке из списка можно получить прямо из генерации. Длинный текст и точные названия проверяют по слогам, а правки идут через перегенерацию шота.
Где нативный звук ломается
Главный риск серии шотов в том, что тембр и громкость прыгают от шота к шоту. Каждый шот генерируется отдельно, модель не помнит предыдущий голос, и на склейке герой звучит как другой человек с похожей внешностью. Проверять это надо на слух по стыкам, до сведения музыки: включить два соседних шота подряд и послушать переход. Статистики у меня нет, но проверка занимает минуту и делается всегда.
Второй риск это лишняя речь. Модель любит добавлять бормотание фона, реплики прохожих, объявления. На отдельном шоте это оживляет кадр, в серии превращается в кашу, где непонятно, кто говорит.
Третий риск это обрубленный хвост. Реплика не влезла в длину шота, последний слог срезан склейкой, и зритель слышит обрыв. Лечится длиной шота с запасом в полсекунды и монтажом по паузам.
Как сделать ИИ видео с озвучкой отдельной дорожкой
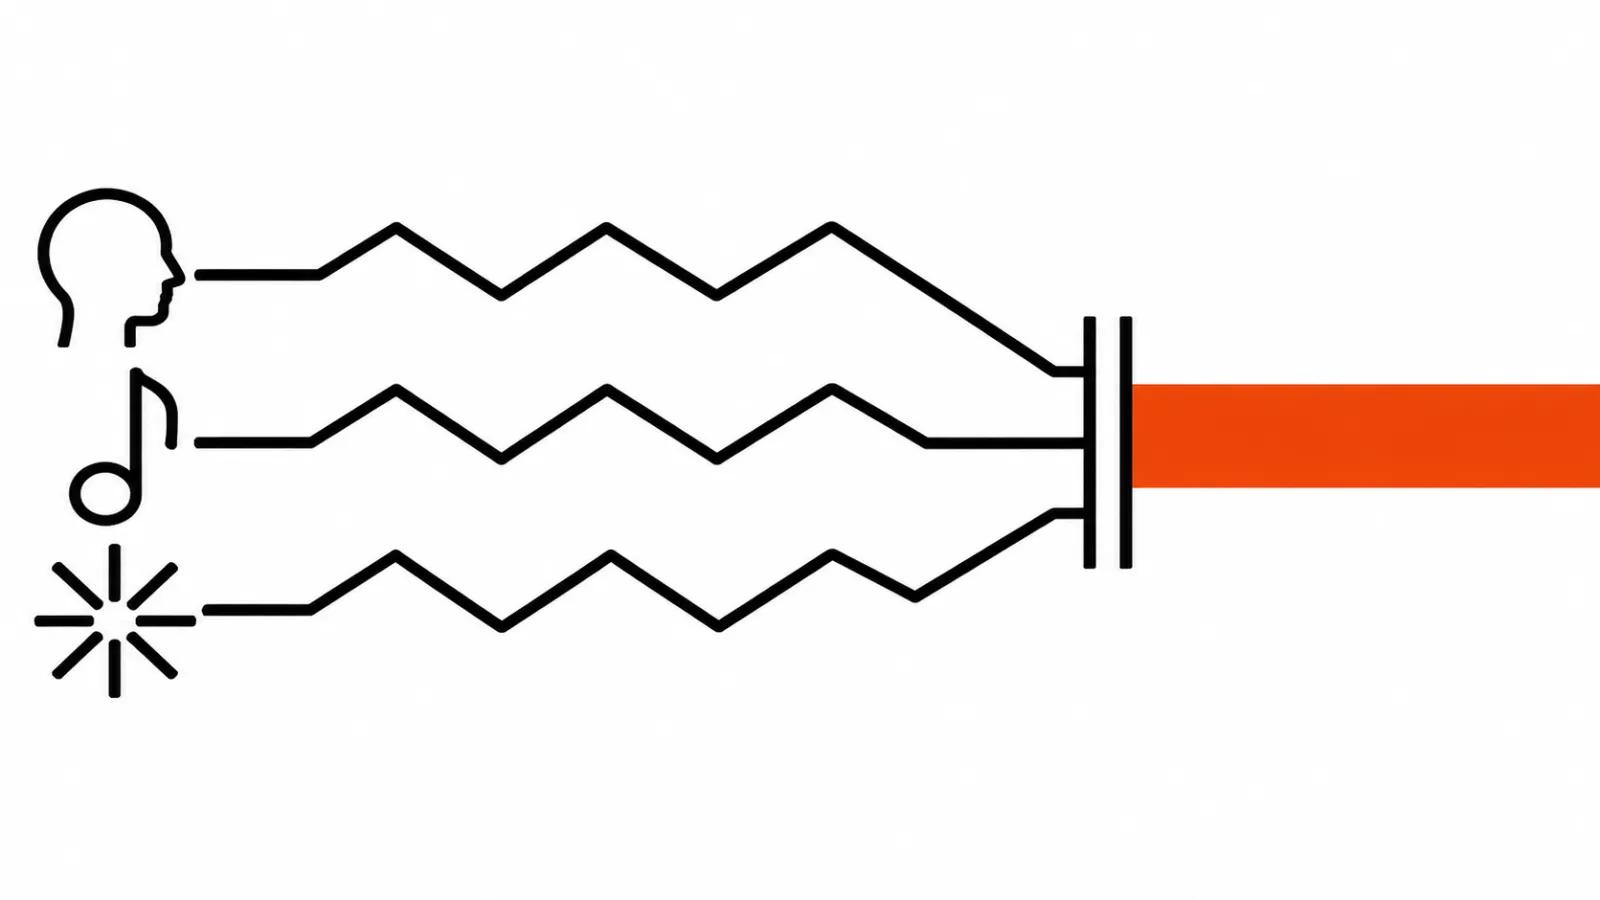
Схема простая и предсказуемая. Сначала пишем голос целиком: синтез речи или диктор, один тембр на весь ролик, один темп. Потом режем дорожку по шотам и подгоняем длину шотов под фразы. Обратный порядок даёт обрубленные слоги и переозвучку. Музыку и фон кладём на монтаже поверх всех шотов одной дорожкой с общим уровнем, чтобы громкость не гуляла между сценами.
Музыка на монтаже важна отдельно. Если каждый шот принёс свою музыку, свести их в один трек почти невозможно: темп и тональность не совпадают, на стыке слышен щелчок. Один трек на весь ролик с плавным входом и выходом слушается как один ролик, даже если шотов двадцать.
Тут же решается вопрос с экономным вариантом: когда звук нужен быстро и без претензий к тембру, хватает синтеза речи по готовому тексту. Главное заранее записать произношение названий и цифр, иначе правки уйдут в переозвучку.
Синхрон губ отдельным шагом
Если голос писали отдельно, губы придётся переделать. Синхрон это отдельный проход: берём готовую дорожку, отдаём её в lip sync или в тот же Kling с голосовым референсом, получаем новую версию картинки. Проход недорогой по деньгам и дорогой по времени, поэтому его делают только на планах, где лицо видно.
На общем плане, со спины, на руках и на продукте синхрон не нужен, и его отсутствие никто не заметит. Это экономит дни. Что происходит с губами при переводе на другой язык и как это устроено в сервисах дубляжа, я разбирал в тексте про синхронный дубляж губ: там та же логика, только язык меняется, а порядок шагов остаётся.
Синхрон лучше делать до прожига субтитров и до цветокоррекции: повторная генерация лица меняет кадр, и наложенное сверху придётся ставить заново.
Субтитры: по финальному звуку и последними
Субтитры делают не по сценарию. Сценарий расходится с тем, что сказано в кадре: модель сократила фразу, диктор запнулся, монтаж вырезал полстроки. Поэтому текст распознают по финальной звуковой дорожке, уже после сведения и после синхрона.
Инструмент под эту задачу есть. ElevenLabs Scribe v3 по блогу компании от 9 ноября 2026 даёт на 27% меньше ошибок в словах, чем Scribe v2, работает со 102 языками и размечает спикеров. Для субтитров важна не только точность слов, но и тайминг: метки спикеров и нормальная расстановка пауз экономят ручную правку, особенно в диалоге на два голоса.
И главное: субтитры жгут последними. Причина простая. Любая правка звука после прожига означает новый текст, новый тайминг и новый рендер, а в вертикальном формате ещё и новую проверку безопасных полей, чтобы строка не уехала под интерфейс площадки. Пока звук не заморожен, субтитры остаются отдельным слоем в монтаже.
Мой вывод
Мой порядок такой. Решение про голос, потом генерация шотов, потом отдельная озвучка при необходимости, музыка и фон на монтаже одной дорожкой, синхрон по лицам, субтитры в самом конце. Проверка стыков на слух занимает десять минут и спасает от переозвучки всего ролика.
Вертикальная реклама и серии на потоке устроены так же, только шотов меньше, а стыков больше, поэтому прыжок тембра слышно быстрее. Когда ролик собирают штучно и за кадр отвечает человек, звук обычно идёт в одном пакете с монтажом: ручные ролики мы собираем именно так. Когда нужен объём, видео нейросетями делают партиями по общему шаблону звука, и там дисциплина дорожек важнее, чем любая отдельная генерация.
Главная мысль урока: звук в ИИ-ролике решают до первого шота. Кто решает его поздно, тот платит переозвучкой и новым синхроном.