Латент простыми словами
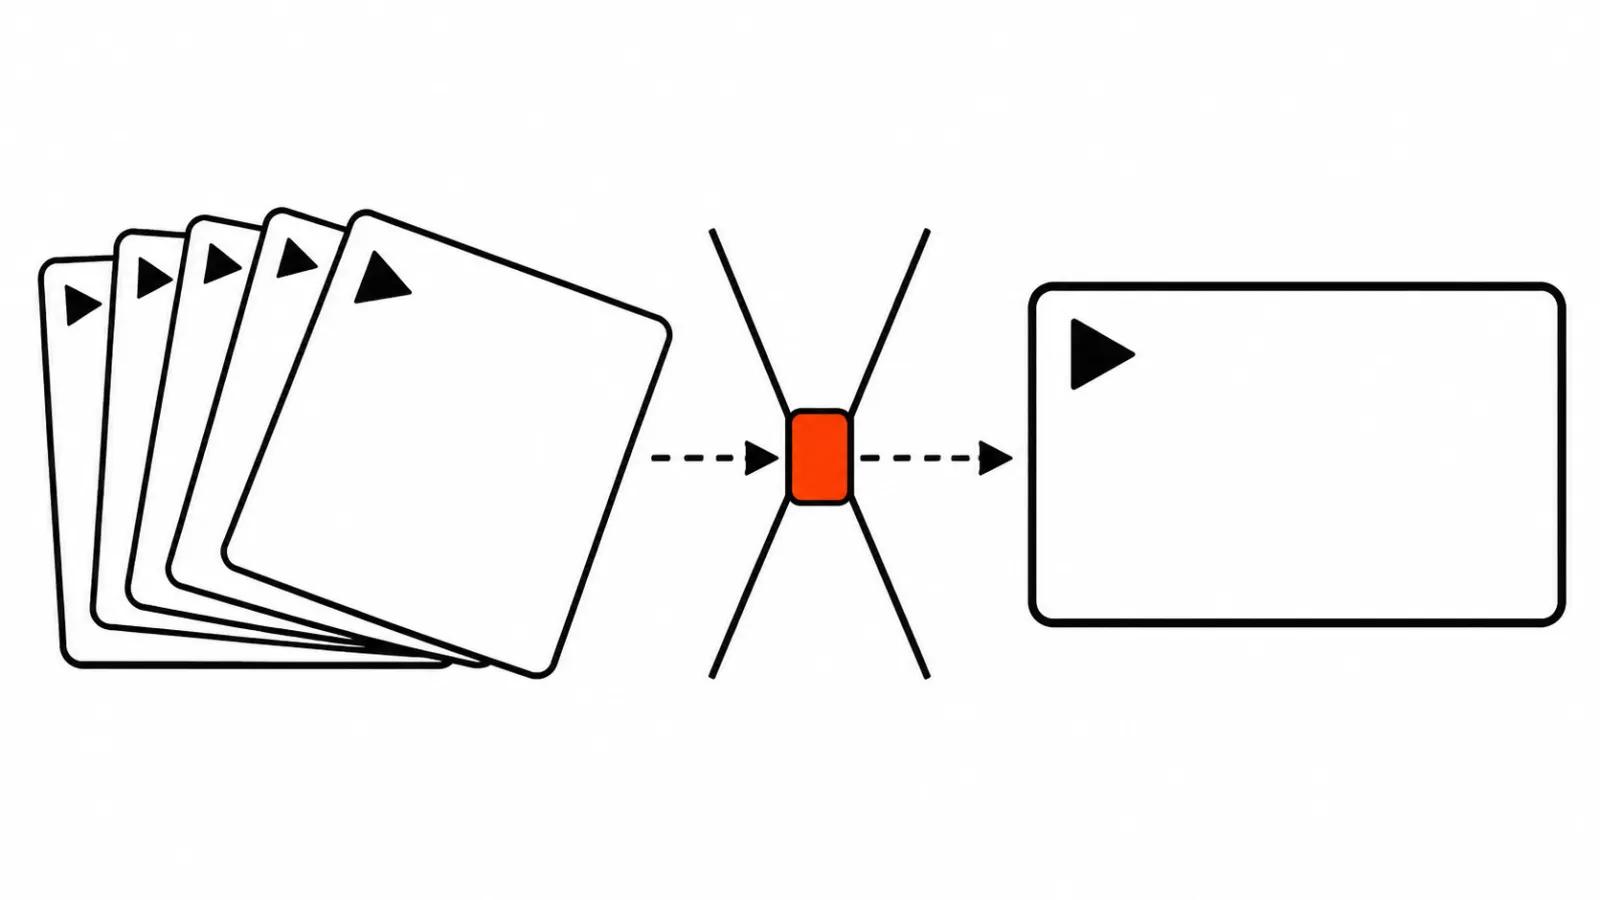
Смотрим на готовый ролик и видим картинку: миллионы цветных точек. Модель видит совсем другое. Перед генерацией ролик проходит через отдельную сеть, автоэнкодер, и она записывает его в компактной форме. Эту запись называют латентом. Дальше вся работа идёт с ним, и только в самом конце декодер разворачивает латент обратно в кадры.
Близкая аналогия из жизни это эскиз вместо картины: структура и композиция на месте, мелкая фактура упрощена. Важно понимать, что сжатие здесь с потерями. Архив распаковывается без потерь, латент всегда восстанавливается примерно, и разница между «примерно» и оригиналом это то, что часто называют артефактами генерации.
Как нейросеть создает видео в сжатой записи
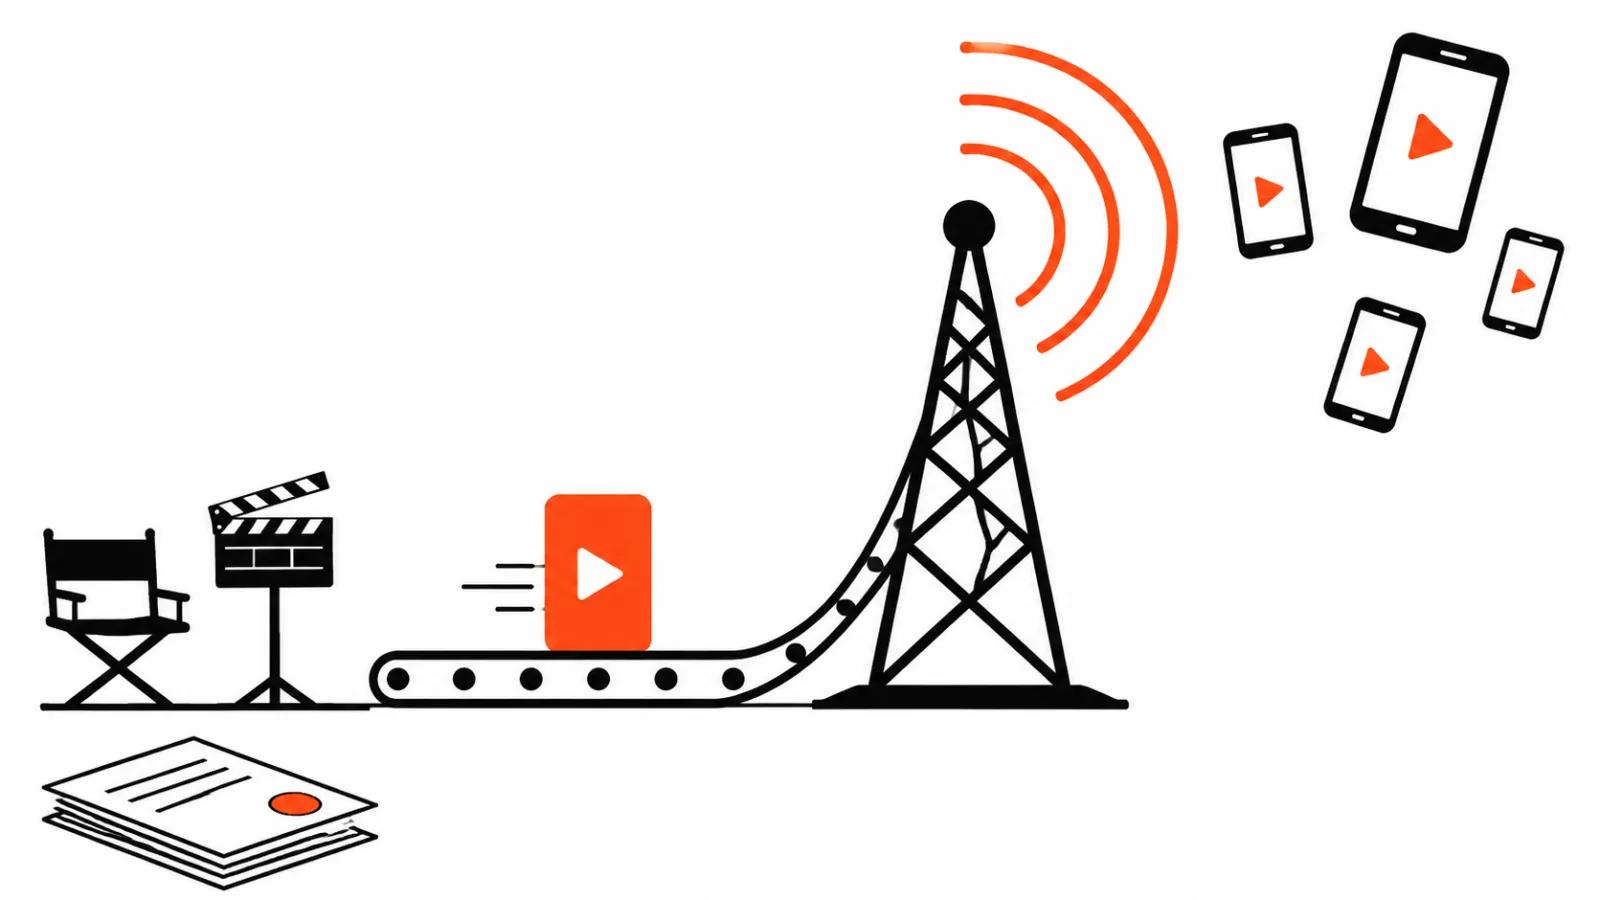
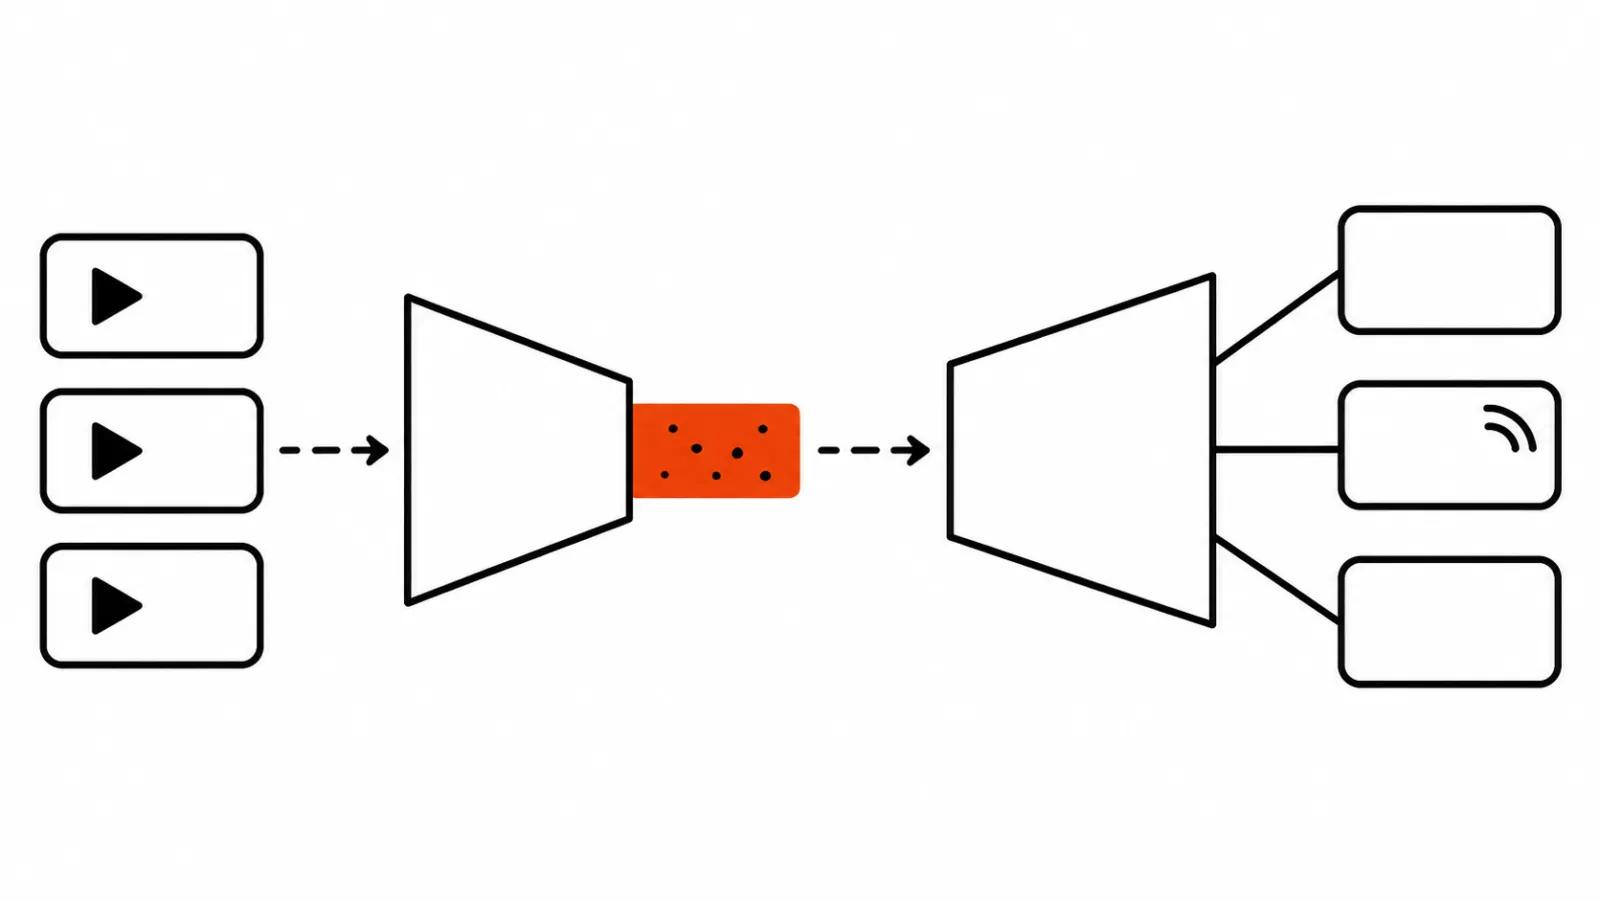
Чтобы увидеть, как нейросеть создает видео изнутри, удобно следить за тремя сущностями. Энкодер сжимает референс или первый кадр в латент. Диффузионная модель шаг за шагом превращает шум внутри этой записи в осмысленное движение. Декодер собирает из готового латента кадры, которые вы уже скачиваете. Две сети по краям и большая модель посередине.
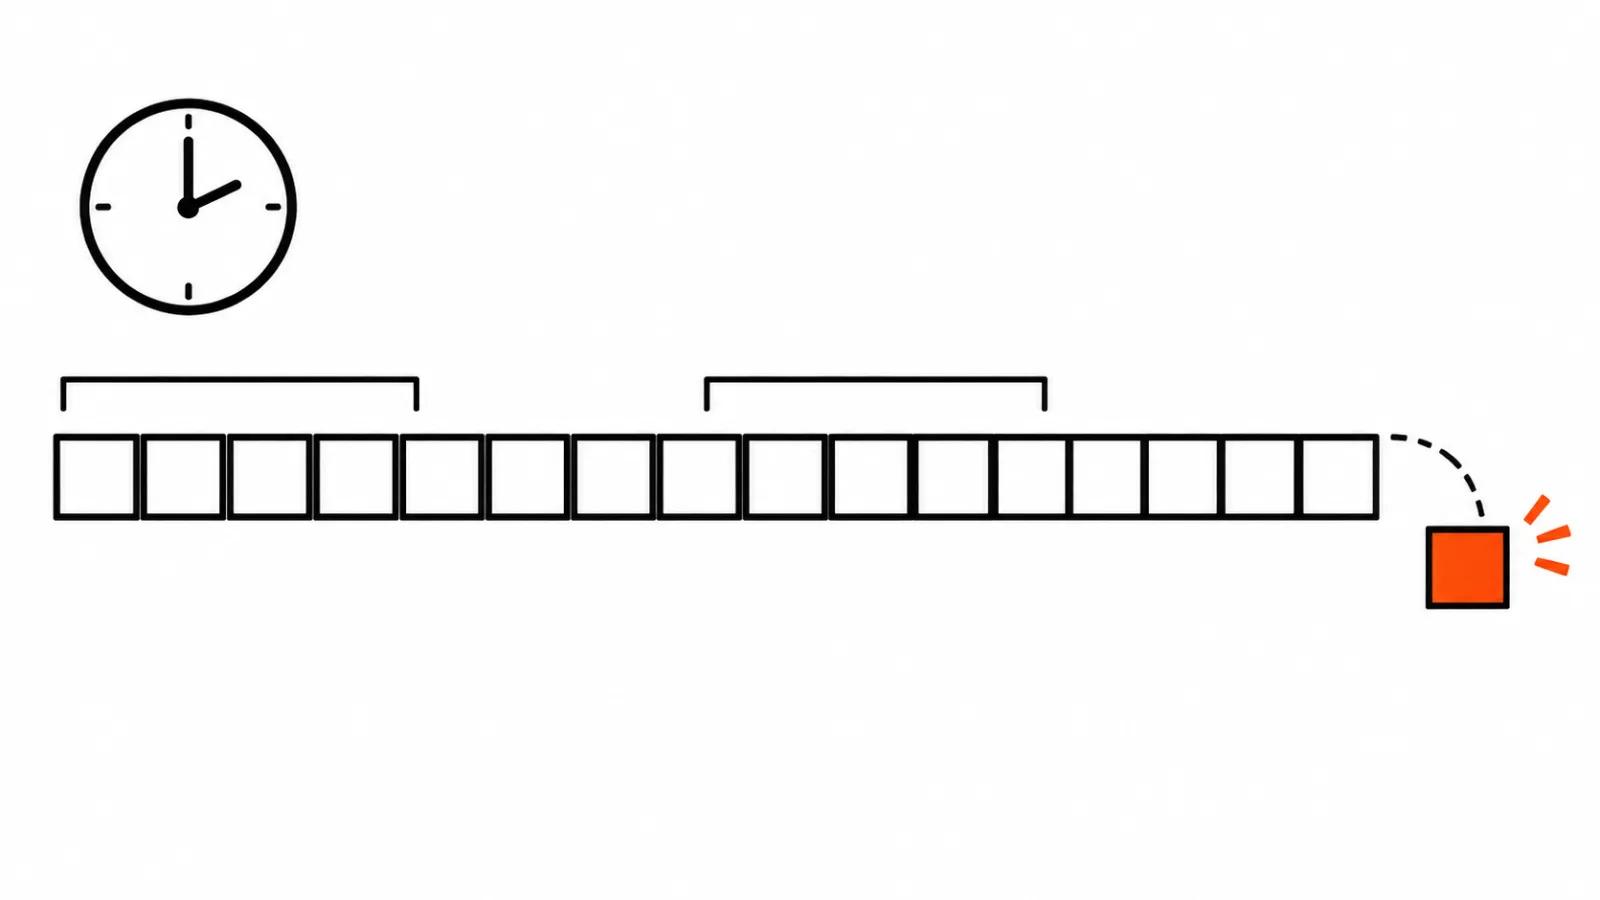
Так устроены почти все современные видеомодели. Хороший пример это открытая линейка Wan. В Wan2.1 стоит Wan-VAE, который авторы описывают как 3D causal VAE: сжатие идёт и по площади кадра, и по времени, соседние кадры склеиваются в блоки. В Wan2.2 у младшей модели TI2V-5B стоит VAE со сжатием 16×16×4, в шестнадцать раз меньше точек по каждой стороне кадра и в четыре раза меньше кадров в блоке, и именно это позволяет считать 720p на одной потребительской видеокарте. Сжатие здесь стоит на первом месте: без него вычисления не влезают ни в память, ни в бюджет проекта.
Что теряется при сжатии
Общий принцип такой: энкодер выбрасывает то, что считает второстепенным, декодер восстанавливает кадр по остатку. Мелкий текст и логотипы страдают первыми. Буква занимает десятки пикселей, после сжатия у неё остаётся меньше места, и на развороте надпись плывёт, буквы слипаются и меняют форму от кадра к кадру.
Тонкие детали это волосы, края предметов, брызги воды: там энкодер упрощает фактуру, и поверхность становится подозрительно гладкой. Быстрые движения страдают отдельно: когда несколько кадров склеены в один блок, движение внутри блока записано одним шагом, и быстрая фаза смазывается или дёргается.
Чтобы быть честным, отмечу: точный список потерь у каждой модели свой, он зависит от её энкодера, и процентов никто не публикует. Направление при этом общее для всех: чем мельче деталь и быстрее движение, тем меньше у неё шансов дожить до декодера. Отсюда же половина жалоб про то, что в ИИ-видео плывут лица и руки: лицо как раз тонкая деталь, которую сжатие упрощает. Самое наглядное требование здесь у того, кто заказывает говорящий аватар: лицо обязано оставаться одним и тем же от первого кадра до последнего.
Как нейросеть делает видео в 4K и почему это дороже
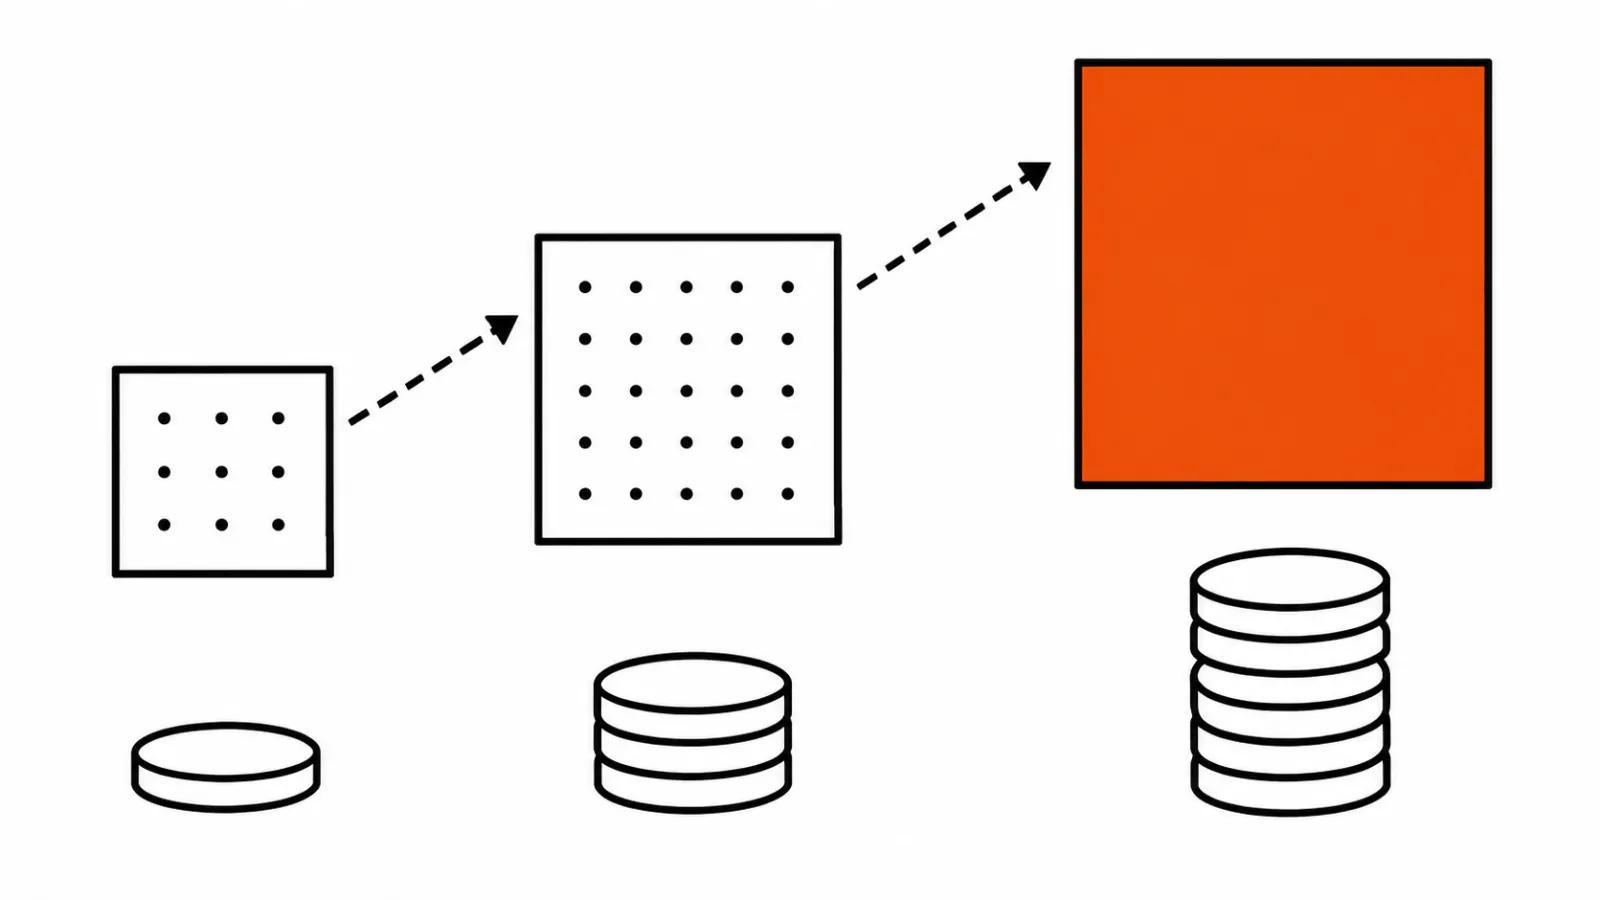
Цена растёт нелинейно. По данным работы PixVid, удвоение разрешения учетверяет число токенов, из которых модель собирает кадр, а внимание растёт ещё быстрее. В четыре раза больше вычислений на каждый проход, карта греется дольше, секунда видео стоит дороже. Обещать «всё сразу в 4K» поэтому нельзя без уточнений.
Отсюда привычный порядок на производстве: генерация идёт в базовом разрешении, затем апскейл делают отдельно, специальной моделью, которая достраивает детали уже на развёрнутых кадрах. Это два разных шага с двумя разными сетями, и в смете они выглядят как две строки. Для мелких надписей и логотипов тот же логический шаг дешевле сделать на монтаже поверх готового ролика.
Почему PixVid пробует обойтись без латента
Ноябрьская работа Back to Pixels (arXiv 2611.17336) от команды из Roblox, UC Merced, University of Pennsylvania и UT Austin пытается разорвать эту сделку. Они оставили диффузионный трансформер, а декодер VAE заменили свёрточной головой, которая рисует пиксели напрямую. Модель дообучили из Wan2.1-14B, конкурентоспособного с исходной моделью качества она достигает примерно на 1,3 млн обучающих клипов.
Результаты из аннотации: при том же числе токенов на кадр разрешение вдвое выше, а реакция на действие приходит на следующем кадре, без ожидания блока. Это исследование, не продукт: весов и кода на странице проекта нет, и обещать такой режим клиентам рано. Мы разбирали PixVid, который учится обходиться без латента, отдельным разбором, там подробнее про цифры и ограничения.
Мой вывод
Латент это честная сделка. Сжатие делает обучение модели вообще возможным, а платят за него мелкие детали и быстрые движения. Практически это значит три вещи. Мелкий текст в кадр добавляет человек, потому что так дешевле. 4K собирается из генерации и апскейла, потому что честной генерацией он стоит несоразмерно. И когда вы заказываете видео нейросетью под конкретную задачу, решение принимается на приёмке кадров, где видно, что пережило сжатие, а что нет.