О чём эта работа
Статья называется Back to Pixels: Lifting Latent Video Diffusion into Pixel Space, лежит на arXiv под номером 2611.17336. Авторы из Roblox, UC Merced, University of Pennsylvania и UT Austin, в списке есть Xun Huang и Ming-Hsuan Yang. Суть в одном абзаце: они берут готовую латентную видеомодель, оставляют диффузионный трансформер, убирают VAE и заставляют модель считать пиксели кадра напрямую.
Для человека, который заказывает ролики, это звучит как деталь чужой кухни. На деле речь про цену высокого разрешения и про то, насколько быстро модель отвечает на команду. Дальше по шагам, без формул и без обещаний, которых в статье нет.
Что такое латентное пространство простыми словами
Кадр 1664×960 это примерно 1,6 миллиона точек, и для каждой нужно предсказать цвет. Считать такую сетку целиком дорого, поэтому в дело идёт VAE, пара из энкодера и декодера: он сжимает видео в компактную запись, латент, а потом разжимает результат обратно в картинку. Модель внутри работает со сжатой записью.
Сжатие идёт по двум осям сразу. По площади кадра, где несколько соседних пикселей превращаются в один вектор, и по времени, где несколько соседних кадров склеиваются в один блок. Отсюда все дальнейшие компромиссы: мелкая деталь теряется, а движение внутри блока считается одним шагом.
Если хочется понять, как нейросеть генерирует видео по шагам, от латента до готового файла, у нас есть разбор всего конвейера.
Почему нейросеть генерирует видео в латенте и где упирается
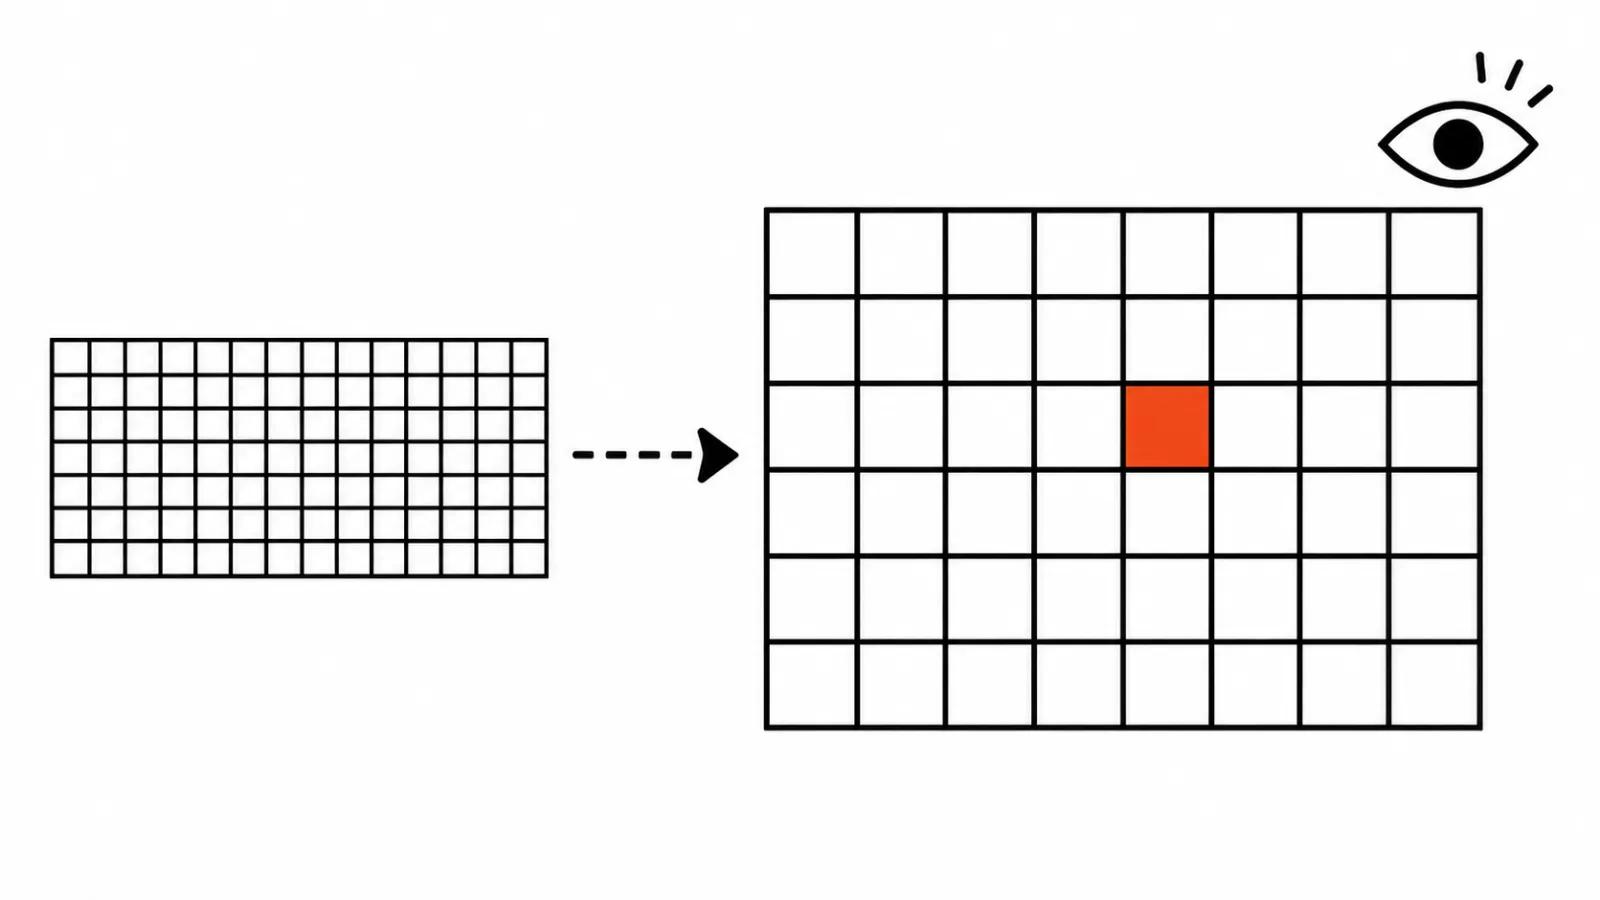
Авторы перечисляют три места, где латент начинает мешать. Первое: удвоение разрешения учетверяет число токенов, и внимание растёт ещё быстрее. Второе: условие или команда применяется к группе кадров, поэтому управлять отдельным кадром нельзя. Третье: ответ ждёт, пока досчитается весь блок из нескольких кадров, и это видно как задержку.
Цифры из работы показывают масштаб. Кадр 960p в латентной модели требует в 4 раза больше токенов, чем 480p, а внимания в 16 раз больше. Внимание растёт квадратично от числа токенов, и здесь проходит та стена, о которую упирается высокое разрешение при сжатом представлении. Для вертикального ролика всё то же самое: разрешение вертикального видео упирается в ту же арифметику, просто кадр повёрнут.
Как PixVid обходит сжатие
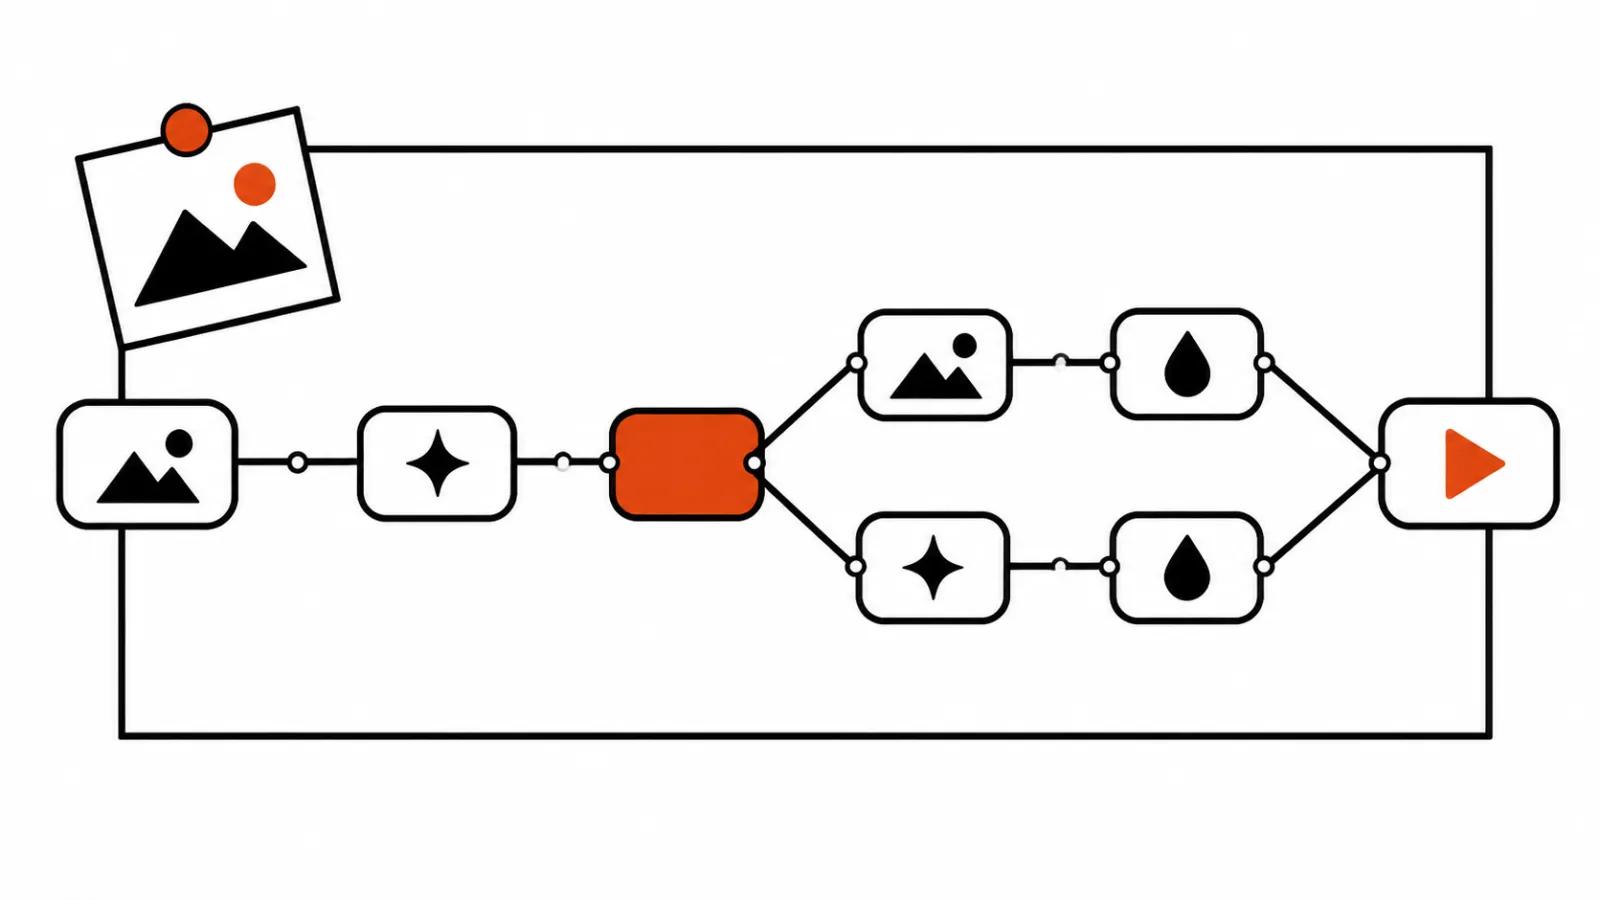
Ход простой и оттого интересный. Пиксели кадра переводятся в токены линейным patch embedding, а обратно в пиксели их превращает свёрточная голова, авторы называют её detailer head. VAE из схемы выпадает целиком, декодер тоже.
Второе решение касается обучения. Обычно модель предсказывает скорость, то есть направление движения из шума к картинке. Здесь модель предсказывает сразу чистое видео, а шум сдвигается сильнее. Авторы пишут, что без этой пары приёмов качество не собирается. Практический смысл: пиксельный режим требует другой математики, выкинуть VAE из готовой модели и получить хороший кадр не выйдет.
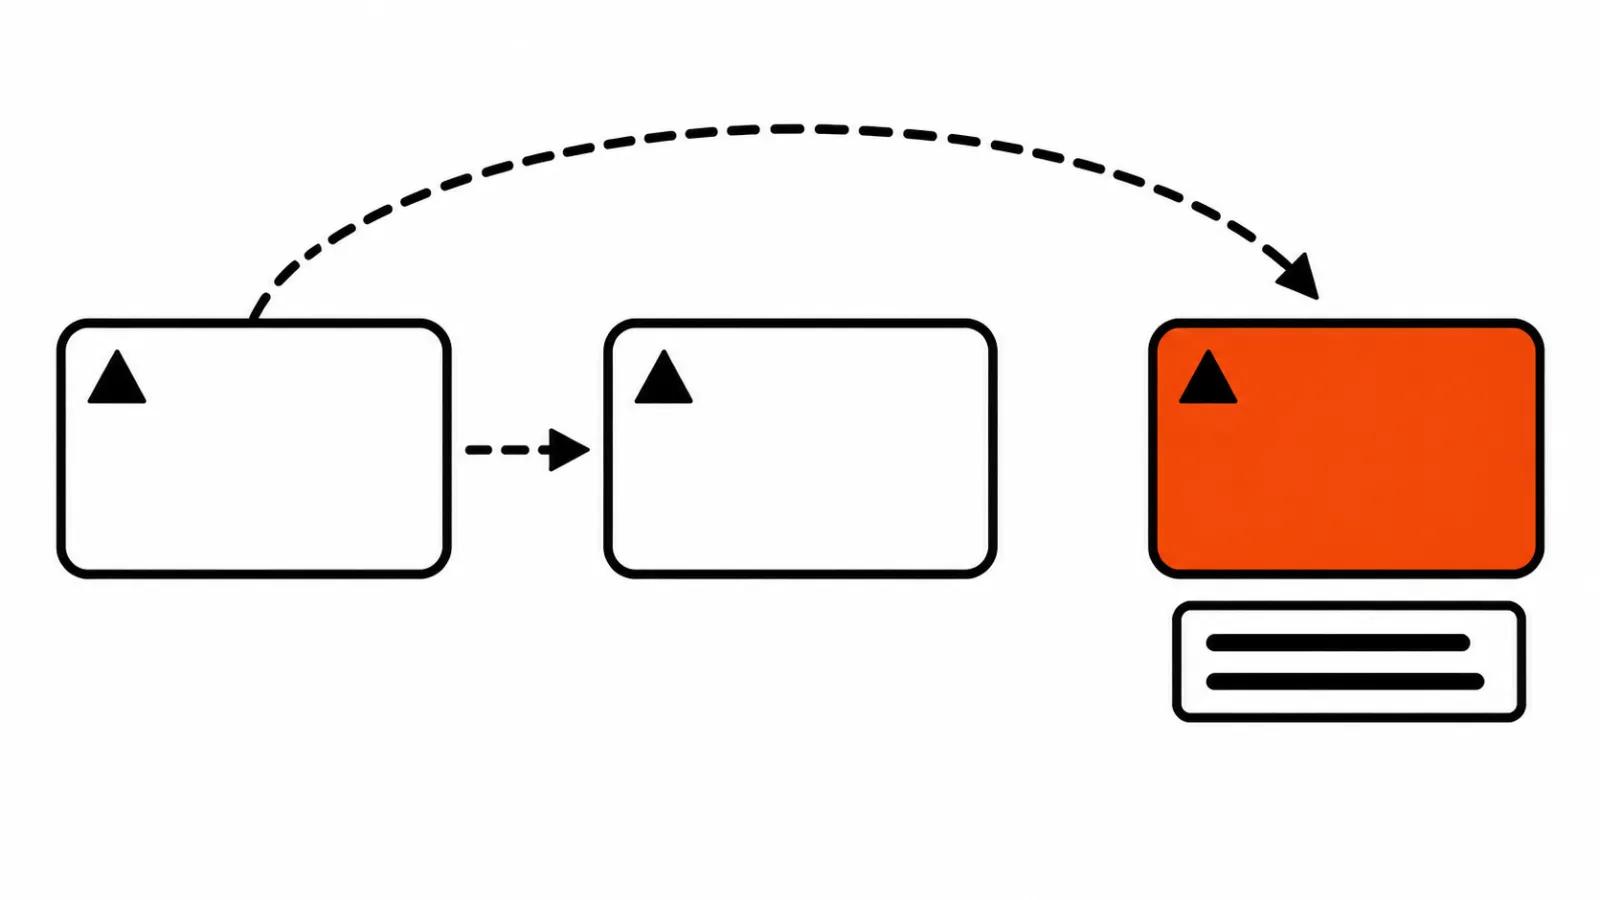
Третье решение про время. Все свёртки в голове причинные, окно в три кадра: кадр t читает только кадры t-2, t-1 и t. В голове кеш на два предыдущих кадра, поэтому кадр собирается сразу, как только готовы его токены, без ожидания блока.
Сгенерировать видео в 1664×960 при том же числе токенов
Сетка токенов остаётся 30×52, как у 832×480, зато сам токен крупнее: 32×32 пикселя вместо 16×16. Тот же объём вычислений, вдвое больше точек в кадре. Компромисс очевиден: крупный токен это более грубая сетка, и всю мелкую фактуру добирает детализирующая голова.
Модель дообучена из Wan2.1-14B. Сопоставимое с исходной латентной моделью качество авторы получают примерно за 20 тысяч итераций, в аннотации речь о 1,3 млн обучающих клипов. Это важная часть новости: пиксельный режим получен пересадкой готовой модели, без постройки новой с нуля.
Интерактив и монтаж: что меняется на практике
Про задержку есть конкретное число. Если модель сжимает время в 4 кадра, то на 30 fps каждый шаг фиксирует 4 кадра под одно действие, и это до 133 мс ожидания. Когда нейросеть генерирует видео блоками по одному кадру, действие отражается уже на следующем кадре. Для генерации по кнопке разница в сотню миллисекунд незаметна, для живой сцены, где камера слушается мыши, она решает.
Отдельно авторы отмечают редактирование по карте глубины. На быстром движении такая правка держится лучше, чем у латентного аналога. Рядом лежит похожая история: PI-H3 тоже убирает декодер и делает шаг в пикселях, только там упор на генерацию за два-четыре шага. Идея общая, реализации разные, и это хороший признак: направление проверяют сразу несколько команд.
Что тут не доказано и что дойдёт до заказчика
В аннотации нет числовых сравнений с базовой моделью и нет стоимости шага, на это обратил внимание AI Weekly. На странице проекта мы не нашли заявления о выкладке весов и кода. Значит на сегодня это исследование, и относиться к нему стоит как к исследованию.
Нашего опыта с этой моделью нет, руками мы её не запускали. Но направление практическое. Если подход приживётся, высокое разрешение перестанет стоить четыре раза дороже по вычислениям, а сцены, которые слушаются команд покадрово, станут реальными для рекламы и для интерактива. Когда нужно сгенерировать видео нейросетью под конкретную задачу, исход решает приёмка кадров человеком, и на длинных сериях это заметно сильнее, чем архитектура.
Мой вывод
Такие работы я читаю по одному критерию: снимает ли идея конкретный компромисс. Здесь снимает. Сжатие в латент было честной сделкой, скорость обучения в обмен на потолок по разрешению и по отзывчивости. PixVid показывает, что потолок можно поднять, оставив готовую модель, и это дешевле, чем кажется на первый взгляд.
Заказчику важнее следствие: 960p по цене 480p по вычислениям и живая сцена, которая отвечает на команду следующим кадром. Номер на arXiv ему не нужен. Продукта с этим подходом пока нет, и обещать его клиенту рано. Когда такие модели появятся в API, первый вопрос на проекте сместится к тому, кто отвечает за кадр на приёмке.