Kaggle открыла арену, где модели соревнуются кодом
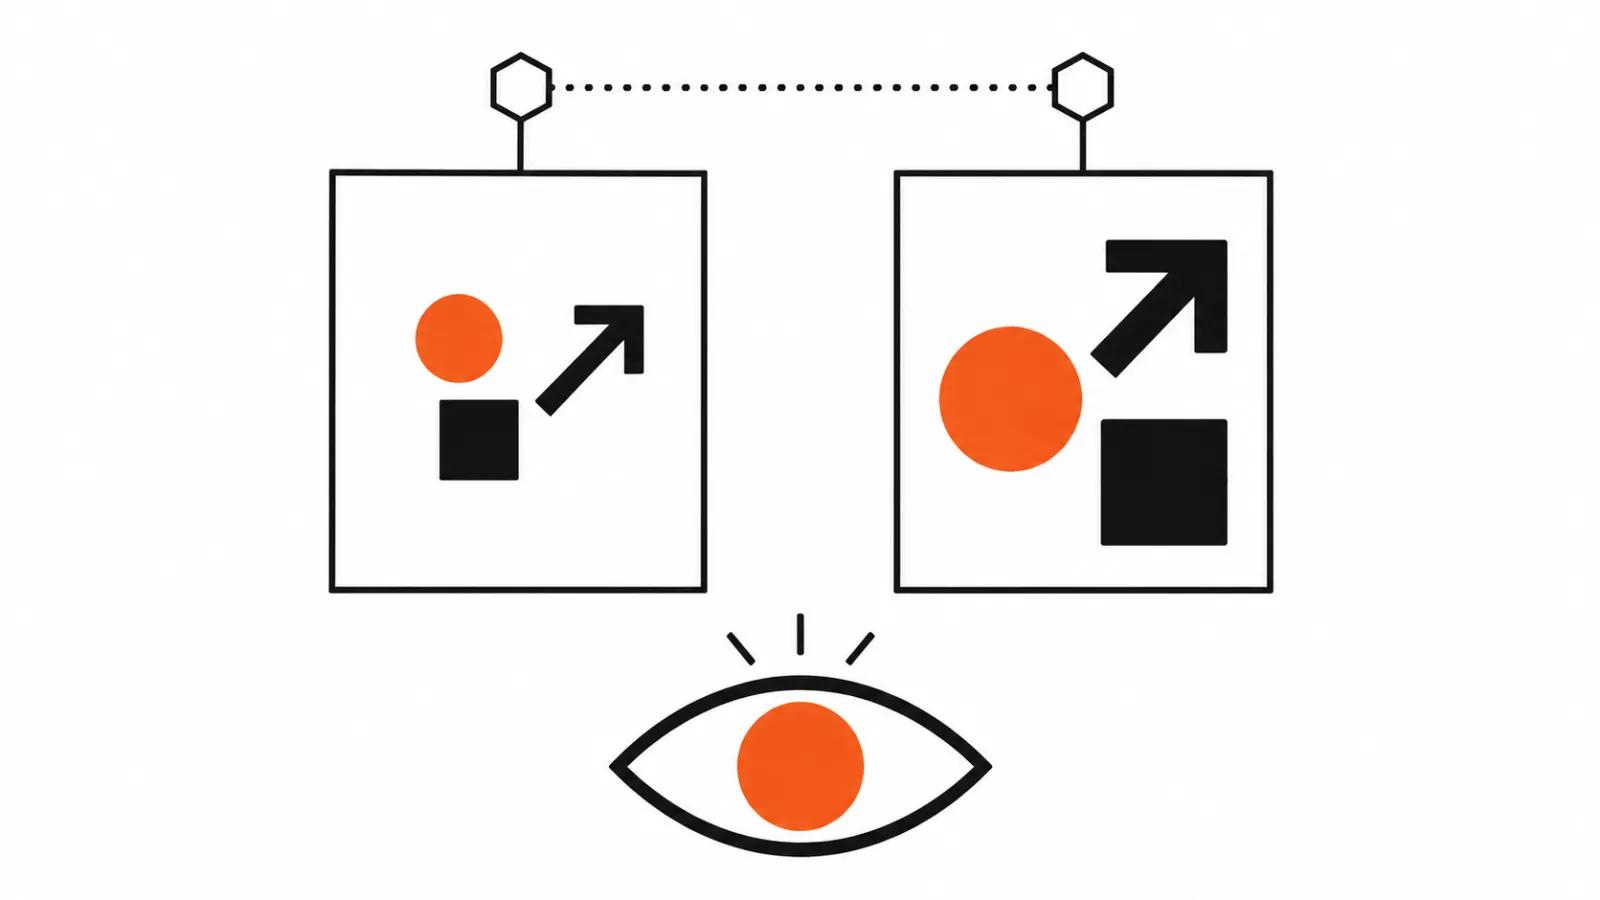
17 ноября Kaggle вместе с HeyGen и HyperFrames запустила Code2Video Arena. Механика простая. Две модели получают один и тот же бриф, пишут код моушн-графики, одна и та же система рендерит из этого два ролика. Дальше зритель смотрит пару A и B вслепую и выбирает тот, что лучше. Имена моделей показывают после голоса. Голоса обновляют рейтинг Elo по предпочтениям, то есть таблицу, которая двигается от каждого клика.
Мне эта конструкция нравится по деловой причине. Она меряет ровно то, что заказчик и так сравнивает руками: два ролика на один бриф, поставленные рядом на одном экране. Всё остальное в статье это следствия из этой механики.
Рейтинг нейросетей для моушн-графики: откуда берётся Elo
Elo это счёт, который растёт за победы и падает за поражения, причём победа над сильным соперником даёт больше, чем победа над слабым. Здесь такие пары складываются в живую таблицу: с каждой парой роликов шкала уточняется. Для заказчика важен один вывод. Позиция в такой таблице означает «чаще нравится людям на этих брифах». Про «умеет больше» такая таблица молчит.
Второй вывод тяжелее. Рейтинг отвечает на вопрос вкуса. Попадёт ли ролик в вашу задачу, бренд и срок, он не отвечает.
Что такое видео, написанное кодом
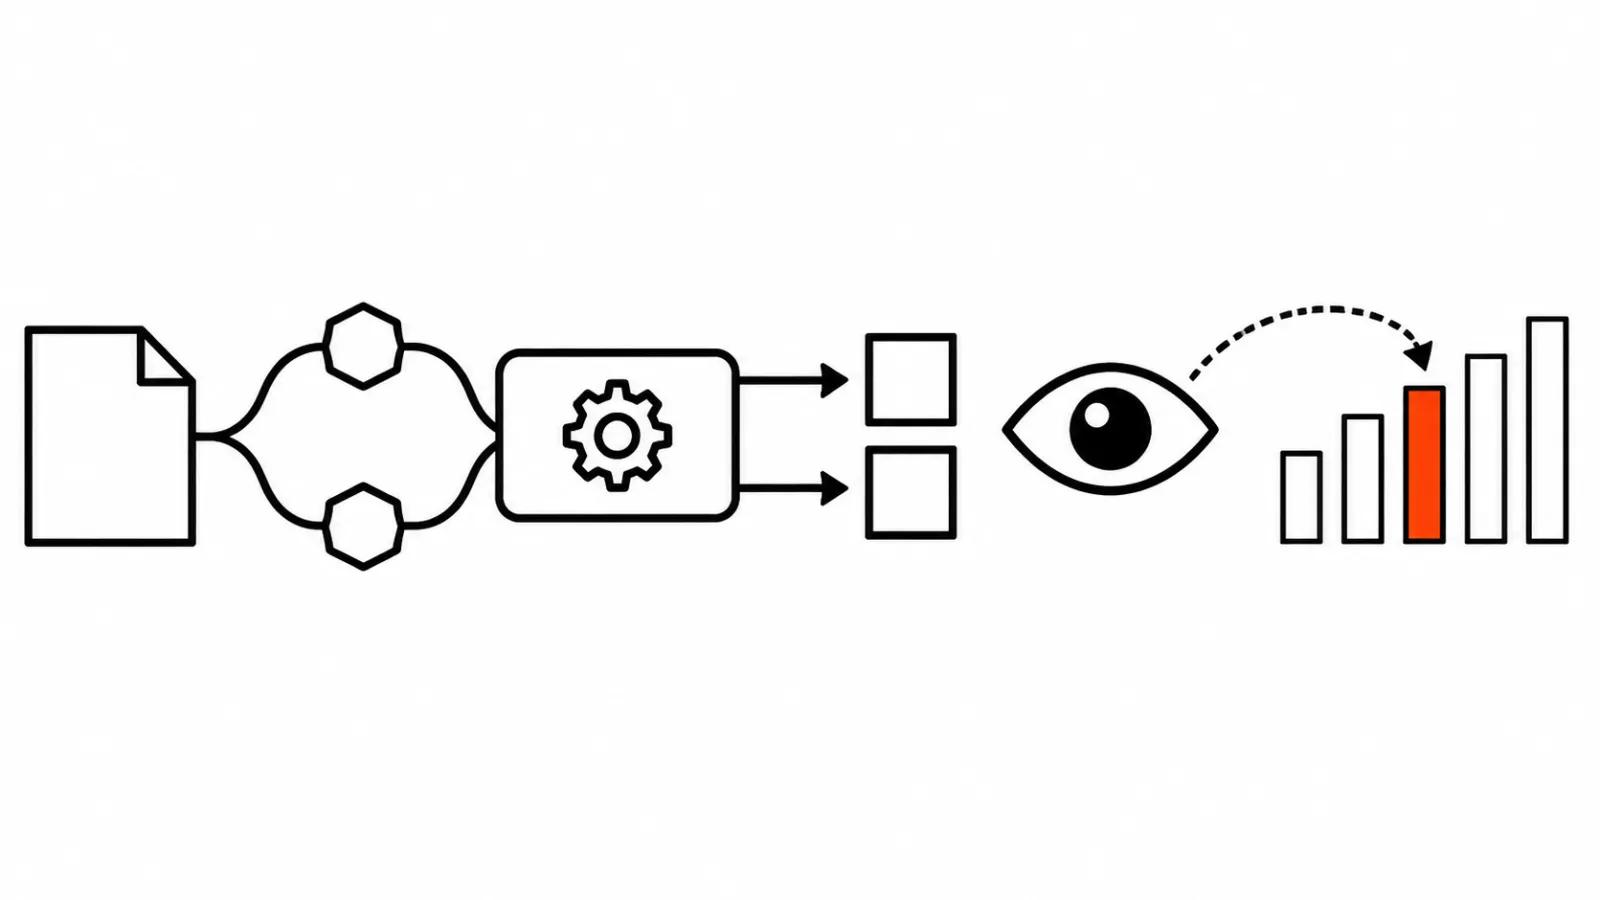
Модель получает бриф и системный запрос HeyGen за один вызов, без инструментов, и возвращает одну композицию HyperFrames. Внутри две части: HTML для вёрстки и GSAP для анимации. HyperFrames, открытый фреймворк HeyGen, детерминированно рендерит видео.
Слово «детерминированно» здесь главное. Каждый кадр считается из формул. Случайных вариантов из шума здесь нет. Поэтому текст остаётся текстом. Похожие буквы из генерации тут не появляются. Цвета берутся из палитры бренда. Подбор на глаз отменяется. Тайминг задаётся в миллисекундах. И если нужно поправить одну цифру, правят число в коде и перерендеривают: остальные кадры остаются прежними.
Для сравнения, диффузионная модель рисует каждый кадр заново, и повторный прогон даёт другой результат. Там правка одного слова в титре иногда означает новую генерацию всего кадра.
Сравнение нейросетей для видео: что показывает таблица на 18 ноября
На старте тройка такая:
Человеческие голоса поменяли порядок относительно прежнего автоматического рейтинга, где первым шёл Claude Opus 5.5. Это самая интересная строчка во всём релизе. Автоматическая оценка и вкус зрителя на одних и тех же работах разошлись, и арена показала это публично.
Есть и независимая реализация: Artificial Analysis собрала Code2Video-AA. В ней модели Qwen 3.8 Max, DeepSeek V4.1 Flash, Kimi K3 и GLM 5.3 держатся в пределах 50 пунктов Elo от первого места. Пятьдесят пунктов на такой шкале означают, что разрыв небольшой, и это отдельный аргумент в пользу открытых моделей для типовой графики.
Оговорка AlphaSignal, и я с ней согласен: тест охватывает кодовую моушн-графику. Диффузионное фотореалистичное видео в него не входит. Малые разрывы Elo могут быть шумом, поэтому смотреть надо на число голосов. Двадцать голосов и две тысячи голосов дают разную уверенность при одинаковой цифре.
- Gemini 4 Carbon (High)
- Claude Opus 5.5 (High)
- GPT-6 Astra (High)
Из чего собраны 168 брифов
Основа арены это HeyGen Code2Video Benchmark, его выпустили HeyGen вместе с Kaggle и Google DeepMind. Внутри 168 брифов по мотивам презентационных роликов продукта. Каждый бриф повторяет привычную структуру продающего объяснения: зацепка, проблема, продукт, функции, польза, социальное доказательство, призыв, финал. У каждого брифа есть ролик, снятый человеком, для сравнения.
Пять осей оценки: вовлечённость, соответствие замыслу, композиция, ритм во времени, качество исполнения. Мне такая разбивка кажется честнее одной общей оценки. Ролик может быть красивым и при этом не про то, что просили, или точным по смыслу и вялым по ритму.
Восемь блоков брифа стоит забрать себе как шаблон. Это готовый каркас для любого заказчика: сначала боль, потом продукт, потом доказательство и призыв.
Когда кодовая графика сильнее генерации
Цифры, цены, тарифы и графики. Интерфейсы и экраны приложения. Логотип и фирменные цвета. Пошаговые объяснялки со стрелками и подписями. Серии из двадцати версий, где меняется только оффер или язык: в коде это одна правка. Двадцать генераций с лотереей не нужны.
Обратная сторона тоже понятная. Живые люди, эмоции, съёмка продукта в руках, сложный свет и фотореалистичные сцены остаются за диффузионными моделями. Кодовая графика здесь не конкурент, и обещать клиенту фотореализм из HTML не стоит.
На практике выбор выглядит так. Рекламный ролик с оффером и ценой, пояснялка для сайта, вертикальные ролики под тесты креативов уходят в код. Атмосферные сцены с персонажем идут в генерацию. Инструмент выбирается под кадр.
Как читать рейтинг нейросетей без ошибок
Первое: смотреть число голосов рядом с позицией. Малая выборка двигает шкалу на десятки пунктов от одного зрителя.
Второе: читать разбивку по осям. Модель, которая берёт композицию и проваливает ритм, годится для статичных карточек и плохо годится для ролика с движением.
Третье: проверять на своём брифе. Один бриф из своей ниши, две модели, слепой выбор между двумя роликами. Это полчаса работы и точный ответ по вашей задаче.
Четвёртое: смотреть вторую реализацию. Совпадение верха в двух независимых таблицах говорит больше, чем одно первое место. Если же первое место в одной таблице и пятое в другой, вывод про универсального лидера отменяется.
Деталь для тех, кто заказывает ролики. Спрашивайте «на каких брифах модель лучшая и сколько там голосов». Вопрос «какая модель лучшая» без этого ничего не значит.
Вывод
Арена полезна как первый публичный замер кодовой графики, и я бы держал её в закладках. При этом смотреть на неё стоит ради формата: один бриф, две реализации, слепой выбор. Эту процедуру можно повторить на своём продукте на этой неделе, без всякой арены.
Второй вывод практический. Для рекламы с цифрами, интерфейсами и серией версий кодовая графика сейчас дешевле в правках, чем генерация. Для атмосферных сцен с людьми генерация остаётся сильнее. Смешивать оба подхода в одном ролике нормально: сцены с человеком из модели, титры, плашки и графики из кода.
Первую строчку Gemini 4 Carbon я бы пока читал как «на этих 168 брифах людям нравится чаще». Через месяц голосов станет больше, и порядок может снова поменяться. Это нормальное свойство живого рейтинга. Поводом откладывать решение это не становится.
Под такие задачи есть услуги: видео нейросетями и вертикальная реклама. Смежные материалы: рейтинг видео нейросетей; видео кодом.