Что выпустила HeyGen
Decision 1 это модель решений. Она смотрит готовый материал и выдаёт ответы: да, нет, категорию или балл. На входе три вещи. State с текстом или JSON, медиа в assets и список именованных вопросов. Имя возвращается в ответе, поэтому один запрос закрывает сразу десяток проверок: есть ли логотип в кадре, читается ли титр, попадает ли сцена в бриф.
Мне это интереснее очередного генератора. Поток роликов растёт быстрее, чем люди, которые их принимают, и узкое место давно переехало на приёмку. Модель, которая ставит оценку по моей рубрике, бьёт именно туда.
Как устроена нейросеть, которая смотрит видео
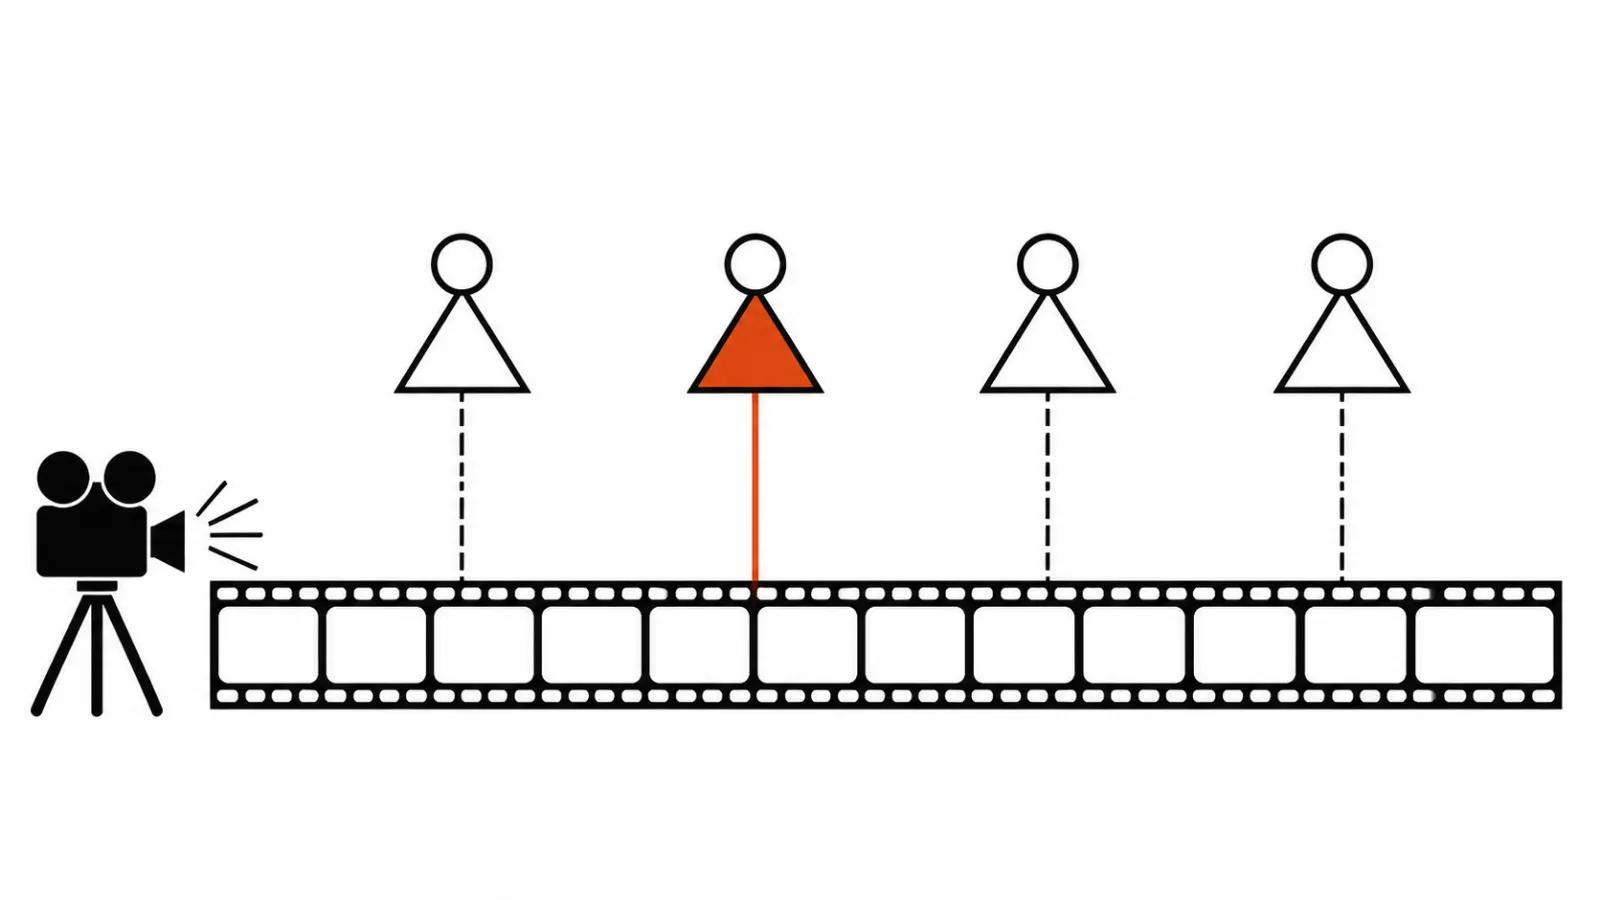
Медиа грузится в assets: до четырёх картинок и одно видео на запрос. Видео читается по выборке кадров, целиком оно в модель не помещается. Значит, монтажный брак на полсекунды может проскочить между выборками, и об этом стоит помнить, когда вопрос звучит как «есть ли склейка».
Звук до модели не доходит. Всё, что она знает о сказанном, лежит в state текстом. Нужно судить о реплике, транскрипт вставляют руками, иначе вопрос «обещает ли герой скидку» останется без ответа.
Отдельная деталь: URL внутри state модель читает как текст. Ссылку на файл она не откроет, медиа берётся только из assets. Кто привык кидать в запрос линк на облако, получит в ответ вежливое «вижу строку».
Три типа вопросов: да или нет, выбор, оценка
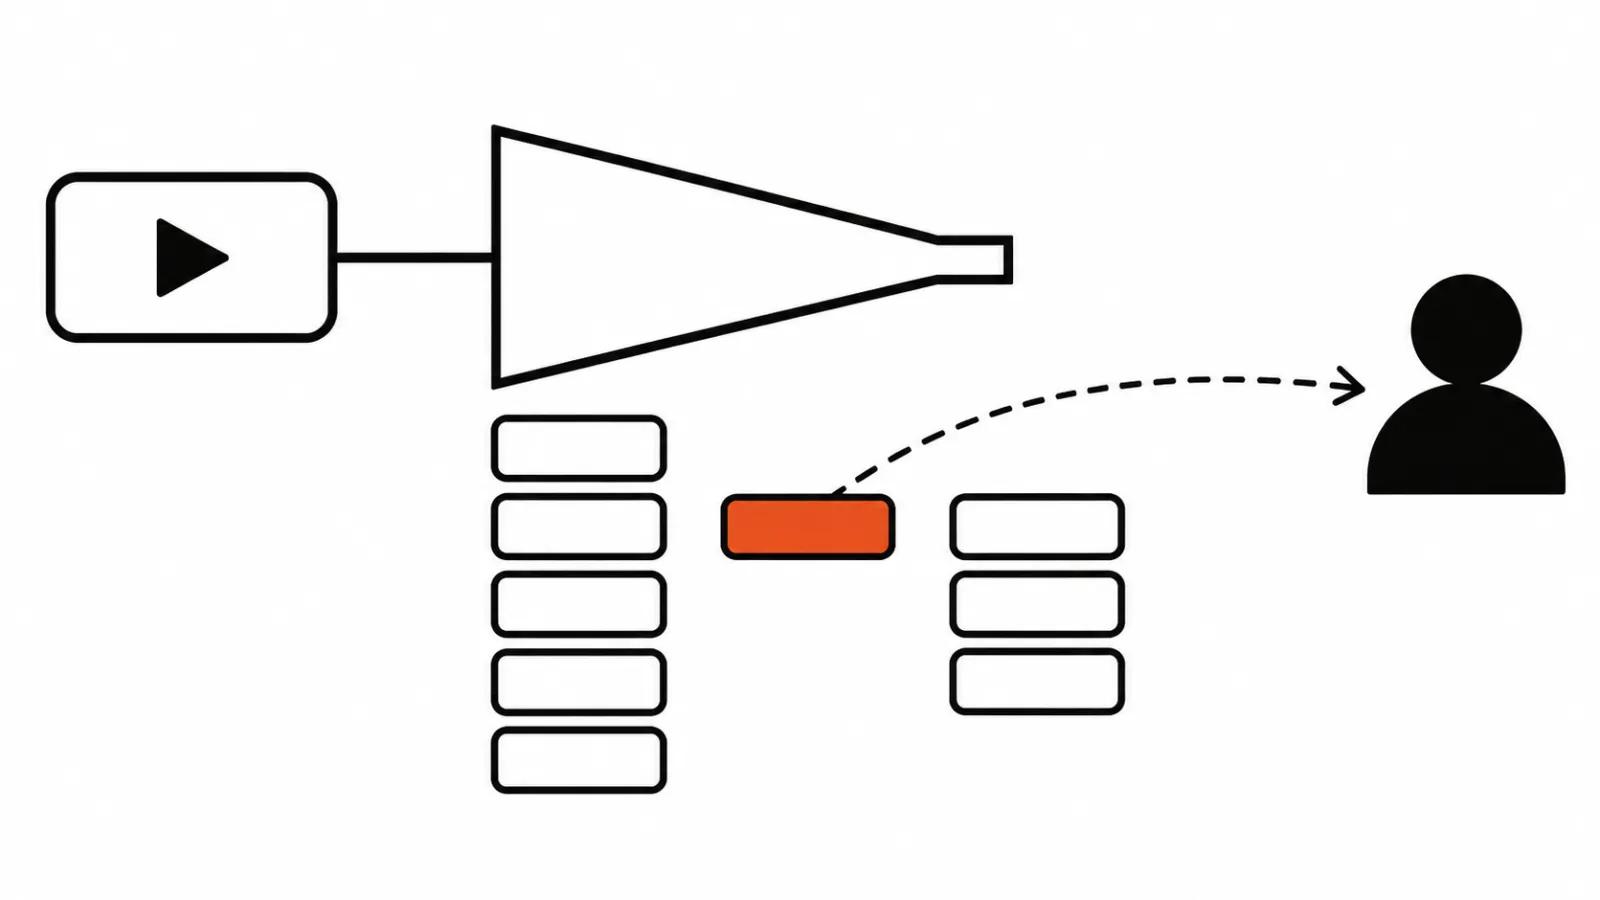
noul даёт да или нет и вероятность истинности от 0 до 1. choice выбирает категорию из заданных, возвращает вероятность для каждой и уверенность. score ставит балл по шкале, которую задаёт вызывающий.
Для choice и score критерии обязательны. Рубрику качества формулирует заказчик, HeyGen её только считает. Это важный сдвиг. Спорить о том, что считается браком, придётся до запроса, в тексте правил, пока ответа ещё нет.
В запросе от одного до 400 вопросов. Ответ синхронный: POST /v3/models/decisions, без опроса и без вебхуков. Для пачки роликов удобно, потому что цикл «отправил, получил, записал в таблицу» пишется в двадцать строк. Для длинной очереди неудобно, потому что запрос держит соединение.
Автоматическая приёмка роликов: первый фильтр потока
Мой сценарий простой. Двадцать вопросов по брифу, пять по бренду, ещё несколько на технический брак: обрезанная голова, титр за границей безопасной зоны, дёргающийся кадр. Модель прогоняет пачку и раскладывает ролики на три корзины: чисто, спорно, брак.
Дальше человек смотрит только спорное. Экономия не в уме модели. Редактор перестаёт тратить час на двадцать роликов, где решать нечего, и тратит его на те три, где решение правда нужно.
Второй сценарий ближе к каналам: проверка серии перед выкладкой на соответствие бренд-правилам. Модели две, heygen-decision-1 и heygen-decision-1-turbo в превью, turbo нужен там, где важен темп прогона. Ключ API требует scope assets:write, пробные ключи и OAuth не поддерживаются, так что доступ оформляют сразу рабочим.
Судья без звука и без цифр точности
Здесь главная претензия. HeyGen не публикует цифры точности, разбор Genativity от 16 ноября это подтверждает. Я знаю, что модель отвечает на вопросы, и не знаю, как часто она ошибается на моём типе материала.
Цены в документации тоже нет. Genativity пишет, что тарифы есть на OpenRouter; конкретные числа не называю, пока не проверил их на своём объёме. Для сметы это означает простую вещь: сначала считают стоимость на тестовой пачке в сотню роликов, потом решают, тянет ли поток.
Второе ограничение физическое. Звук модель не слышит. При этом половина брака в роликах звуковая: голос уехал, музыка громче реплики, тишина на стыке. Судья по кадрам такое пропустит.
Третье про уверенность. Вероятность 0.83 на вопрос «соответствует ли брифу» не означает «соответствует». Порог отсечки подбирают на своих данных, и для категории он будет другим, чем для балла.
Как я бы встроил это в конвейер
Порядок такой. Сначала рубрика: десять пунктов, каждый сформулирован так, чтобы человек поставил оценку вслепую и повторил её через день. Потом разметка: сто роликов вручную, прогон модели, сравнение. Смотрю, где расходятся. Чаще всего расхождение на субъективном: достаточно ли динамично, уместен ли тон.
Дальше порог. Если модель и я совпадаем на явном браке, её можно пускать в автоматический отказ без просмотра. На пограничных случаях решение остаётся за человеком.
И лог. Каждый ответ с вероятностью складываю в таблицу рядом с вердиктом редактора. Через месяц видно, на каких вопросах модель врёт систематически, и эти вопросы уходят из автоматики.
В потоковом производстве видео нейросетями ролики идут пачками, и приёмка там легко обходится дороже генерации. Когда речь о серии для канала, ведение YouTube-канала от 16 000 ₽ в месяц включает и отбор, и правки по бренду; судья ускоряет первый проход.
Мой вывод
Decision 1 полезна как первый фильтр и опасна как единственный судья. Я бы поставил её на входе очереди: отсеять явный брак и явное соответствие, спорное отдать человеку. Пока нет опубликованной точности и пока модель не слышит звук, финальная подпись под роликом остаётся за людьми.
Обратную задачу, что именно модель видит в кадре и где ошибается, мы разбирали в статье про то, как нейросеть анализирует видео. Про доступ к моделям HeyGen из чат-клиента был отдельный текст про HeyGen Video 1 в MCP.