Что именно показали
23 октября Джек Дорси опубликовал в X короткий пост про Dessa, а на сайте Block появилась страница с живыми записями разговоров. Время поста, 18:23 UTC, и страница block.xyz/dessa это всё, что компания выложила на старте: ни карточки модели, ни отчёта с метриками, ни цен.
Формулировка компании осторожная: «насколько нам известно, Dessa первый ИИ, с которым можно вести реалистичный живой разговор, обученный только на человеческой речи». Это заявление Block, внешнего подтверждения ему пока нет.
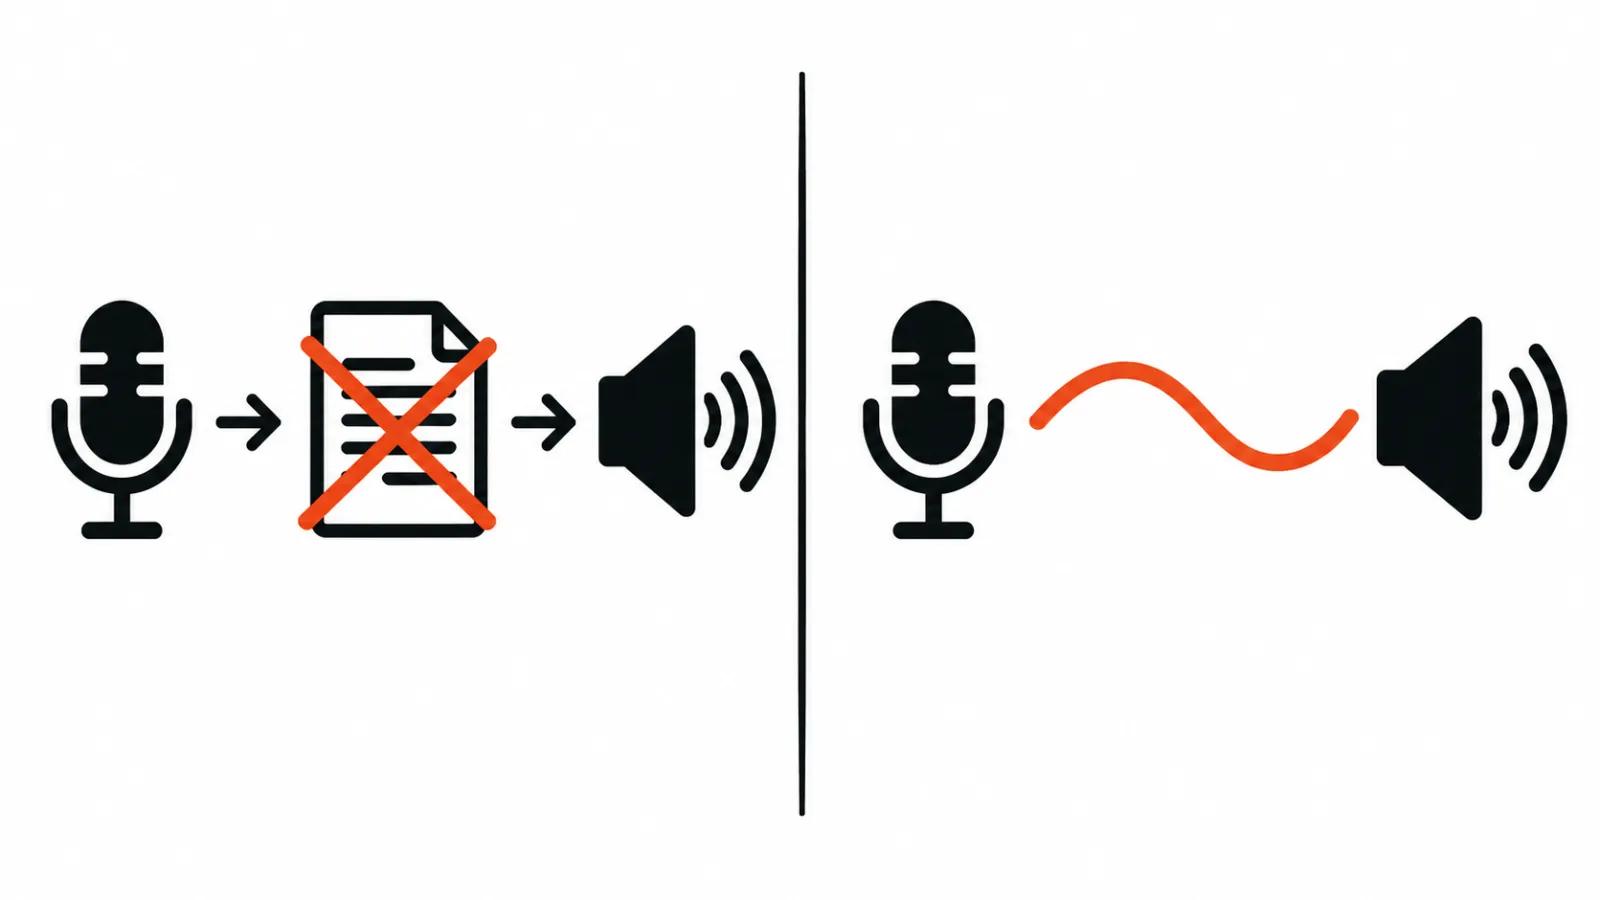
Что заявлено конкретно. Модель работает со звуком на входе и звуком на выходе, без преобразования в текст. Она работает в полном дуплексе: слушает и говорит одновременно, без ожидания своей очереди. Инференс идёт быстрее реального времени и запускается локально на MacBook Pro M4 Max или мощнее.
Речь как единственный источник данных
Главная странность проекта в том, чего в нём нет. Обычная голосовая модель собирается из трёх кусков: распознавание речи, языковая модель, синтез голоса. Dessa обучена с нуля только на человеческих разговорах. Ни текста, ни готовой языковой модели внутри нет.
Отсюда обещание, которое сложно проверить, но легко заметить в записях: модель слышит интонацию, сарказм, смех, вздох, дрожащий голос. В демо она смеётся посреди фразы, без команды после реплики, говорит громче, когда её просят, договаривает за человеком название фильма и вставляет короткие поддакивания в нужный момент.
В текстовом пайплайне всё это исчезает на первом шаге. Распознавание оставляет слова и теряет то, как они сказаны. Дальше языковая модель отвечает по смыслу, а синтез озвучивает ответ ровным голосом. Именно поэтому голосовые ассистенты звучат вежливо и одинаково, даже когда человек злится.
Почему отказ от текста дался дорого
Block пишет, что модель выучила язык на «сотни раз меньшем количестве слов», чем языковые модели. Сравнение не совсем честное, и компания это признаёт в скобках: LLM приходится учить заодно языки программирования и прочие странные вещи.
Дальше начинается настоящая сложность. Речь не повторяется. Одно и то же предложение, сказанное дважды, даёт разные данные: другая пауза, другая громкость, другой вдох. Слово в звуке занимает в тысячи раз больше байт, чем в тексте. Модели, у которой нет текстовой подсказки, приходится вытаскивать грамматику и факты из очень шумного сигнала.
Ещё одна деталь, которую стоит запомнить: Dessa обучили на одном NVIDIA GB200 NVL72. Это одна стойка с ускорителями, кластер на тысячи стоек не понадобился. Для исследовательской лаборатории внутри Block это способ показать, что направление не требует бюджета гиперскейлера.
Что это значит для озвучки видео
Озвучка видео нейросетью сегодня устроена просто: сценарий, синтез, при необходимости подгонка под губы. Dessa предлагает другой путь: интонацию задаёт сам разговор, без разметки в квадратных скобках. Для интервью, объясняющих роликов и диалоговых сцен это ближе к тому, как работают актёры.
Пока это не рабочий инструмент. Публичного API нет, цены нет, так что закладывать её в бюджет пока не на что. Компания открыла ранний доступ небольшой группе исследователей безопасности, которые должны найти риски, о которых Block не думала.
Для продакшна важнее другое. Если модель такого класса доедет до API, главной статьёй расходов станет стоимость правки. Сейчас переозвучить сцену с другой интонацией значит снова идти в студию или снова гонять синтез по тексту. Разговорная модель позволяет переписать реплику голосом и получить другой эмоциональный рисунок за один проход.
Где начинается риск
Синтетический голос, который слышит эмоцию, звучит убедительнее любого прежнего. Это же качество делает его удобным инструментом для обмана. Block это понимает и поэтому собирает внешних исследователей: компания прямо называет модель, которая научилась говорить только по звуку, новой территорией и просит внешних исследователей найти риски, которых команда не предусмотрела.
Второй риск бытовой. Голос, который поддакивает и смеётся в нужный момент, вызывает доверие быстрее, чем нейтральный. Для сервисов, где человек решает деньги или здоровье, это уже вопрос этики интерфейса.
Третий риск касается данных. Модель обучена на разговорах людей. Block не раскрывает, откуда эти записи и как получено согласие. До публикации технического отчёта этот вопрос остаётся открытым.
Кому это нужно раньше других
Первыми выигрывают те, кто делает диалоговые продукты: поддержка, обучение, тренажёры, игровые персонажи. Им нужно умение вовремя замолчать и вовремя вставить слово. Красивая озвучка здесь вторична.
В производстве роликов эффект придёт позже. Массовые вертикальные ролики держатся на скорости и объёме, там важнее стабильность шаблона, чем живая интонация. А вот ручные ролики с говорящим человеком или персонажем получают новый инструмент черновой озвучки: можно собрать сцену голосом, а потом решить, нужен ли актёр.
Есть и скучный сценарий, который мне кажется самым вероятным. Dessa останется исследовательским проектом на год, пока лаборатория пишет статьи и раздаёт доступ. Рынок озвучки за это время успеет встроить похожие функции в привычные сервисы, и разница сотрётся.
Что смотреть в ближайшие месяцы
Три вещи. Первая: появится ли технический отчёт с описанием данных и хоть какими-то замерами. Без него разговор о качестве идёт на уровне демо-записей, а демо всегда выбирает автор.
Вторая: появится ли API и по какой цене. Если Block отдаст модель разработчикам, её быстро встроят в редакторы и сервисы озвучки. Если оставит внутри продуктов Block, разговор останется теоретическим.
Третья: как поведёт себя модель на длинных разговорах. Для интервью, вебинара или урока этого мало, а удержание контекста без текста пока никем не измерено.
Почему я считаю это важнее очередной видеомодели
Каждый месяц выходит новая модель, которая двигает камеру и рисует руки. Dessa бьёт в другое место: она ставит под сомнение архитектуру, на которой стоит почти вся голосовая индустрия. Текст был удобен машинам. Людям удобнее звук. Если модель может обойтись без него и не потерять смысл, следующий шаг очевиден: интерфейсы начнут слушать. Читать их придётся реже.
Для студий и продакшнов это значит, что звук перестаёт быть финальной операцией после картинки. Он становится частью черновика, где решение принимается на слух. И к этому стоит готовиться заранее, даже если Dessa останется закрытой.