Что именно выложили
28 октября 2026 года, в 14:58 UTC, NVIDIA опубликовала в блоге на Hugging Face разбор Nemotron 3.5 Transcribe и набора данных Granary v2. Веса самой модели лежат на Hugging Face и ModelScope, там же доступен датасет.
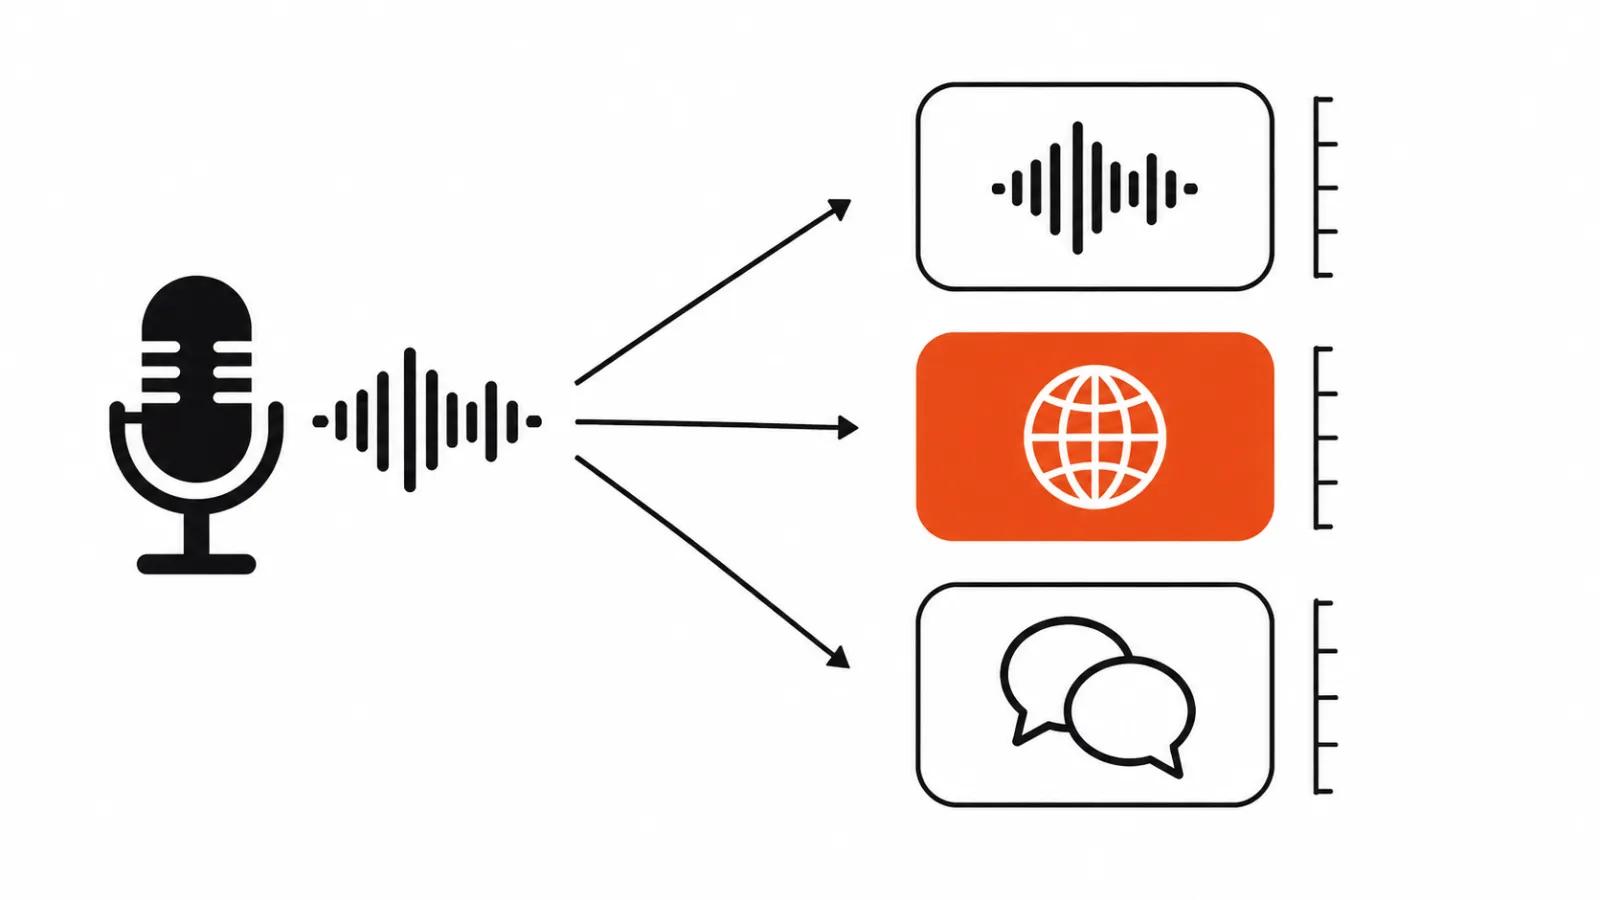
Формулировка из блога прямая: это открытая по весам модель, которой можно управлять текстовым промптом. Одна и та же контрольная точка закрывает четыре задачи: расшифровку речи, разметку спикеров, перевод и ответы на вопросы по аудио.
Для рынка это значит, что часть работы, за которую раньше платили по подписке, переезжает на собственное железо. Насколько удачно, зависит от цифр ниже.
Дальше характеристики. По описанию NVIDIA, модель расшифровывает 40 языков, переводит 31 из них в английский и обратно, размечает спикеров в 13 языках, держит записи длиной до часа и различает до восьми голосов.
Управление идёт обычным текстом: «расшифруй запись и подпиши каждого спикера», «переведи аудио на английский», «какие решения приняли на встрече». Разработчик может указать, где обрабатывается звук, и подсказать доменную лексику до обучения.
Слово в слово сценарий не повторяется от прогона к прогону, и это нормально для генеративной модели. Для монтажа важно другое: в ответе есть таймкоды на уровне слова, а значит, субтитры можно собирать сразу из выхода модели.
Цифры на лидербордах
Английский трек Hugging Face Open ASR Leaderboard: первое место среди открытых моделей, средний WER 5,33%. Мультиязычный трек: 4,62% на семи языках. Длинные записи: 10,98%. Все три цифры в блоге названы лучшими среди сопоставимых открытых моделей, и там же оговорка, что API-модели в сравнение не входят.
Artificial Analysis считает свой индекс AA-WER. У Transcribe 2,8%, и это делёж первого места среди открытых моделей при примерно 4 млрд активных параметров против 24 млрд у модели, с которой делёж. На подвыборке AA-AgentTalk, где записана речь голосовых агентов, у неё 1,8% против 2,3% у следующей открытой модели.
Архитектура объясняет скромный размер: речевой энкодер плюс гибридная Mamba-Transformer смесь экспертов, где из 30 млрд параметров на токен работает около 4 млрд.
Диаризация и длинные записи
Кто говорил и когда, для видео важнее самой расшифровки. На многоязычном лидерборде David AI по диаризации у Transcribe лучший результат из 14 систем: DER 18,26% на 21 языке, следом идёт отдельная Nemotron 3 Diarization с 18,38%.
В VoiceArena на английских полных сессиях у модели лучший cpWER, 32,4% из 14 систем, и меньше всего потерянных слов: 8,32% удалений против медианы около 31%.
Механика простая и в блоге описана честно: подсказки спикеров от Sortformer приходят в языковую модель вместе с акустикой, поэтому метка ставится во время генерации, без отдельного прохода после неё. Именно поэтому пересекающиеся реплики не рассыпаются на безымянные куски.
Данные Granary v2
За моделью стоит датасет. Granary v2 собирали в NVIDIA NeMo Curator, публичный манифест покрывает 463 062 часа в 48 языках из 16 корпусов. В первой версии было 25 языков, и это единственный прирост, который компания называет прямо.
Пайплайн выдаёт три формы транскрипта для каждой записи: дословную, нормализованную и чистую. Плюс короткие описания аудио, восстановление заимствованных слов при переключении кода, пары «вопрос-ответ» по звуку и переводы с автоматической оценкой качества.
Отдельно про адаптацию. В медицинском кейсе дообучение снизило WER на отложенных спикерах на 45,8% относительно лучшего промпта. Это не гарантия для других доменов, но порядок величин понятен: промпт даёт меньше, чем несколько часов своей разметки.
Скорость и локальный запуск
В бенчмарке модель обработала 100 часов аудио меньше чем за три минуты на одной карте RTX PRO 6000 Blackwell, на грядущей квантованной версии NVFP4 и на 30-секундных клипах при высокой параллельности. Это лабораторные условия, и в блоге они названы именно так.
Квантованные версии обещают позже, вместе с локальным запуском через NeMo-Speech.cpp. Сегодня доступен чекпоинт для vLLM. Отдельная оговорка: модель сделана для записанного аудио, потоковый режим не заявлен.
Где модель ошибается
Сама NVIDIA просит проверять имена, смену спикеров и ответы по записи. Это не формальность: диаризация ошибается на перекрывающейся речи, а ответы на вопросы по аудио обучены только на английском, и в других языках качество другое.
Ещё две вещи стоит держать в голове. Поддержка языков зависит от задачи, полной матрицы «язык на задачу» в блоге нет, она в карточке модели. И открытые веса не означают бесплатное коммерческое использование, лицензию нужно читать отдельно.
Что это меняет в производстве видео
Первый сценарий очевидный: субтитры и таймкоды для интервью, лекций и подкастов. Раньше это был внешний сервис с оплатой за минуты, теперь можно держать модель рядом с монтажом и не отправлять чужие записи наружу.
Второй сценарий про объём. Когда видео нейросетями делают пачками, расшифровка нужна для каждой версии, и цена за минуту начинает решать. Локальный прогон убирает этот счёт.
Диаризация в интервью и круглых столах решает вопрос, кому принадлежит реплика, и это экономит часы разметки, а ручные ролики с актёром в такой разметке не нуждаются: голос и так известен.
Ведение YouTube-канала на длинных выпусках получает из модели готовые таймкоды для глав и нарезки коротких фрагментов. Проверять всё равно придётся: имена, термины и границы реплик.
Вывод
NVIDIA выложила рабочую модель с честными цифрами и с оговорками, которые обычно прячут в сносках. Для производственной команды это повод пересчитать, сколько стоит расшифровка в месяц и что мешает держать её внутри.
Мой практический совет простой. Возьмите один свой ролик с шумом, пересечением речи и терминами, прогоните модель и сравните с тем, что вы получаете сейчас. Если разница в ошибке в пределах пары процентов, локальный вариант окупается на объёме. Если хуже, оставьте облако для сложных записей и локальную модель для простых.