Что выложила команда Efficient-Large-Model
30 октября 2026 года на Hugging Face появились веса Open-H3-Regenerate-2K. Авторы это команда Efficient-Large-Model, в ней работают исследователи NVIDIA и MIT. Код открыт в репозитории NVlabs/Sana, там же лежит обвязка для запуска.
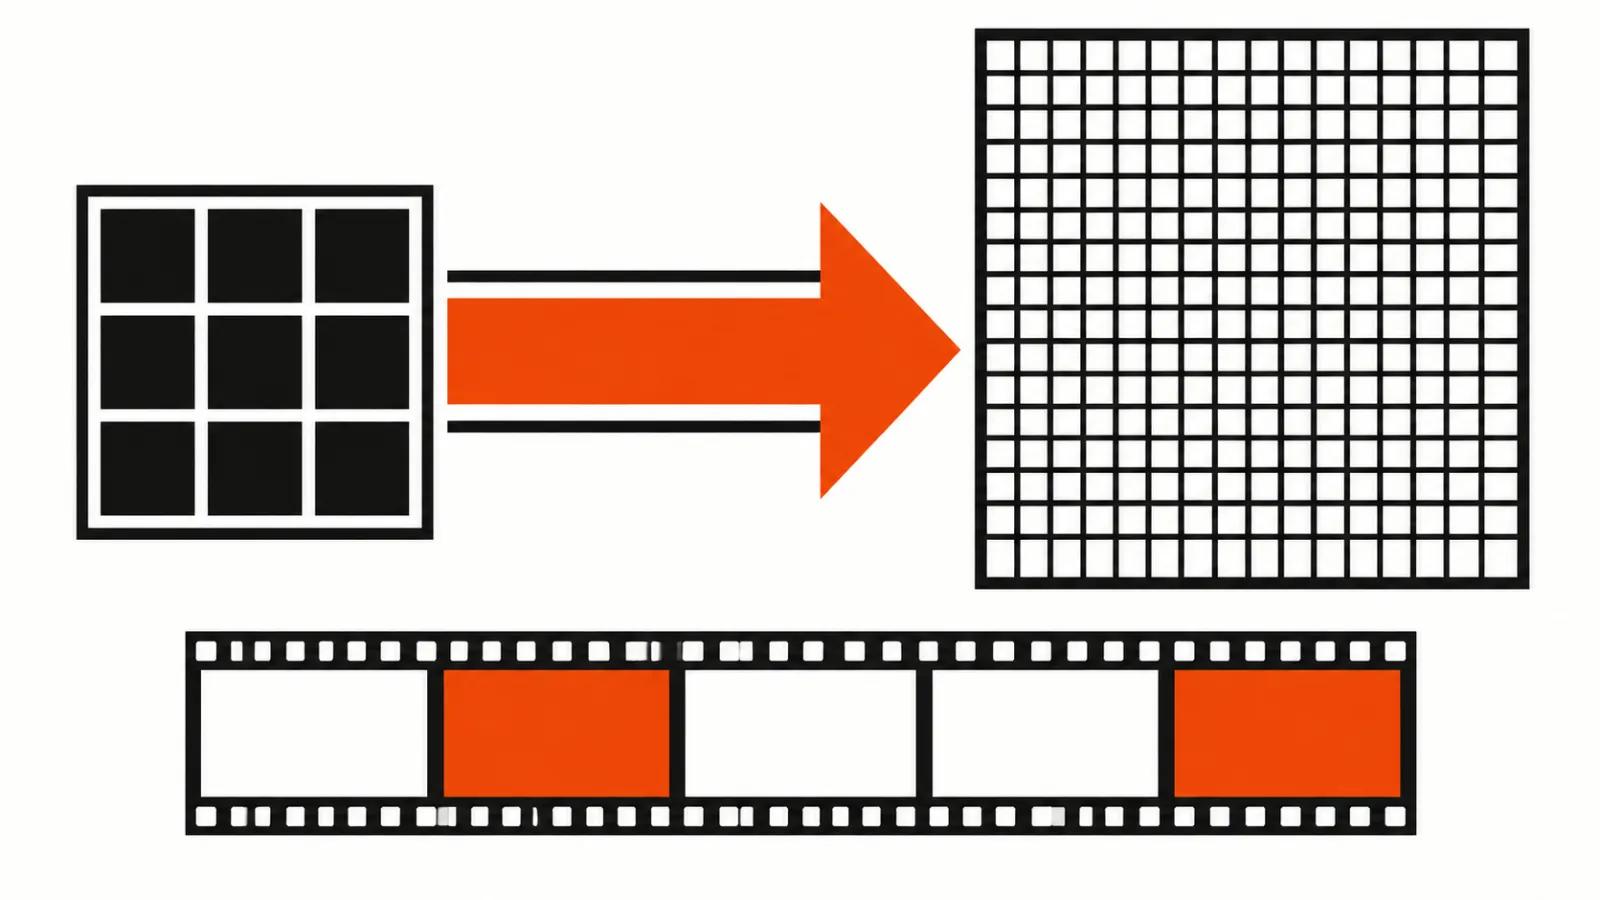
Название описывает задачу точно. Regenerate значит «перегенерировать»: на вход идёт готовый черновик MiniMax H3 в низком разрешении, на выходе получается тот же кадр в большем размере. Модель не рисует сцену с нуля. Она достраивает детали в уже существующем движении, поэтому композиция и тайминг остаются такими, какими их задал дешёвый проход.
Выходных разрешений два: 2560×1440 и нативные 3840×2160. Второе значение и есть та самая цифра 4K в названии.
Как увеличить разрешение видео нейросетью за три шага денойзинга
Обучается только refinement-LoRA. Бэкбон и VAE заморожены, поэтому адаптер получается лёгким, а веса основной модели остаются нетронутыми. На инференсе это ничего не экономит: полная модель всё равно грузится в память, зато тренировка укладывается в разумный бюджет.
Дальше работают оптимизации из LightX2V FL2VA Turbo и сэмплер LMS Sharp. Шагов денойзинга три. Обычный цикл апскейла идёт десятками шагов, здесь основная работа лежит на обученном адаптере, поэтому цикл короткий.
Для практики это значит одну вещь: рефайнер не требует переобучения под новую сцену. Замороженные бэкбон и VAE описывают ту же картинку, что и генератор, а адаптер отвечает только за достройку деталей.
Скорость на одной B200: 22,45 секунды против 87,26
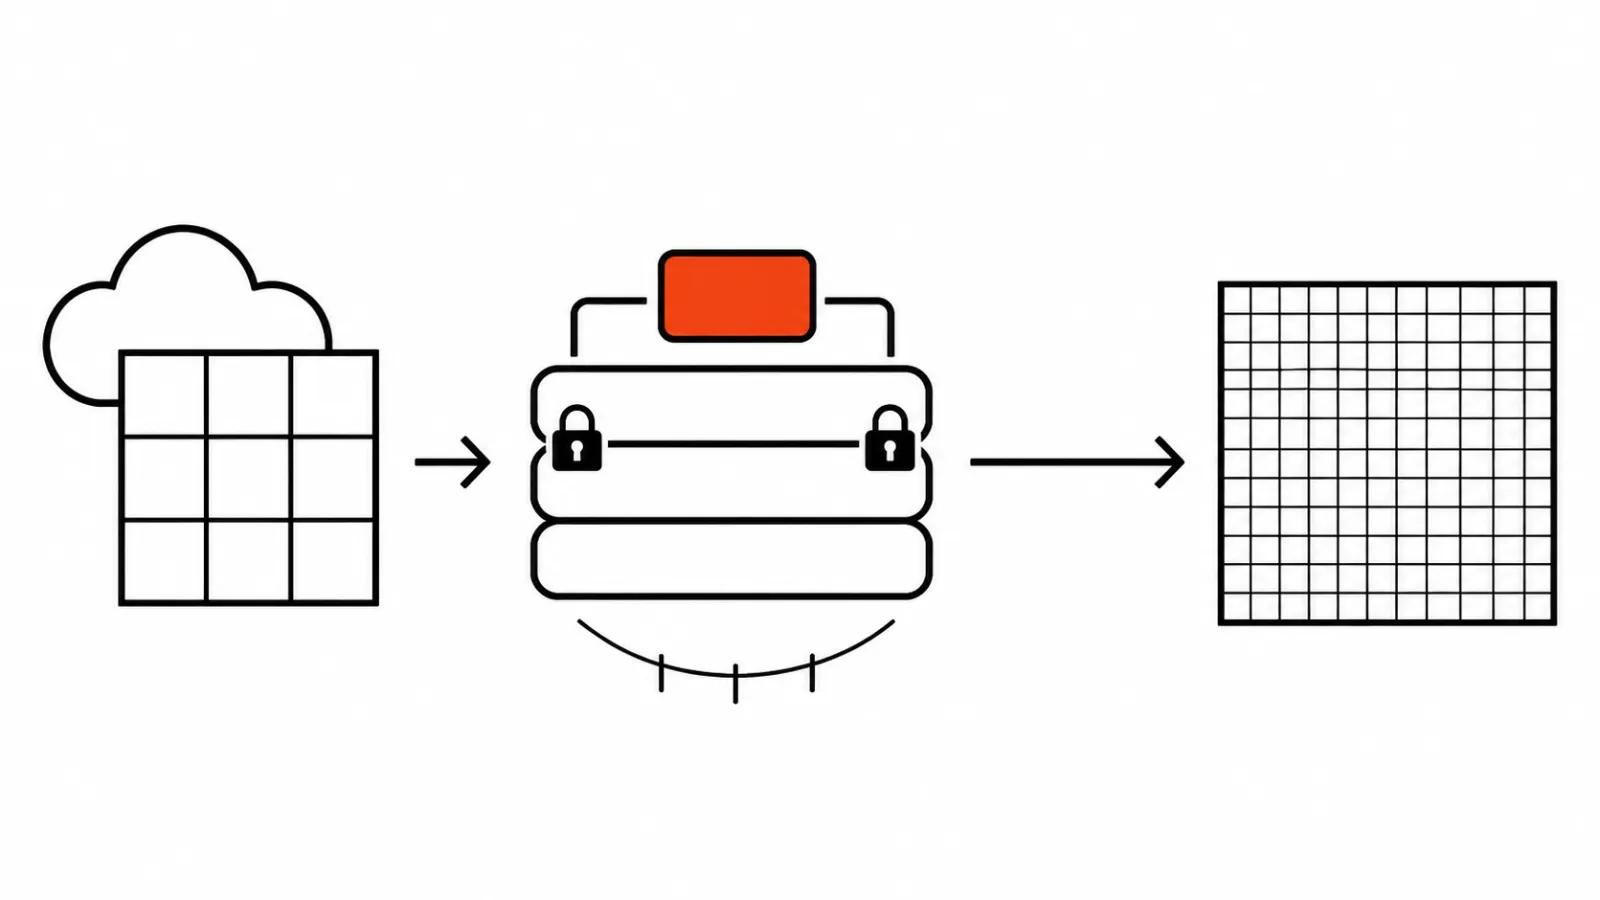
Замер сделан на одной карте B200. Видео около пяти секунд обрабатывается за 22,45 секунды, без оптимизаций тот же кадр шёл 87,26 секунды. Ускорение 3,9x.
Отдельная строка про декодер: быстрое декодирование сокращает этот этап примерно с 15 секунд до 1,6. В сумме на ролик из десяти сцен уходит около четырёх минут только на рефайн, и это уже величина, с которой можно планировать смену.
Оговорка по цифре. Замер сделан на одной B200, длина ролика около пяти секунд, на другой карте и на другом черновике время поедет. Я бы считал 22,45 как нижнюю границу для облачного инстанса и не ждал такой же скорости на домашней сборке.
Апскейл видео против официального API: RefinerBench-150
Метрика UniPercept на наборе RefinerBench-150 даёт 60,0 у открытой модели против 53,4 у официального API H3-Regenerate-2K.
Цифру я читаю как «детали и текстуры достраиваются плотнее». Авторы честно пишут, что официальный API всё ещё немного лучше по плавности движения и динамике. На статичном кадре открытая сборка выигрывает, в быстрых сценах платный сервис держит движение ровнее. Для рекламных роликов с бегом и панорамами это существенно, для говорящей головы и интерьеров разница почти не видна.
UniPercept это агрегат из нескольких оценок, и один общий балл скрывает, где именно набежало преимущество. Пока не появятся разборы по сценам, к разнице в 6,6 балла я отношусь как к сигналу.
Улучшение качества видео нейросетью: где заканчивался открытый стек
Контекст важен. У MiniMax H3 модуль высокого разрешения был закрытым: черновик доступен, финальный проход нет. У Pika H3 Flex 4K-финал жил только в платном API, об этом мы писали, когда вышли веса Flex. Практически весь открытый пайплайн упирался в последний шаг, и его приходилось покупать у вендора.
Теперь финальный проход есть в открытых весах. Связка «дешёвый черновик 768p плюс открытый апскейл» закрывает дыру, которая держалась полгода. Картина меняется: улучшение качества видео нейросетью перестало быть платной функцией вендора и стало операцией, которую можно посчитать в часах GPU. Если нужен общий разбор методов и их ограничений, у нас есть отдельный материал на эту тему.
Кому это нужно на практике
Главное ограничение это карта. B200 дорогая железка, почти всегда это облачный инстанс по часам, и домашняя 4090 такой режим по памяти не вытянет.
Второе ограничение это экономика. Открытые веса дают контроль и отсутствие оплаты за вызов, а платить всё равно приходится за GPU-часы. Для серии из сотни роликов в месяц аренда B200 на несколько часов может выйти дороже, чем оплата API по кадрам. Считать надо на своём объёме, я бы начал с одного часа аренды и двадцати кадров.
Третье ограничение это целевое разрешение. Если ролик идёт в вертикальную ленту на 1080p, нативный 4K не даёт ничего, кроме веса файла. В таких проектах я бы оставил черновик в 768p и отдал бюджет людям: ручные ролики от 16 000 ₽ решают задачу там, где в кадре нужен живой человек и точная речь.
Мой вывод
Я бы не переводил пайплайн на это в первый день, но и откладывать не стал бы. Действия простые.
Первое: взять облачный час на B200 и прогнать двадцать своих кадров через открытый рефайнер и через официальный API.
Второе: смотреть на быстрые сцены. Именно там API пока держит преимущество, и именно там решается, годится ли финал для эфира.
Третье: посчитать цену часа против цены тысячи кадров у вендора и держать оба пути в рабочем состоянии.
Смысл релиза в другом. Открытый стек по видео дорос до последнего шага: черновик, апскейл и монтаж теперь собираются целиком на своих весах. Это меняет переговорную позицию против закрытых API, даже если конкретная студия продолжит платить за вызовы.