Что просят, когда ищут промпты для ИИ видео
По нашему семантическому ядру у фразы «промты для ии видео» 116 точных запросов в месяц, у «промты для нейросети для видео» 107, у «промт для ии для создания видео» 90. Ещё 87 запросов идут с уточнением «примеры», а 61 человек просит готовые промпты. Люди хотят формулу, по которой запрос пишется сегодня и даёт предсказуемый кадр.
Проблема в том, что генератор не читает мысли. Он разбирает текст на признаки: что в кадре, что происходит, откуда снимают, чем светят, в каком жанре. Если половины признаков нет, модель подставляет свои, и вы получаете усреднённую картинку из обучающих данных.
Дальше я разбираю запрос по слотам. Это скучнее, чем искать «лучшие промпты», и работает быстрее.
Пять слотов: камера, субъект, действие, контекст, стиль
Google в практическом руководстве по Veo 3.1 предлагает собирать запрос из пяти частей: операторское решение, субъект, действие, контекст, стиль и атмосфера (руководство Google Cloud (https://cloud.google.com/blog/products/ai-machine-learning/ultimate-prompting-guide-for-veo-3-1)). Страница DeepMind перечисляет те же элементы иначе: кадрирование и движение камеры, стиль, свет, описание персонажа, локация, действие, диалог (гайд DeepMind (https://deepmind.google/models/veo/prompt-guide/)).
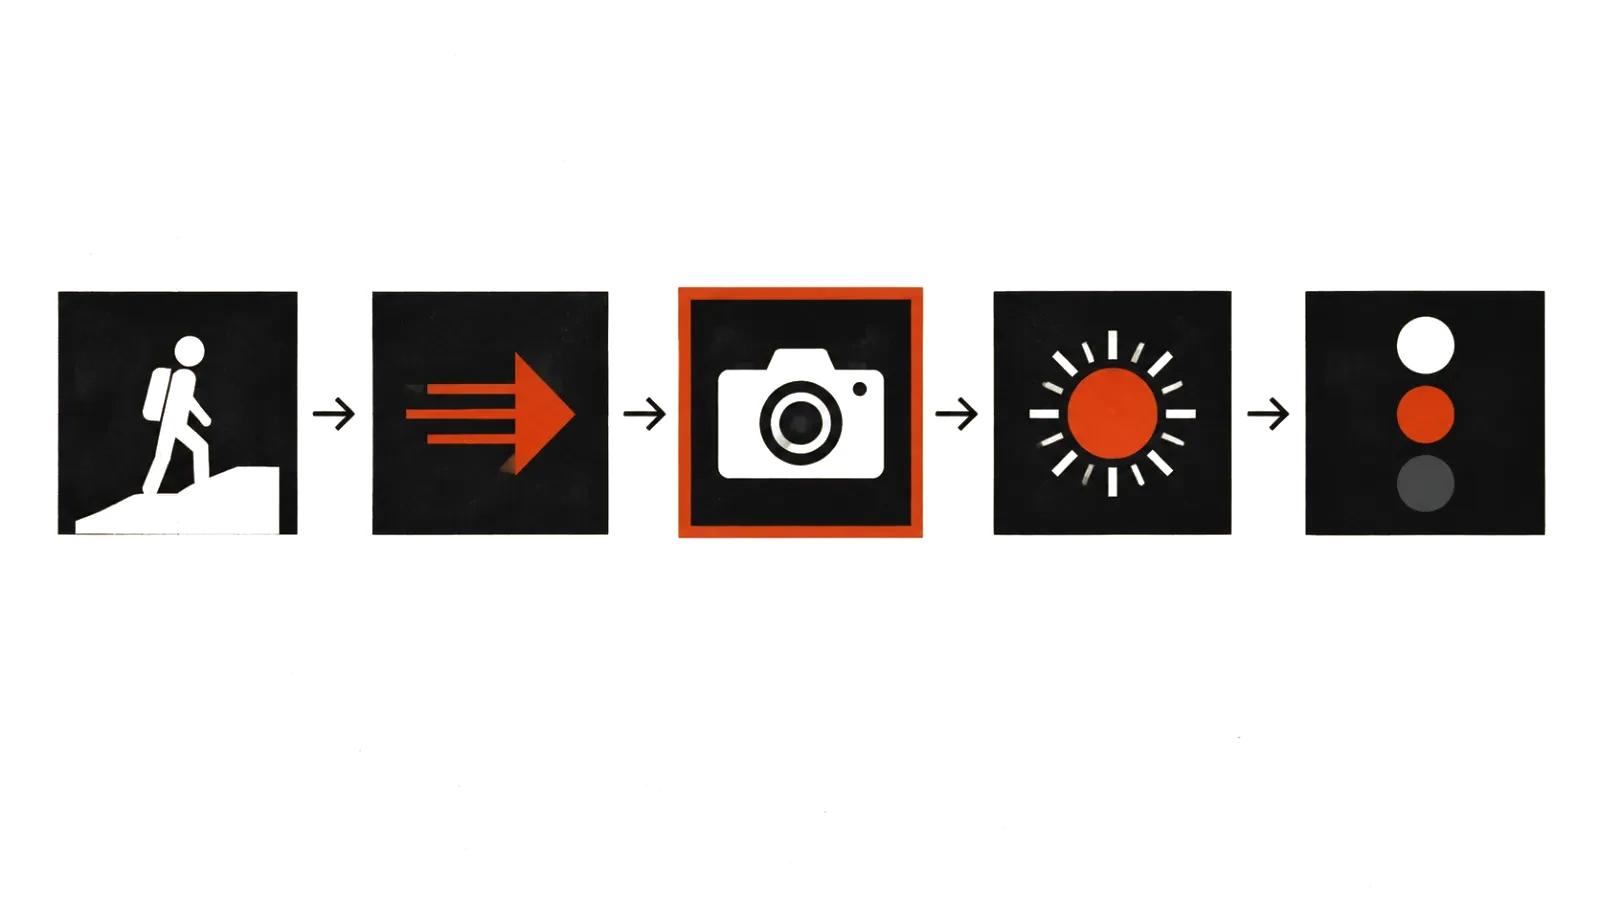
Практический вывод: пять слотов закрывают почти любой замысел. Сначала тип кадра и движение, потом кто в кадре, потом что он делает, потом где это происходит, потом как это снято и каким светом.
Пример на одном слоте. «Мужчина варит кофе» это субъект и действие, но не сцена. «Крупный план, мужчина в фартуке варит кофе на тесной кухне, утренний свет из окна слева, ручная камера» уже похоже на задание для оператора.
Камера и свет: словарь, который модель понимает
Модели обучены на описаниях из сценариев и раскадровок, поэтому стандартные термины работают лучше эпитетов. Крупный план, средний план, общий план, нижний ракурс, верхний ракурс, панорама, наезд, слежение. В гайде DeepMind прямо приведены примеры вроде нижнего ракурса и панорамы по сцене (prompt guide (https://deepmind.google/models/veo/prompt-guide/)).
Одно движение на кадр. Если в запросе одновременно панорама, наезд и облёт, модель выберет одно и добавит своё. Для восьмисекундного клипа этого хватает.
Свет описывается источником и характером. Настроение из этого следует само. «Золотой час», «рассеянный свет пасмурного дня», «жёсткий свет одной лампы справа», «свет из окна, мягкие тени». Слово «кинематографично» без этих деталей ничего не задаёт: у каждого генератора своё представление о кино.
Стиль задаётся материалом. Плёнка 35 мм, цифровая камера, VHS, стоп-моушен, пластилиновая анимация. В том же гайде DeepMind стиль перечислен отдельным пунктом, и это правильно: он влияет на всё остальное, включая движение.
Движение: сколько секунд выдержит сцена
Длительность решает, что успеет произойти. У Veo 3.1 клип длится 4, 6 или 8 секунд, соотношение сторон 16:9 или 9:16 (документация Gemini API (https://ai.google.dev/gemini-api/docs/veo)). У Kling 3.0 диапазон шире, от 3 до 15 секунд, разрешение до 4K (карта возможностей Kling (https://kling.ai/document-api/guides/capability-map/video)).
Отсюда правило: одно действие на клип. Человек садится в машину и трогается это два клипа. Если в промпте три события подряд, модель либо растянет первое на весь отрезок, либо склеит их рывком.
Движение внутри кадра тоже считается. Шаг, поворот головы, жест рукой, открывающаяся дверь. Медленное движение читается лучше быстрого: у быстрого меньше кадров на действие и больше артефактов.
Негативный промпт без слова нет
В руководстве Google Cloud есть неочевидный совет: избегать слов «нет» и «не показывай», потому что модель читает их как часть сцены. Запрет заменяют перечислением нежелательных объектов: «wall, frame», то есть стена и рамка (prompt guide (https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/video/video-gen-prompt-guide)).
На практике это выглядит так. Фразу «без людей и без машин» заменяют списком «crowd, vehicles, traffic». Запрет размытия записывают как «motion blur, soft focus». Список объектов работает как фильтр, а отрицание сбивает модель.
Второй приём: убирать причину. Если в кадре появляется лишний предмет, часто виновата фраза, которая его подразумевает. «Офис» тянет столы, стулья и ноутбуки. «Пустая комната с одним окном» оставляет меньше вариантов.
Примеры до и после
Три пары из моей практики. Разница только в слотах, идея одна и та же.
Готовые промпты из чужих подборок стоит читать как образцы структуры. Копировать их в свой проект бессмысленно: у другой модели другой словарь и другие ограничения по длине.
- Было: «красивый город ночью». Стало: «средний план, мокрая улица после дождя, неоновая вывеска отражается в луже, камера медленно едет вправо, ночь, холодный свет витрин». Что изменилось: появились кадр, движение, свет и материал поверхности.
- Было: «девушка идёт по полю». Стало: «общий план, женщина в летнем платье идёт по пшеничному полю, золотой час, солнце низко справа, ручная камера следует за ней, ветер в колосьях». Что изменилось: задано время суток, направление света и характер движения камеры.
- Было: «кот в космосе». Стало: «крупный план, рыжий кот в скафандре медленно поворачивает голову к иллюминатору, внутри капсулы, холодный свет приборов, звёзды за стеклом, 8 секунд». Что изменилось: появилось одно действие и понятная длительность, поэтому клип не распадается на куски.
Смета: во что обходится плохой промпт
Плохой запрос дороже, чем кажется. Каждая попытка это генерация, а каждая генерация это деньги и время. Десять дублей на клип там, где хватало двух, удваивают смету проекта незаметно, потому что списание идёт мелкими порциями.
Для ручной работы цена считается по ролику: ручные ролики от 16 000 ₽, и в эту сумму входит раскадровка, то есть те же пять слотов, записанные до генерации. Для потока считают по просмотрам: от 0,10 ₽ за просмотр при объёме от ста роликов в месяц.
Библиотека своих промптов экономит больше, чем подписка. Один раз описанный стиль съёмки, словарь света и список запрещённых объектов переносятся на десятки сцен. Когда запросов становится много, помогает изготовление видео с помощью нейросетей по регламенту: одинаковая структура промпта на всех исполнителей.
Дальше по теме полезно посмотреть справочник нейросетей для видео 2026: у каждой модели свои ограничения по длине и разрешению, и промпт под них подстраивается. Если же у вас уже есть текст и раскадровка, логичнее идти от них, об этом отдельный разбор про ИИ видео по сценарию.