Что произошло 10 и 11 ноября
11 ноября 2026 года Runway выложила Praxis-1 в открытый доступ. Веса под Apache 2.0, включая коммерческое использование, плюс код инференса и код дообучения, полного и через LoRA. 10 ноября Institute of Foundation Models в MBZUAI объявил PAN 2, тоже открытую модель: веса на Hugging Face, код на GitHub, лицензия Apache 2.0.
Два релиза в одну неделю, и оба про сдвиг в сторону действия. Модель, которую мы привыкли звать генератором видео, теперь отвечает на вопрос, что произойдёт в кадре через полсекунды после нажатия кнопки.
Роботы с ИИ видео: что показал Praxis-1
Praxis-1 Runway представила в сентябре как свою первую world action model. Внутри 27 млрд параметров, mixture-of-experts диффузионный трансформер, который предсказывает видео и действия вместе. Построен он на том же масштабном видеопретрейне, что и модели мира Runway.
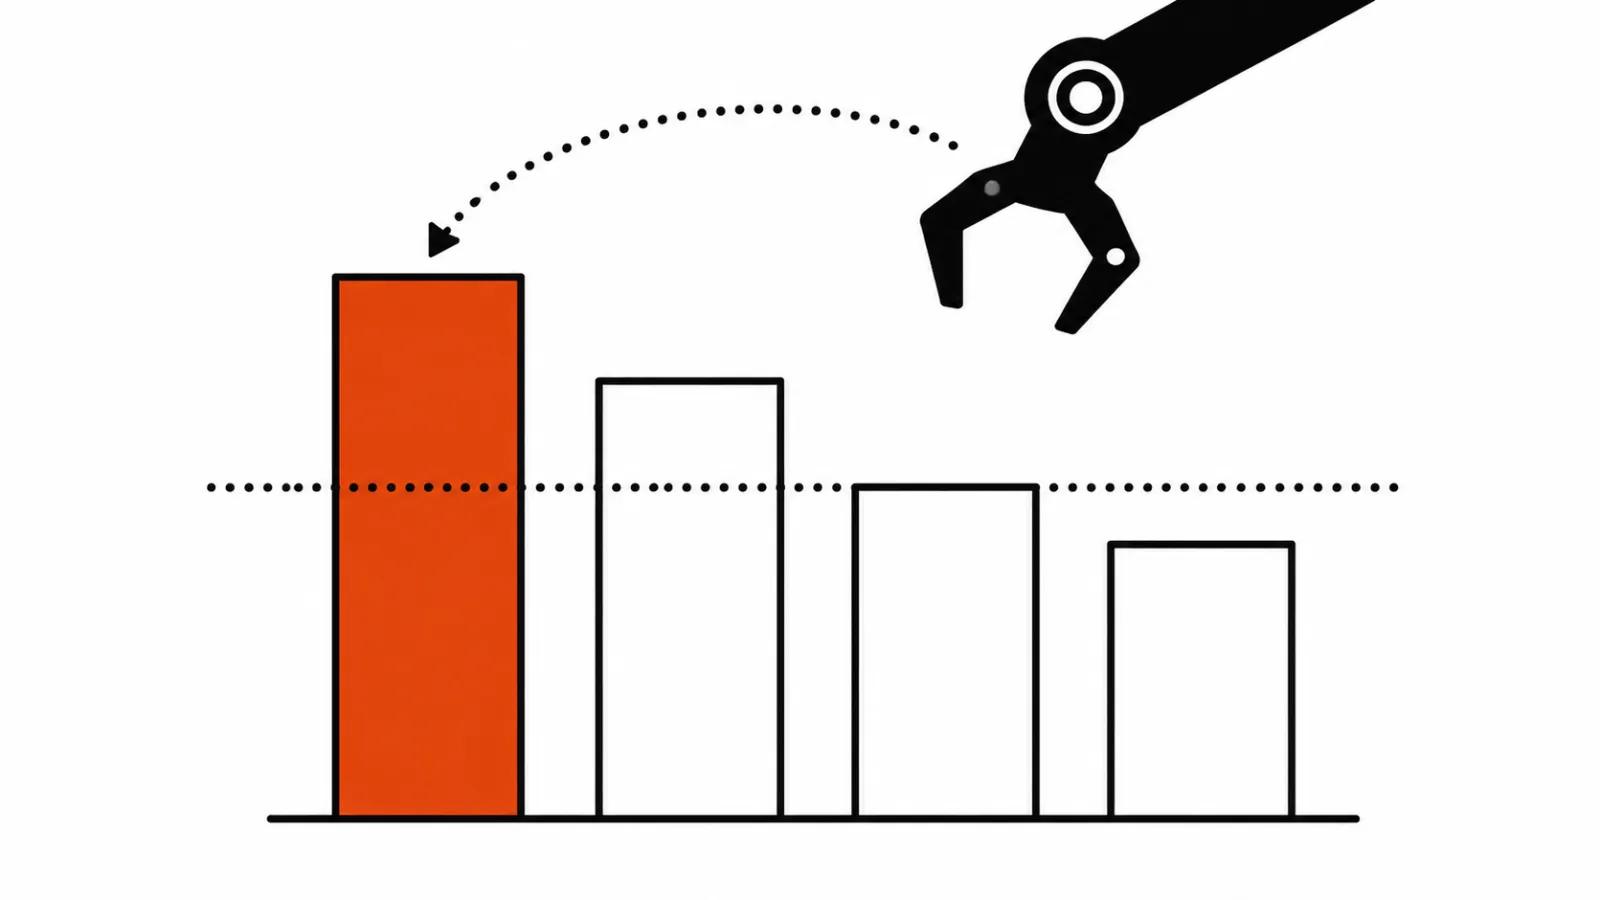
Цифры компания приводит такие. Лидерборд NVIDIA RoboLab-120 на 1200 эпизодов: Praxis-1 46,2%, FLUX 3 Action 42,9%, Cosmos3 Nano 36,8%, π0.5 28,0%. Отдельный тест посложнее: дообучение на роботе Google RT-1, которого не было в обучающем наборе, дало 80,0% на SimplerEnv против 52,4% у исходной модели RT-1.
Оговорку держу в уме. И лидерборд, и проценты в публикации это данные самой Runway. Разрыв в четыре пункта с FLUX 3 Action выглядит правдоподобно, но проверять его лучше на своём железе, благо веса лежат открыто и запускаются от H100 и B200 до RTX 5090 и Jetson Thor.
Почему хватило обычного веб-видео
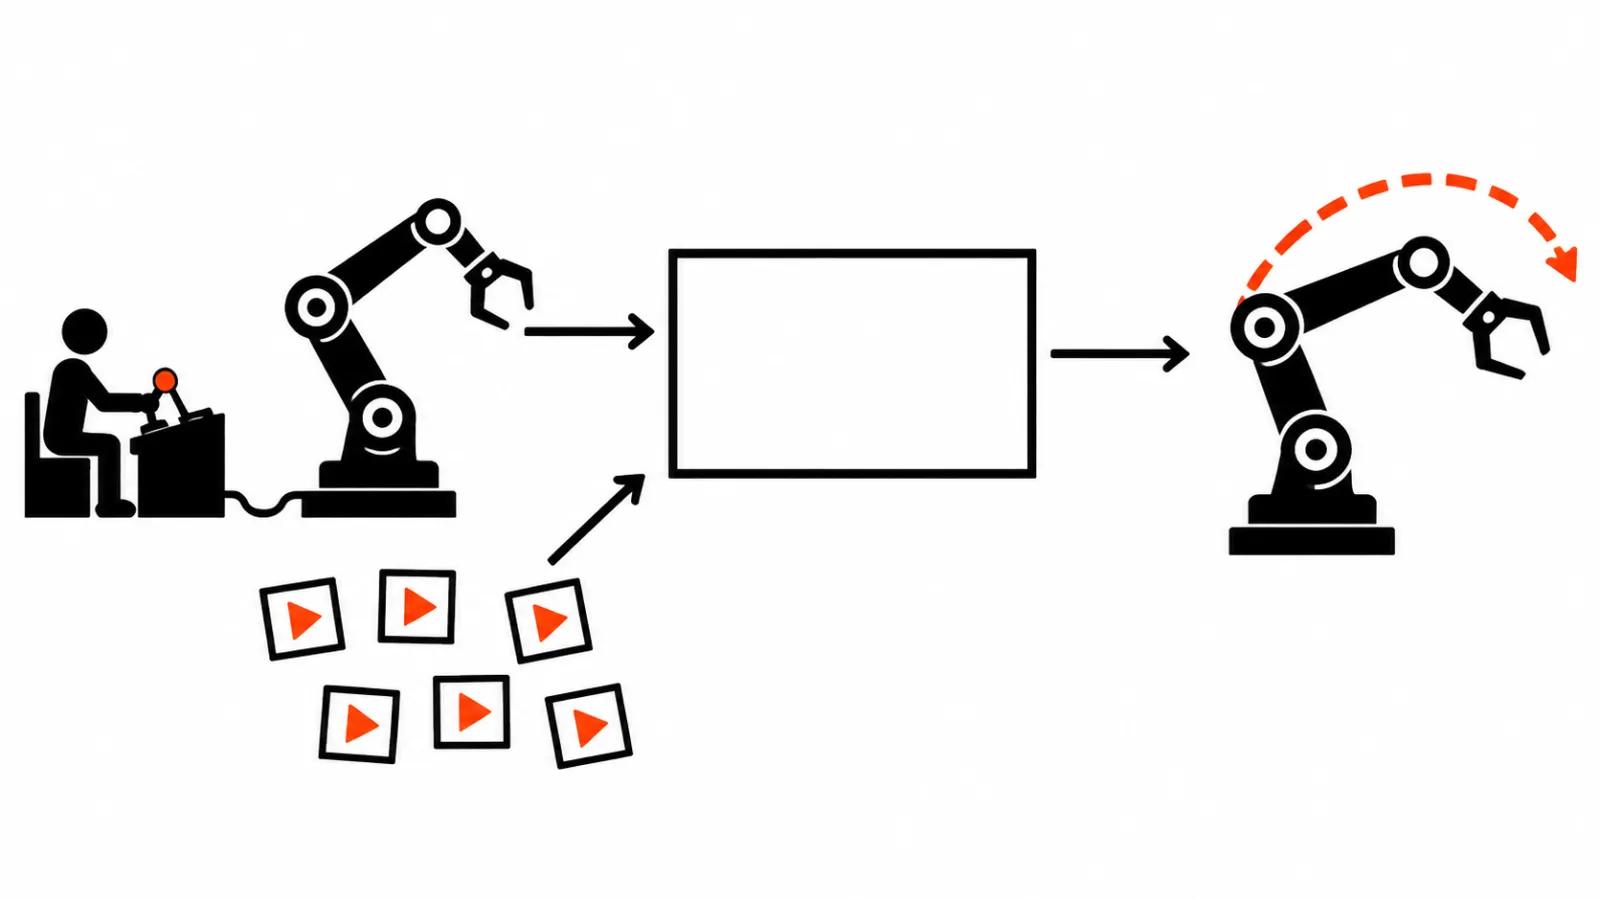
Самый интересный абзац в посте не про проценты. Runway пишет прямо: веб-видео как данные для предобучения не хуже телеоперированного видео роботов. То есть ролики из интернета могут заменить заметную часть съёмки с пульта. Узкое место сдвигается, и теперь ограничение в том, сколько обычного видео модель способна выучить.
Телеоперация всегда была дорогим звеном в обучении роботов: оператор, стенд, повторяемость движений. Если веб-видео закрывает эту дыру, обучение роботов дешевеет. Партнёры Runway по запуску: Noble Machines, Standard Bots и Ultra, а для тех, у кого нет своего железа, есть хостинг на Reactor.
PAN 2: модель проигрывает сцену вперёд
PAN 2 устроен иначе. Языковая модель-планировщик плюс видео-диффузионный трансформер на 29 млрд параметров. На входе текст со сценой и действием, на выходе видео вероятного результата, авторы называют это simulative reasoning. По умолчанию 704 на 1248 пикселей, 24 кадра в секунду, клипы до 20 секунд, 50 шагов сэмплирования и CFG 2.5. Поддержаны Diffusers и vLLM, модель умеет и текст в видео, и картинку в видео.
В карточке модели отдельно указан защитный фильтр, guardrail. Это разумно: модель, которая дорисовывает последствия действия, интересна и тем, кто хочет понять, что будет, если толкнуть стакан. Детали по цифрам я беру из пересказа Writeble от 11 ноября, который опирается на карточку модели, так что параметры стоит сверять на Hugging Face.
Что это меняет для рекламного видео
Практика простая. Деньги в видеомодели теперь идут по двум каналам: ролики и роботы. Физика движения будет улучшаться быстрее, чем нужно одному рекламному рынку, и нам достанется побочный продукт чужой гонки.
Второе. Веса открыты и коммерческое использование разрешено, поэтому команда, которая делает видео нейросетями, может изучать эти модели без договора и без счёта за API. Для генерации рекламных роликов они не предназначены, зато показывают, куда двигается физика в видеомоделях.
Третье, менее очевидное. Модель, которая предсказывает действие, в перспективе может пригодиться и в монтаже: если она понимает, что человек сделает в следующем кадре, склейки на движении станут предсказуемее. Пока это моя гипотеза. Сравнить с тем, как это выглядело год назад, можно по прошлому разбору про модели мира с генерацией видео со звуком.
Мой вывод
Два открытых релиза за два дня выглядят продолжением одной линии. Генерация видео перестаёт быть отдельной индустрией развлечений: тот же претрейн обслуживает манипулятор.
Ставлю на то, что в вакансиях 2027 года слово «видеомодель» будет чаще соседствовать со словом «манипуляция», чем со словом «клип». Позиция личная, но цифры её держат: 46,2% на RoboLab-120 и 80,0% после дообучения на незнакомом роботе это уже не демо.
Для заказчика рекламы вывод скучнее и полезнее. Модель, которая понимает физику, ошибается на движении реже, поэтому вопрос качества ролика всё чаще будет упираться в правдоподобие падения предмета и в поведение ткани. Это то, что нельзя вылечить промптом, зато можно заметить на тестовом фрагменте до основной работы.