Что именно сделали в Video-Coder
Работа называется Video-Coder: Reinforcing Agentic Coding for Video Generation. Дата 9 ноября 2026, номер на arXiv 2611.09894, есть страница на Hugging Face Papers и разбор в AI Weekly. Авторы: University of Central Florida, University of Würzburg, Microsoft Research, Tsinghua, UNC-Chapel Hill, UW-Madison. Данные, модели и код открыты, всё лежит на GitHub в репозитории CYWang735/Video-Coder и на Hugging Face.
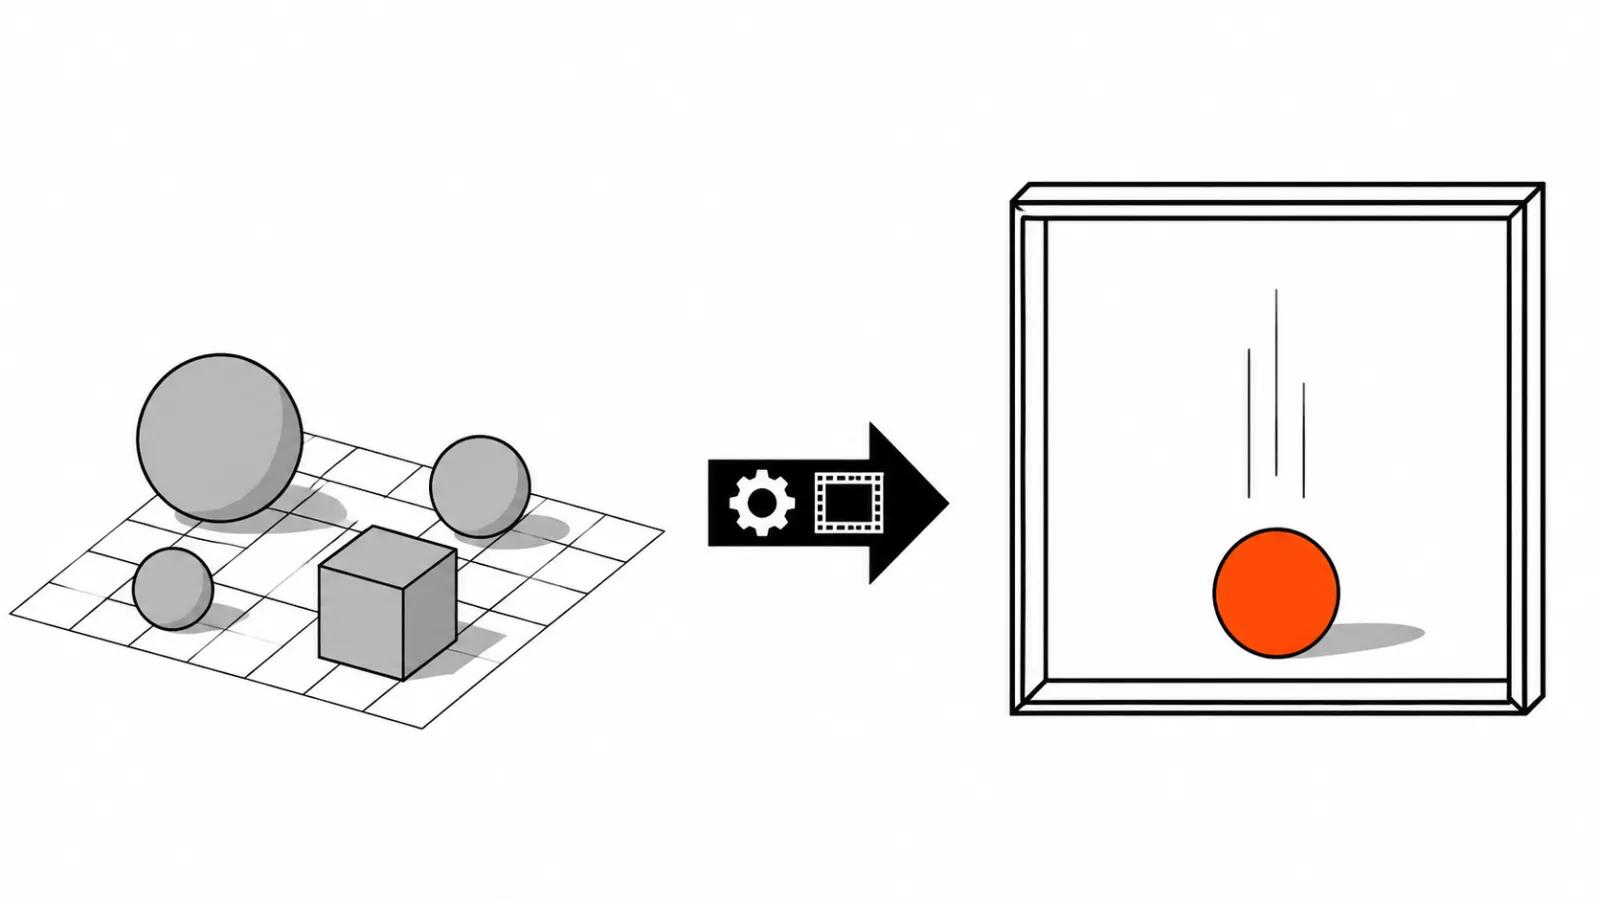
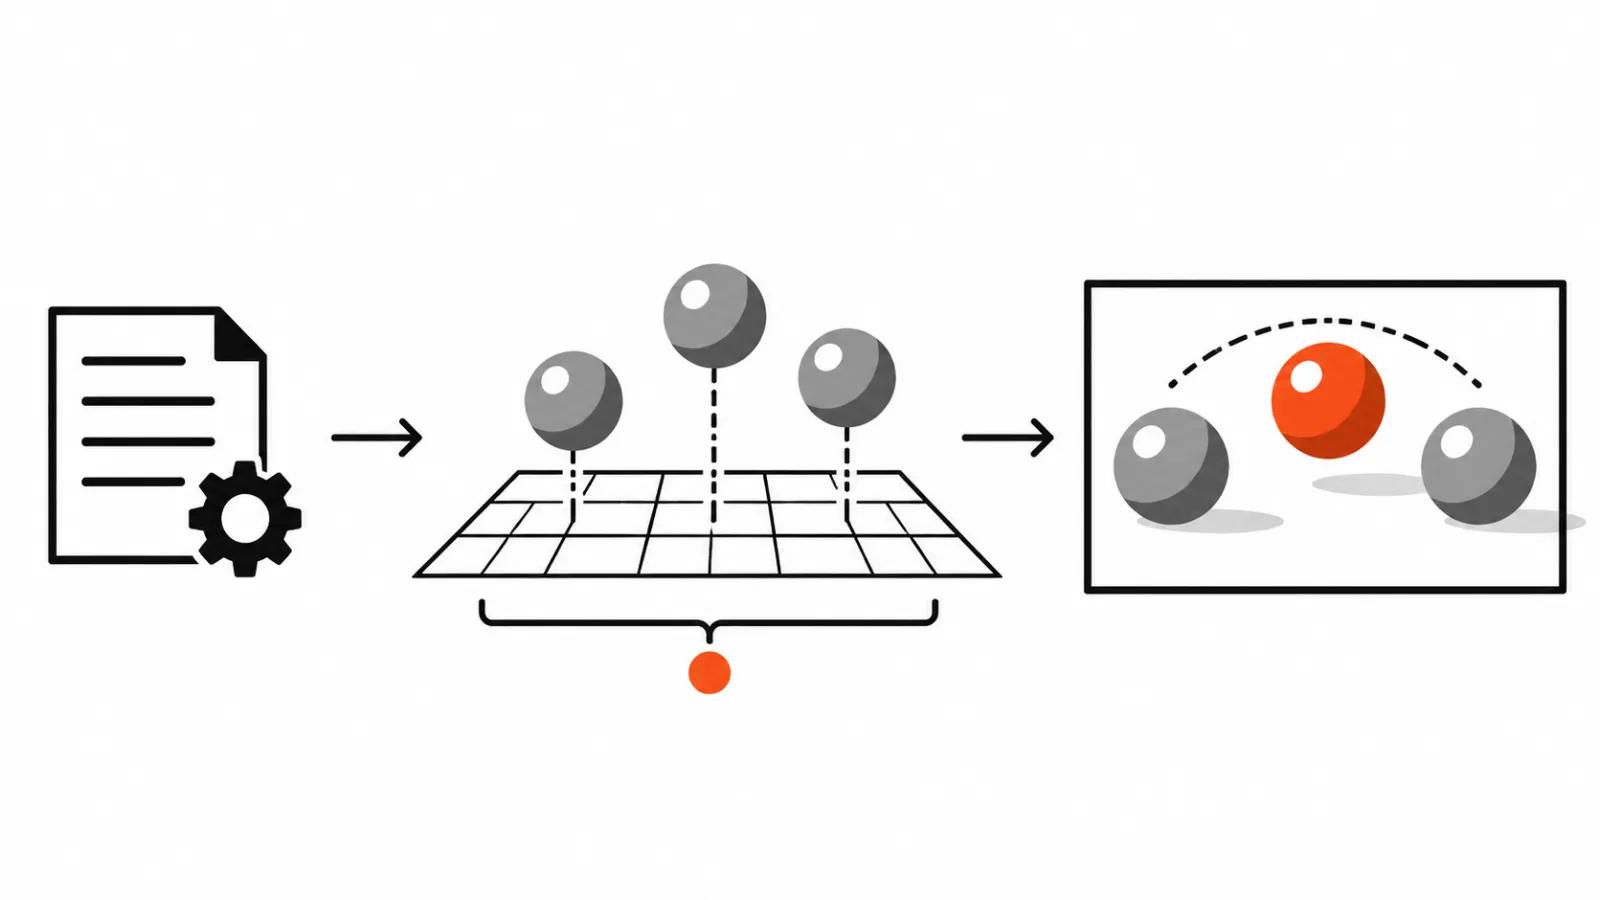
Механика в три шага. Агент пишет и запускает Python-код для Blender. Код строит динамическую 3D-сцену из серых глиняных объектов, без текстур и материалов. Сцена рендерится в черновое видео, Draft Video. Дальше работает видеогенератор, в работе это MiniMax H3: он получает черновик вместе с промптом и рисует финальную картинку.
Черновик отвечает за структуру и движение. Генератор отвечает за свет, цвет и материал. Зоны ответственности разделены, и это главная идея статьи.
Почему генератор в пикселях путает шары
Причина в том, что такие модели учатся на пикселях и не строят явную 3D-модель мира. На сцене с несколькими предметами счёт объектов сбивается: было три шара, стало два, к финалу четыре. Позиции плывут, окклюзии ломаются, предметы деформируются, часть исчезает на середине движения.
Код такой свободы не даёт. Три шара, падающие одновременно с разной высоты, это три координаты и общий старт по времени. Пока скрипт исполняется, физика в сцене одна и та же на первом кадре и на последнем.
Отсюда решение авторов: часть логики вынести из пикселей в программный слой, где числа проверяемы.
Как учили агента
База это Qwen3.5-9B. Сначала SFT на наборе Video-Coder-SFT-6k, потом агентное обучение с подкреплением на Video-Coder-RL-2k. В разделе Setup той же статьи стоят другие числа, 10k и 4k, так что аккуратнее говорить «несколько тысяч примеров»: внутри текста цифры расходятся.
Награда двойная. Первая за то, что код вообще исполняется и сцена собирается. Вторая за качество получившегося видео. Вес первой со временем убывает, потому что к концу обучения агент и так выдаёт рабочий скрипт, а интерес смещается к картинке.
Железо: 8 GPU H100 на обучение агента и ещё 16 H100 под MiniMax H3, около трёх дней работы.
Цифры на PhyGenBench и VBench-2.0
На PhyGenBench средний балл MiniMax H3 поднимается с 0,61 до 0,67 в паре с Video-Coder. Внутри разбивка: механика 0,68, оптика 0,79. На VBench-2.0 физические измерения растут с 54,58% до 78,19%, механика 88,67%.
Две оговорки по методике. PhyGenBench судит GPT-4o, то есть оценка идёт языковой моделью с её представлениями о правильной картинке. И все замеры сделаны авторами работы, независимого прогона нет.
Для запроса «нейросеть для видео сравнение» такой балл годится как ориентир по физике и как повод смотреть конкретные сцены. Приговором его считать рано.
Где черновик проигрывает
По материалам картина обратная. В категории Material у Video-Coder 75,02%, у CogVideoX-1.5 83,19%: модель предыдущего поколения обходит новый метод. Объяснение простое. Серый черновик несёт форму и движение, фактуры в нём нет. Кожа, металл, вода, ткань остаются на совести генератора, который видит болванку и текст промпта.
Тут же становится видна граница применимости. Чем важнее поверхность, тем меньше пользы от черновика: он не подскажет ни отражения в витрине, ни мягкости ткани.
Блокинг, который пишет агент
Мне эта схема близка, потому что повторяет порядок ручной работы. Сначала блокинг: кто где стоит, куда идёт камера, что с чем сталкивается. Потом свет, фактура, детали. В студии блокинг делает аниматор, здесь его пишет агент, и это честная попытка закрыть самый скучный этап.
Границы метода авторы обозначают сами. Лица и мимику он сознательно не трогает: глиняная болванка лица не задаёт, на человеке черновик бесполезен. Готового продукта тоже нет, есть репозиторий и веса. Так что осторожная формулировка звучит так: направление рабочее, инструмента для клиента пока не существует.
Что это меняет в заказе на видео
Для заказа это пока ориентир в выборе подхода. Когда в кадре несколько предметов, которые должны взаимодействовать, движение задают до генерации: раскадровкой, 3D-превизом или кодом. Мы собираем видео нейросетями и держим структуру сцены на раскадровке, чтобы генератор не решал за нас, сколько объектов осталось в кадре. Там, где важна фактура и актёрская игра, работает другой путь: ручные ролики от 16 000 ₽, где каждый кадр собирает человек.
Разница между подходами видна на соседних разборах. Разбор про анимацию кодом для шортсов устроен иначе: там код выдаёт финальную графику, а здесь код остаётся черновиком для генератора. Если нужен общий список инструментов, у нас есть разбор нейросети для анимации видео: там про поведение моделей на движении и типичные срывы.
Мой вывод
Ставка на код как слой планирования правильная, и цифры по физике это подтверждают. Прорыва в фактуре нет, да и быть не могло: черновик из глины её не несёт.
Практический вывод простой. Если предметы в кадре должны взаимодействовать, движение задают до генерации. Надежда на то, что модель сама удержит три объекта и траектории, выходит дороже по переделкам. Когда такой слой появится в продуктах, первый сценарий применения это реклама товара с механикой: сборка, падение, перелив.