Что Zyphra выпустила 9 ноября
Девятого ноября Zyphra выложила ZONOS3-Mini, компактную модель озвучки текста с открытыми весами. Внутри 100 млн активных параметров при 886 млн общих, архитектура трансформер со смесью экспертов, контекст 32K. Лицензия Apache 2.0, значит веса можно скачать и запускать у себя без отдельного договора.
Размер здесь главный аргумент. Модель работает в реальном времени на телефонах и ноутбуках, в том числе прямо в браузере. Для человека, который собирает ролики, это означает простую вещь: закадровый голос можно получить на своём ноутбуке, пока идёт монтаж.
Клонирование голоса нейросетью: образец или описание
Голос задаётся двумя способами. Первый: образец аудио, по которому модель копирует тембр. Второй: описание персонажа, где указывают возраст, акцент и текстуру голоса. Второй путь удобен для вымышленных героев, когда живого диктора нет и не будет.
Управление идёт по эмоции, темпу и подаче, вплоть до отдельных слов. На практике это значит, что фразу можно сделать спокойной, а одно слово внутри неё выделить нажимом. Для серии роликов такое управление экономит перезаписи: интонацию правят прямо в тексте сценария.
Открытая модель озвучки текста: локально или через облако
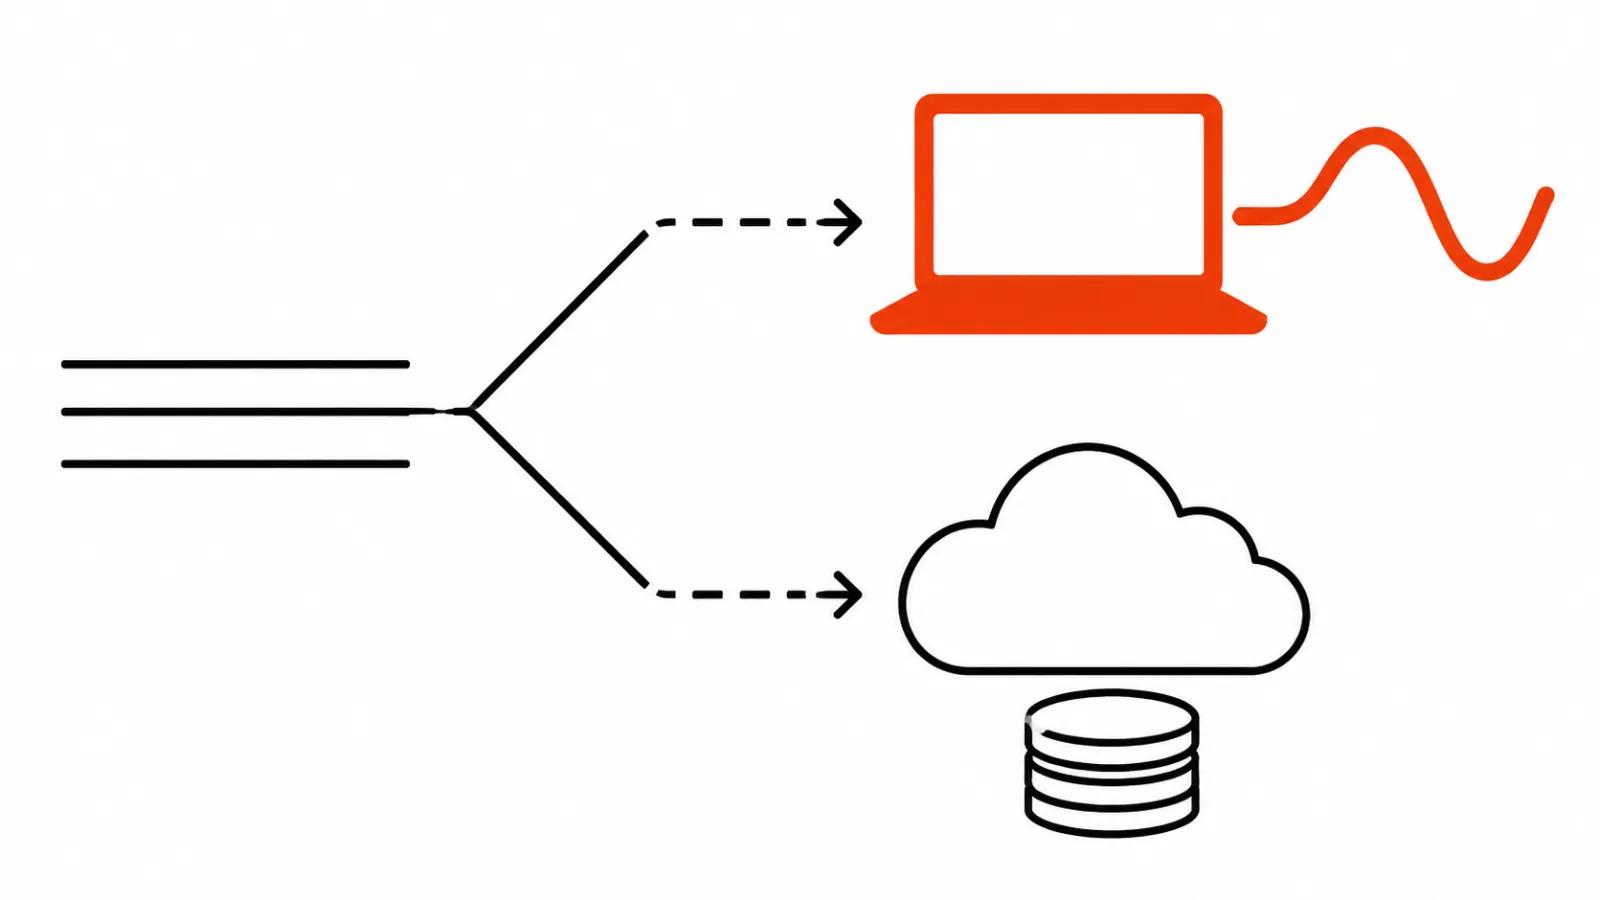
Запуск идёт двумя путями. Локально, через браузерный рантайм или нативные сборки. Или через облако Zyphra Inference, где считает их железо. Локальный путь бесплатен по лицензии, облачный считается по тексту: 10 $ за 1 млн UTF-8 байт, это 840 рублей.
Байт в русском тексте занимает примерно две единицы на букву, потому что кириллица в UTF-8 весит два байта. Миллион байт русского текста это около пятисот тысяч знаков, и по деньгам русская озвучка выходит дороже английской при том же объёме. Считать надо в байтах.
По веб-справке заявлено 43 языка, и это ответ поисковой системы, неофициальный пересказ. Число стоит проверить на странице модели. Там же лежат сравнения с Fish Audio, Qwen, Cartesia, ElevenLabs и OmniVoice, и это собственные сравнения Zyphra, независимыми замерами они не являются.
Зачем это тому, кто собирает ролики
Первый сценарий это закадровый голос. Серия вертикальных роликов требует десятков озвучек в неделю, и каждая правка сценария тянет за собой новую запись. Модель, которая живёт на ноутбуке, снимает эту зависимость: текст поправили, голос пересобрали за минуты.
Второй сценарий это закрытый материал. Когда сценарий нельзя отправлять в чужое облако, локальный запуск остаётся единственным вариантом. Это касается черновиков клиентов, внутренних презентаций и всего, что живёт под соглашением о неразглашении.
Риски: чужой голос и согласие
Клонирование по образцу упирается в одно правило: голос принадлежит человеку. Копия голоса диктора без его письменного согласия это риск суда и репутации, и техническая доступность модели здесь ничего не меняет. Публичное лицо, актёр, коллега, случайный человек из чужого ролика: перед копированием нужно разрешение.
Второй риск это сам образец. Аудио с голосом человека относится к персональным данным, и хранение таких файлов в чужом облаке требует отдельного разговора с юристом.
Третий риск касается качества. Про русский язык в релизе конкретики мало, и обещать чистую озвучку на русском заранее нельзя.
Что проверить на русском
Тест стоит строить вокруг четырёх вещей. Ударения: модель может прочитать «замок» как строение там, где речь про механизм. Цифры: суммы, даты, проценты и номера часто читаются не так, как нужно. Аббревиатуры и названия: «ИИ», «США», бренды. Акценты: заявленный набор языков не гарантирует ровного русского.
Проверять надо на своём тексте. Взять абзац из реального сценария с цифрами и именами, прогнать, послушать на телефоне. Если ударения плывут, есть два выхода: править текст под модель или оставить такие места живому диктору.
Позиция
Открытые веса на 100 млн активных параметров, которые работают в браузере, меняют цену входа: тест на русском делается за полчаса и без счёта за облако.
Чего я тут не вижу, так это доказательств качества. Zyphra сравнивает свою модель с Fish Audio, Qwen, Cartesia, ElevenLabs и OmniVoice на странице модели, и это сравнение продавца. Семнадцатого ноября ReelStack включил ZONOS3-Mini в подборку, это говорит о внимании рынка, про качество на русском оно не говорит ничего.
Практический вывод простой. Если нужен закадровый голос в серии роликов и есть свой образец голоса с согласием, модель стоит поставить на ноутбук и прогнать на реальном сценарии. Если нужен русский голос под ключ с ответственностью за результат, разбор про звук, голос и субтитры в ИИ-ролике объясняет, из чего складывается такая работа.
Под такие задачи есть услуги: видео нейросетями и вертикальная реклама. Смежные материалы: ElevenLabs SFX v3.