Что показали: realtime avatar из одного фото
Atmanity это лаборатория, которая работает с 2024 года. По обзорам новость про Atmee v2 прошла около 4 и 5 ноября 2026 года, точного времени пресс-релиза на сайте вендора я не нашёл, поэтому дальше пишу «начало ноября».
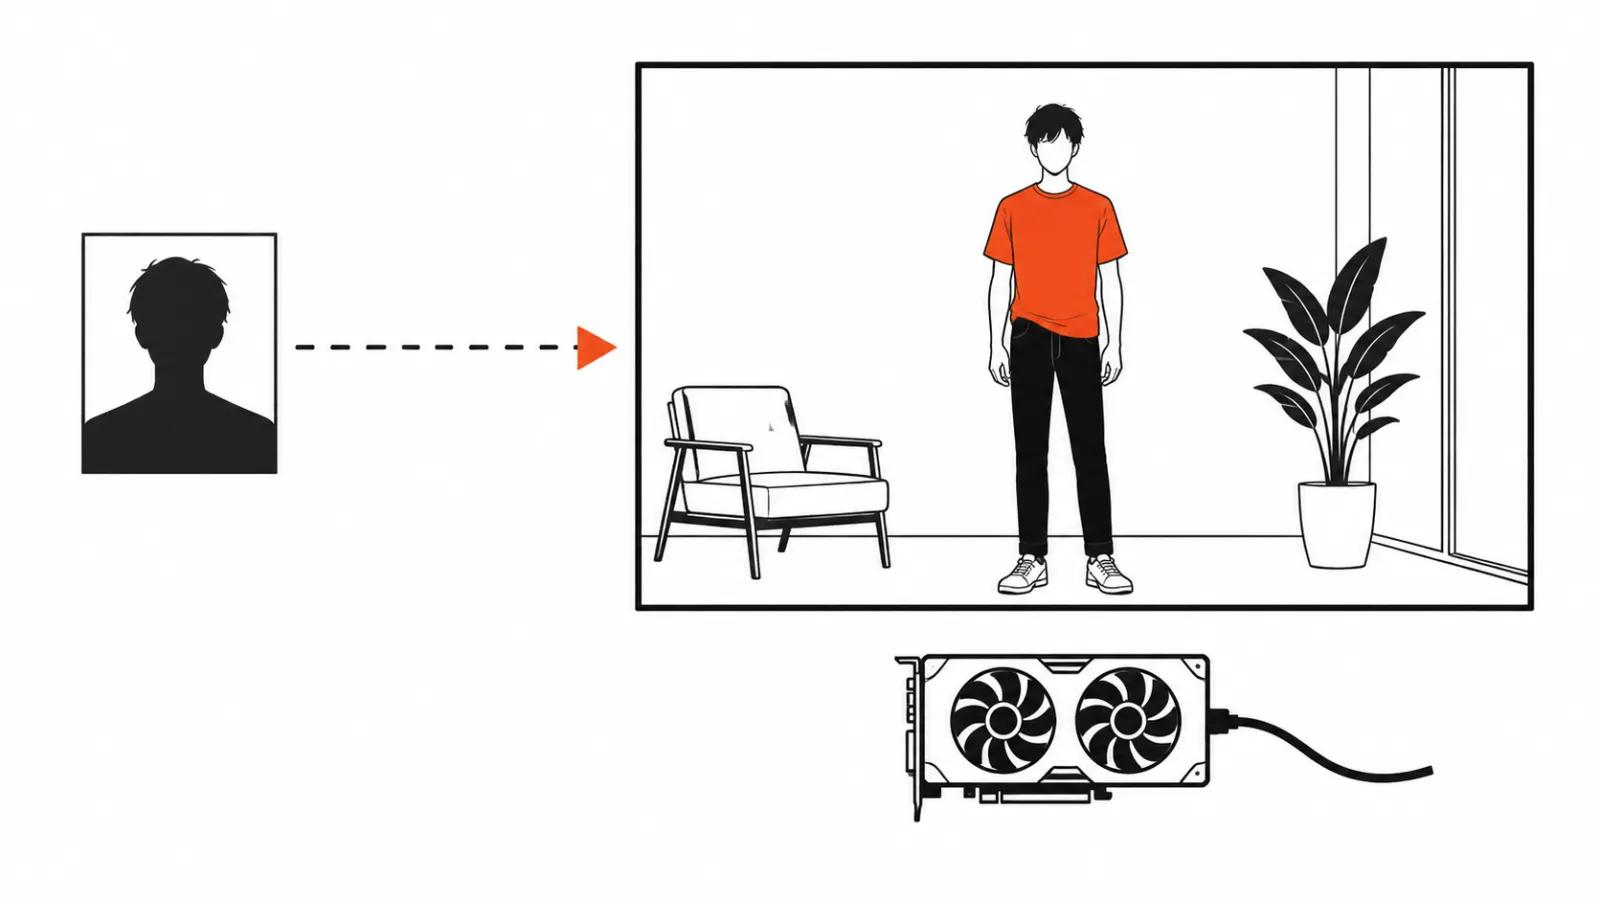
Продукт описан как real-time full-frame video foundation model для живых аватаров. Слово full-frame здесь главное. Речь про кадр целиком, где есть лицо, тело и окружение в одном потоке. Голова в окошке, которая шевелит губами под готовую дорожку, это более старый и более дешёвый класс.
Заявка по входу скромная: одно изображение и короткий образец голоса, в маркетинге называют пятнадцать секунд. На выходе ии персонаж из фото, которого можно посадить на поток и не переснимать каждую реплику. Всё это, по словам вендора, укладывается в одну GPU.
Здесь я останавливаюсь и перечитываю формулировку. Одна карта это про стоимость минуты живого агента, и она меняет экономику только там, где агент работает часами. Независимых замеров fps, задержки и цены минуты в открытом доступе нет, в обзорах их тоже не приводят. Если увидите цифру вроде «в 50 раз быстрее Wan», это пересказ маркетинга без методики, и как факт я её не беру.
Causeur: почему аватар слушает
Вторая половина стека называется Causeur. Это поведенческая модель: личность, эмоция, тайминг, активное слушание.
Тайминг тут важнее внешности. Большинство моделей синхронизации губ решают одну задачу: попасть движением рта в фонему. На созвоне или в диалоге с ботом зритель считывает другое: паузу перед ответом, кивок в момент чужой реплики, смену выражения за секунду до того, как человек начал говорить. Такие вещи ловятся глазом быстрее, чем качество текстуры кожи.
Заявленная архитектура разумна. Рендер кадра и поведение разведены в два слоя, поэтому поведение можно менять без переобучения видеочасти, а качество картинки улучшать без ломки характера. Это то, чего не хватало аватарам первого поколения: они умели говорить, и не умели молчать.
Ии персонаж из фото на одной GPU: что это меняет
Для продакшена ролика число видеокарт почти не важно. Клип рендерится один раз, дальше это файл. Одна GPU интересна в другом сценарии: живой агент на сайте, в приложении, на стойке в шоуруме, где аватар отвечает здесь и сейчас и платит за секунды работы.
Тут и начинается разница между демо и продуктом. Демо показывает тридцать секунд лица крупным планом. Продукт держит час разговора без дрейфа лица, без сползания света и без того, чтобы персонаж уходил в ступор на длинной паузе. По таким вещам вендор публичных цифр не дал, и это нормально для раннего доступа: сначала приглашения, потом бенчмарки.
Мой рабочий критерий простой. Если аватар выдерживает десять минут с плохим микрофоном и перебиванием, с ним можно идти к клиенту. Всё, что короче, остаётся экспериментом.
Доступ: приглашение, три режима API и atmee.ai
Atmee v2 открыт по приглашению. Заявка идёт через почту contact@atmanity.io, формы с кнопкой на сайте вендора нет. Ранний доступ по приглашению это обычная практика для тяжёлой модели: так ограничивают нагрузку и собирают фидбек с площадок, которые готовы возиться.
Вендор заявляет три режима API. Полный стек, то есть аватар целиком с поведением. Только аватар, без голосовой части. И только голос, без видео. Последние два режима важнее, чем кажутся: их можно встроить в чужой конвейер, где видео уже есть и не хватает лица или озвучки.
Первая версия Atmee уже работает на atmee.ai, её можно открыть и посмотреть, как это выглядит без заявки. Основатели лаборатории Chen-Ping Yu и Yi-Hsuan Tsai, оба пришли из Phiar, потом работали в Google. Для оценки серьёзности команды это полезнее любого пресс-релиза.
Characters и Muse: другой класс доступа
В тех же обзорах рядом идут Runway Characters и Meta Muse, и это честное сравнение, только лежит оно в плоскости доступа. Characters и Muse подаются как продукты, которые можно потрогать в платформе или в исследовательском доступе. Atmee v2 существует пока как заявка на почту и обещание одной GPU.
Практическая разница для студии огромная. Первые два варианта можно поставить в тест на этой неделе и получить счёт за минуты. Третий даёт письмо, разговор и ожидание. Я не считаю закрытый доступ недостатком: для модели, которая считает видео в реальном времени, это способ не утонуть в запросах. Но планировать на нём клиентский проект нельзя.
Ещё одна деталь, которую легко пропустить. Atmee v2 заявляется как видео-фундамент. Сервис аватаров с готовыми персонажами устроен иначе, и это отдельный продукт. Это означает интеграцию: свой пайплайн, свой биллинг, свой контроль качества. Для команды без инженера по видео это стоп.
Чем это грозит продакшену роликов
Для ролика с дедлайном на следующей неделе Atmee v2 ничего не меняет. Мы делаем видео нейросетями на том, что доступно сегодня, и там аватар это одна деталь кадра, без собственного продукта.
Для длинных форматов, где нужен ведущий на экране, ставка другая. Ручные ролики от 16 000 ₽ собираются с человеком за кадром, и аватар в них появляется там, где съёмка дороже генерации: правки текста, второй язык, десять версий одного монолога.
Поэтому я читаю новость Atmanity как сигнал рынка. Realtime-аватары движутся к цене звонка, съёмка считается по другой ставке. Когда это случится, формат общения с клиентом изменится сильнее самих роликов: консультант, который не устаёт, и персонаж, который помнит прошлый разговор. Если хотите понять, откуда это растёт, у нас есть общий обзор ИИ-аватаров.
Мой вывод
Atmee v2 это ещё один realtime-аватарный стек, и он честно упакован: одна карта, три режима API, поведенческая модель отдельным слоем. Заявки сильные. Доказательств пока ровно столько, сколько вендор показал в демо, и ни одного независимого замера.
Моё решение простое. Слежу за приглашениями, не строю на этом клиентский проект и держу в голове Characters, Muse и локальные S2V как рабочую альтернативу на сегодня. Когда появится живой доступ и час разговора без дрейфа, вернусь к вопросу с цифрами в руках.