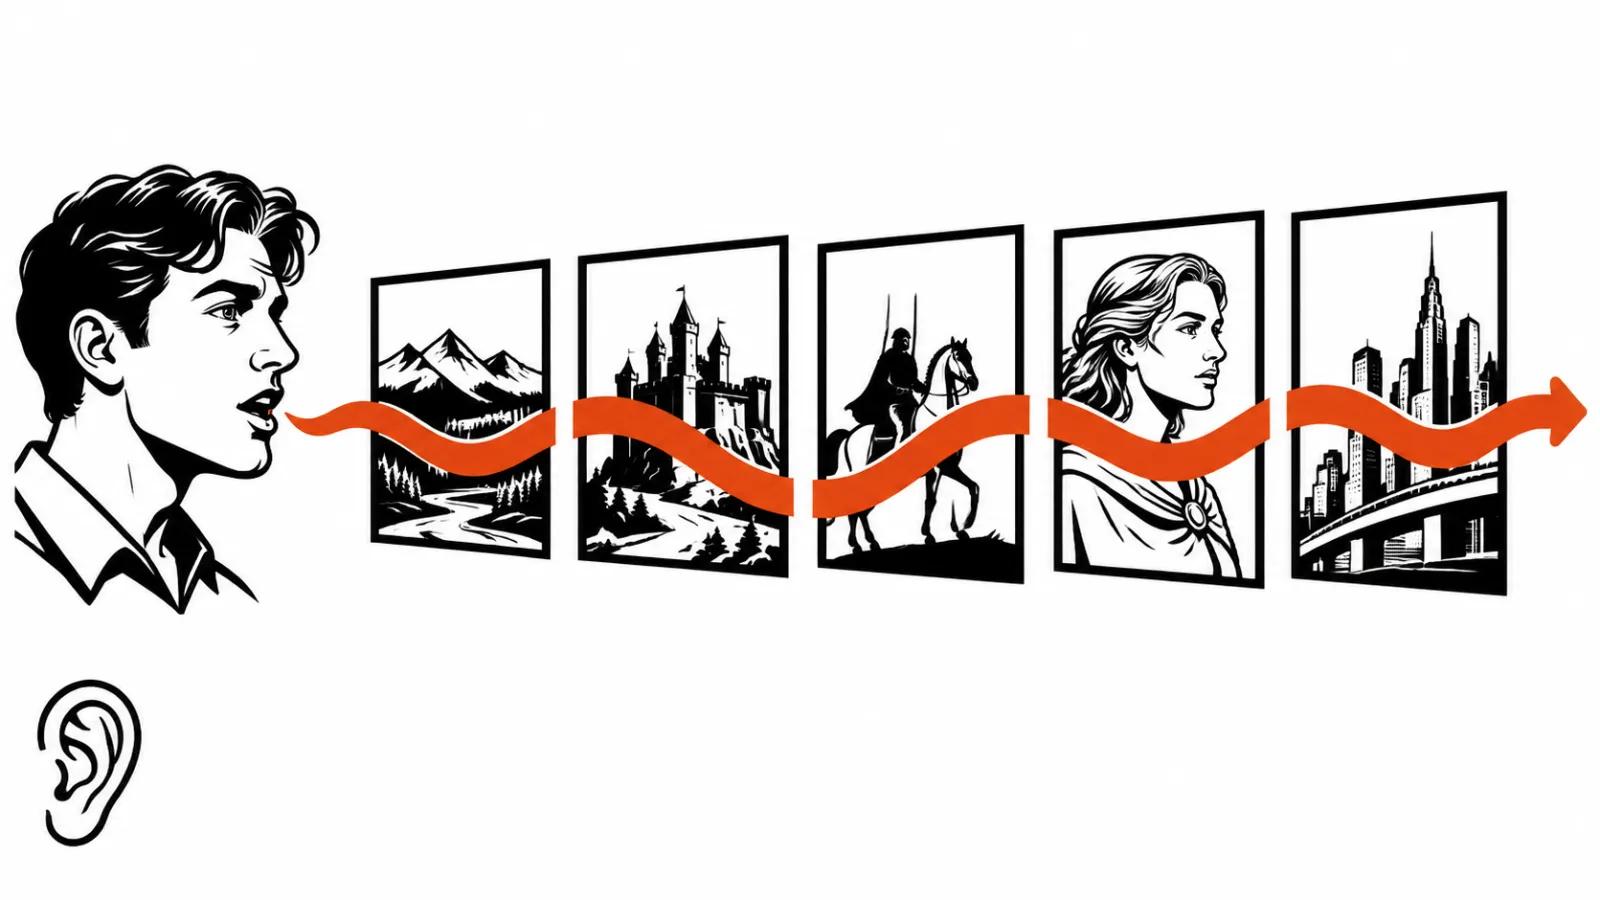
Что Baidu показала 12 ноября
Модель представили 12 ноября 2026 года на конференции Baidu World 2026. Объявил её Цзя Лэй, глава департамента прикладных моделей Baidu, об этом писали Sina Finance и Phoenix Tech. По пресс-релизу на PR Newswire от 12.11.2026 Wizshot-ME обрабатывает текст, картинки и речь вместе, принимает длинный текст до 4000 китайских знаков и, по словам компании, лидирует в подкастах и коротких анимированных драмах при половине типичной цены.
Слово «лидирует» здесь принадлежит Baidu. Независимых тестов на 13 ноября нет, поэтому все цифры ниже пока идут со слов компании.
Почему ИИ аватар говорящий упирается в склейку
Обычный конвейер режет сценарий на куски примерно по 30 секунд, озвучивает каждый отдельно и склеивает в монтаже. На стыках слышно, как гуляет темп, а иногда и тембр: зритель не назовёт причину, но голос звучит собранным из частей. Wizshot-ME по данным Sina Finance делает озвучку на уровне всего текста, голос всего сценария генерируется за один проход, и Baidu говорит, что так голос и темп остаются одинаковыми.
Для ролика с актёром это важнее картинки. Мимика прощает многое, звук не прощает ничего: минута ровного голоса держит внимание крепче, чем минута красивых кадров с провалами по громкости.
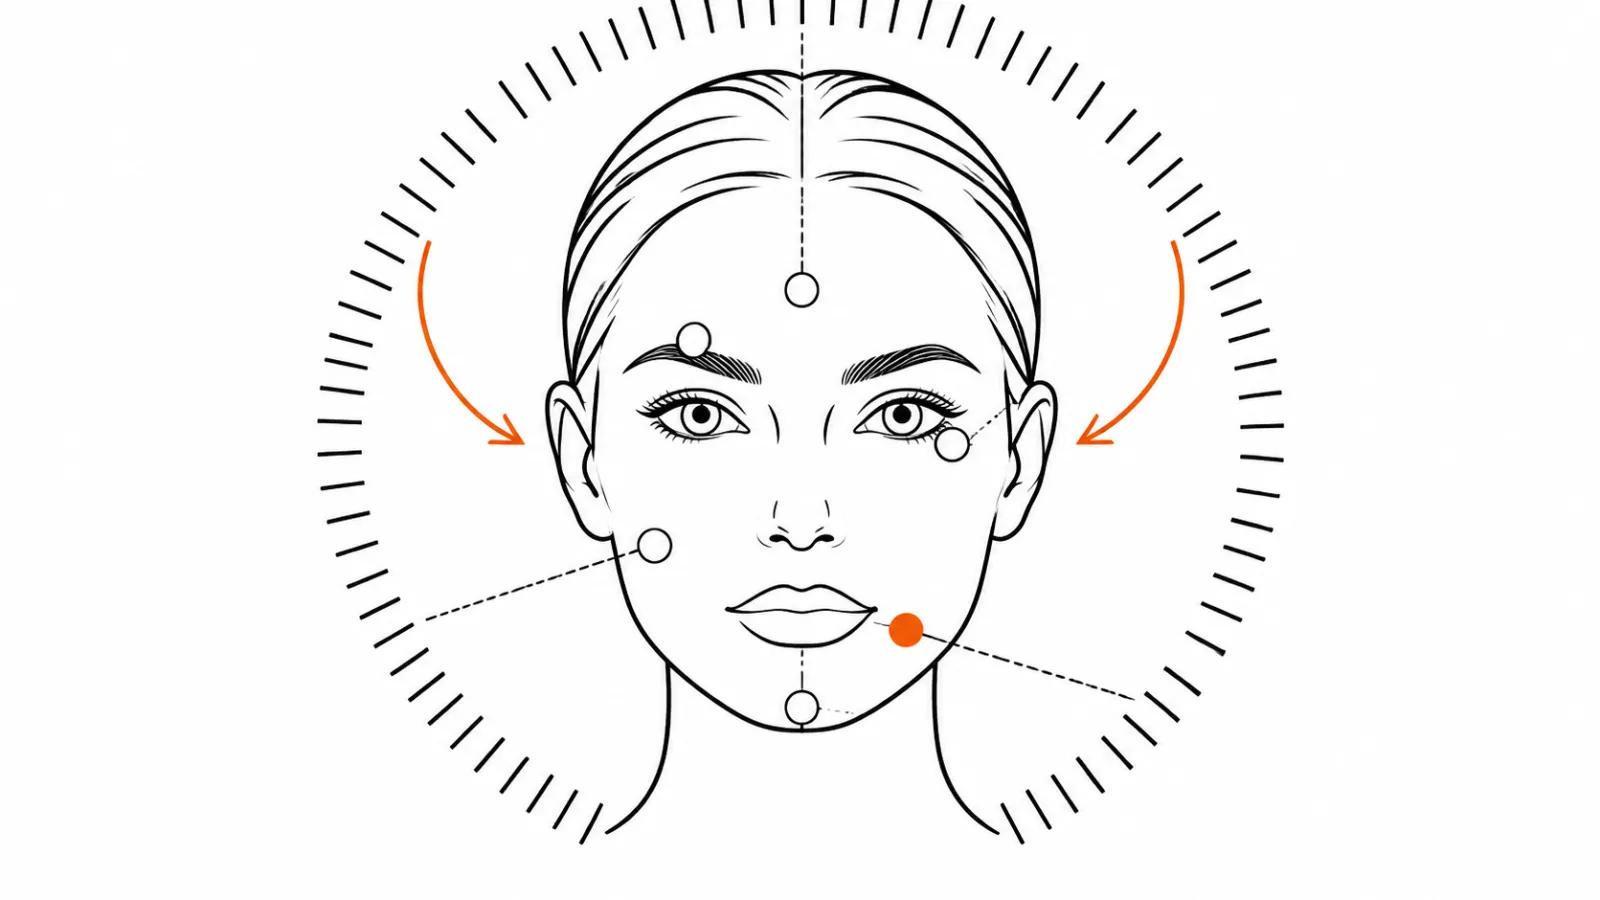
Микромимика: шесть измерений и двести подизмерений
Эмоции текста попадают в модель через систему описания из шести основных измерений и двухсот подизмерений (Sina Finance). Она переводит эмоции в мимику, жесты и смену настроения. По-простому: ремарка «говорит раздражённо» становится выражением лица и перестаёт быть строкой, которую забыли прочитать вслух.
Отдельно на той же конференции платформа цифровых людей Baidu Yijing показала до 8-9 микровыражений в секунду (Beijing News). Число относится к другому продукту, тянуть его на Wizshot-ME напрямую нельзя, но темп Baidu держит один по всему стеку.
Что на входе и что на выходе
По документации Qianfan, пересказанной llms.blog, на каждого персонажа нужна картинка и образец голоса, на каждый шот картинка раскадровки, плюс сценарий с ремарками. Выход это клипы 4-15 секунд в 1080p по странице продукта Qianfan, её пересказывают unwire.pro и llms.blog. Быстрая версия по Sina Finance отдаёт минуту видео примерно за минуту.
Вход объясняет порядок работы. Сначала сценарий, потом картинки, потому что ремарки уходят в мимику, а картинка персонажа и образец голоса держат лицо и тембр через все шоты.
Как создать говорящий аватар в Wizshot-ME
Порядок, по которому я считал бы такой ролик.
Первое: сценарий с ремарками целиком. Лимит 4000 китайских знаков, и резать сценарий на куски заранее не нужно.
Второе: один герой на входе. Одна картинка, один образец голоса, один характер. Второй персонаж означает второй комплект входа и отдельную логику по шотам.
Третье: раскадровка до генерации. Клип длиной 4-15 секунд требует, чтобы сцена была расписана на шоты заранее.
Четвёртое: считать переделки. По прайсу Qianfan секунда стоит 0,7 юаня, десятисекундный клип это 7 юаней за одну генерацию, каждая переделка оплачивается заново. Пять вариантов одной сцены означают пять оплат.
Цена, доступ и то, о чём Baidu молчит
Доступ идёт через API для бизнеса и партнёров на Baidu AI Cloud Qianfan. Нужен ключ Qianfan, цены в юанях, документация на китайском языке. Открытых весов нет, локально модель не запустить. Можно ли пользоваться ей из-за пределов Китая, Baidu не уточняла, и это первый вопрос к интегратору перед сметой.
Обещание про половину типичной цены тоже требует расшифровки: половина от чего и на каком объёме, в релизе не сказано. Подкаст на два голоса и драма с десятью сценами дадут разную экономику на одной и той же ставке.
Чем это отличается от двух прошлых моделей
Рядом стоят две вещи, с которыми новинку будут сравнивать. Kandinsky S2V это открытая модель для говорящего аватара: она берёт одну картинку человека и запись речи, веса лежат открыто, платить за секунду не нужно. Wizshot 1.0 это предыдущая модель Baidu про видео по референсам, там логика входов устроена иначе.
Wizshot-ME заходит с третьей стороны: сценарий целиком, с озвучкой и мимикой в одном проходе. Для ролика на минуту это дешевле по времени, для одного шота в пять секунд Kandinsky S2V остаётся проще.
Мой вывод
Я смотрю на эту модель как на инструмент под длинную форму: объяснение на камеру, разбор, диалог в кадре, короткая драма. Там, где сценарий идёт минутами, склейка кусков по тридцать секунд слышна, и одна озвучка на весь текст закрывает проблему, которую монтажом не лечат.
Для клиентской работы порядок не меняется: видео нейросетями собирается по сценарию и раскадровке, потом идёт проверка на десяти секундах проблемной сцены. Ручные ролики от 16 000 ₽ остаются вариантом, когда в кадре нужен человек и живая реакция на площадке.
И последнее. Пока модель существует в виде анонса, прайса и документации. Демо на конференции это витрина, а обещания про лидерство проверяются на своём материале за один тестовый ролик. Совпало, инструмент остаётся в пайплайне надолго. Не совпало, остаётся строчкой в подписке на новости Baidu.