Что HeyGen открыла 9 ноября
9 ноября 2026 HeyGen написала в посте @HeyGenDev и обновила developers.heygen.com: открыты HeyGen Platform и Playground. В одном месте теперь можно напрямую тестировать свои модели Video, Voice и аватаров, а затем брать те же модели через API в продакшне. Новой модели речи в этом запуске нет, и это стоит сказать сразу, чтобы не искать её в чейнджлоге.
Мне в этом запуске важна исчезнувшая развилка между тестом и продакшном, а список моделей сам по себе ничего не решает. Раньше тест в интерфейсе и код в продакшне жили отдельно, и расхождение всплывало на первом же клиентском ролике. Теперь проверка и продакшн идут по одному набору моделей, и спор «в интерфейсе работало» закрывается ссылкой на тот же движок.
Хейген нейросеть аватар: зачем проверять в Playground
Запрос «хейген нейросеть аватар» обычно означает одно: человек хочет увидеть, как его лицо и голос звучат в готовом кадре, до того как за это заплатили. Playground отвечает ровно на это, потому что рядом лежат Video, Voice и аватары, и на одном тексте можно сравнить, как звучит один и тот же сценарий на разных движках.
Практическая польза скромнее, чем у релиза новой модели, и я считаю это плюсом. За час в Playground видно, тянет ли движок конкретный голос на длинной фразе, как он ставит паузы, где ломается на именах и числах. Эти вопросы раньше выяснялись на оплаченном рендере.
Как создать цифрового аватара в HeyGen и не перерисовывать весь ролик
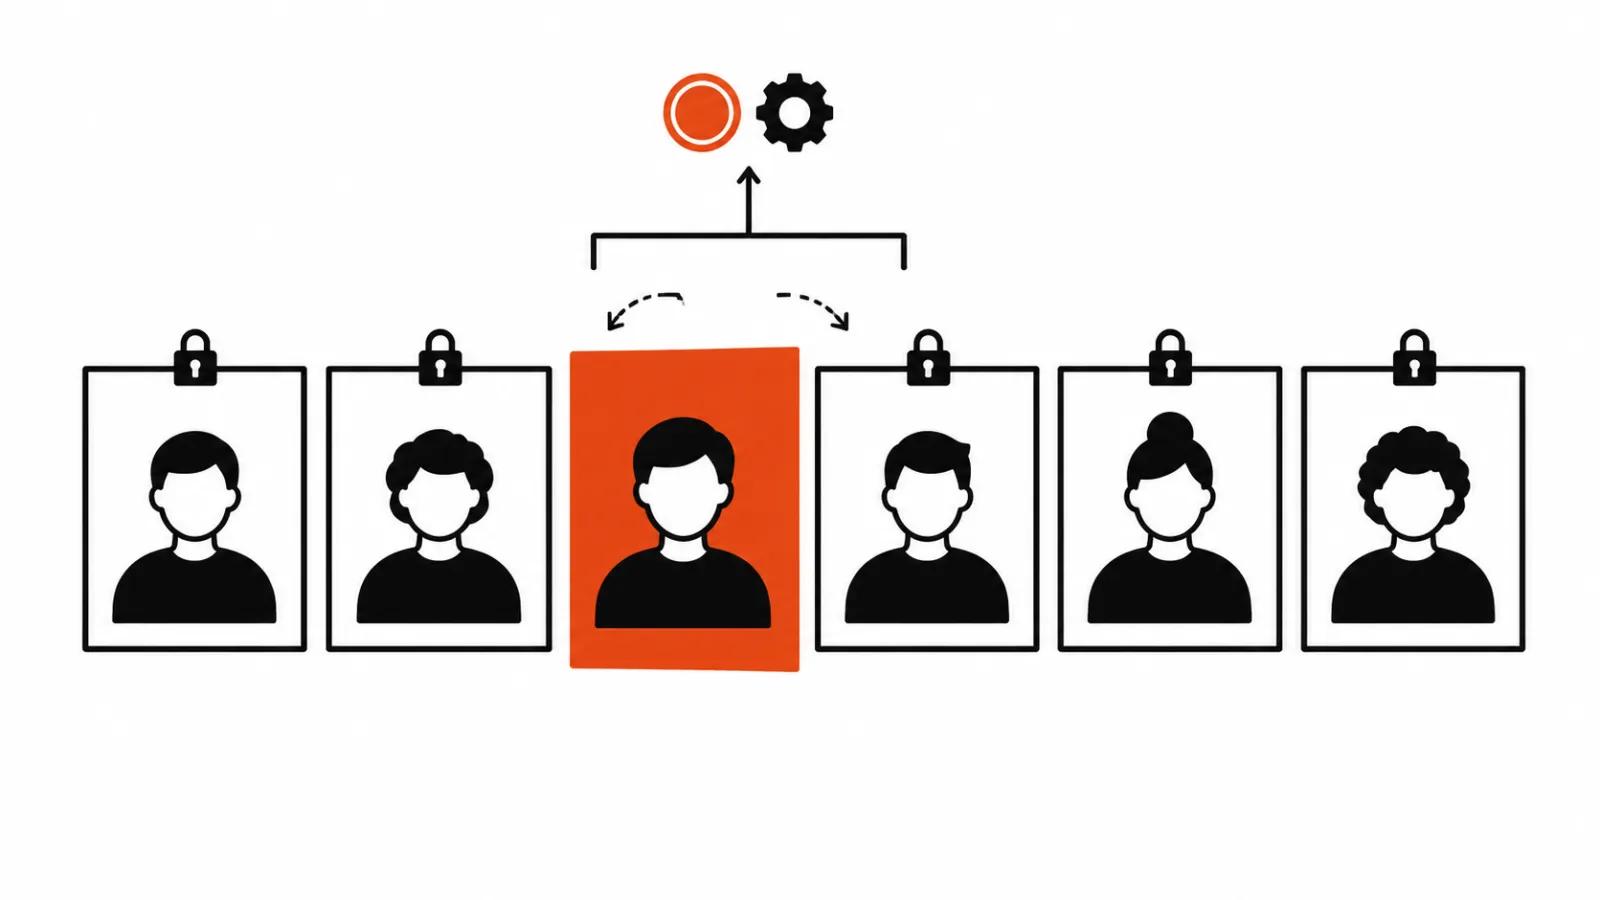
Короткий ответ: аватара и голос выбирают один раз, а дальше правят только те сцены, где что-то поменялось. Именно это изменение из ноябрьского чейнджлога и стоит за словом «правка».
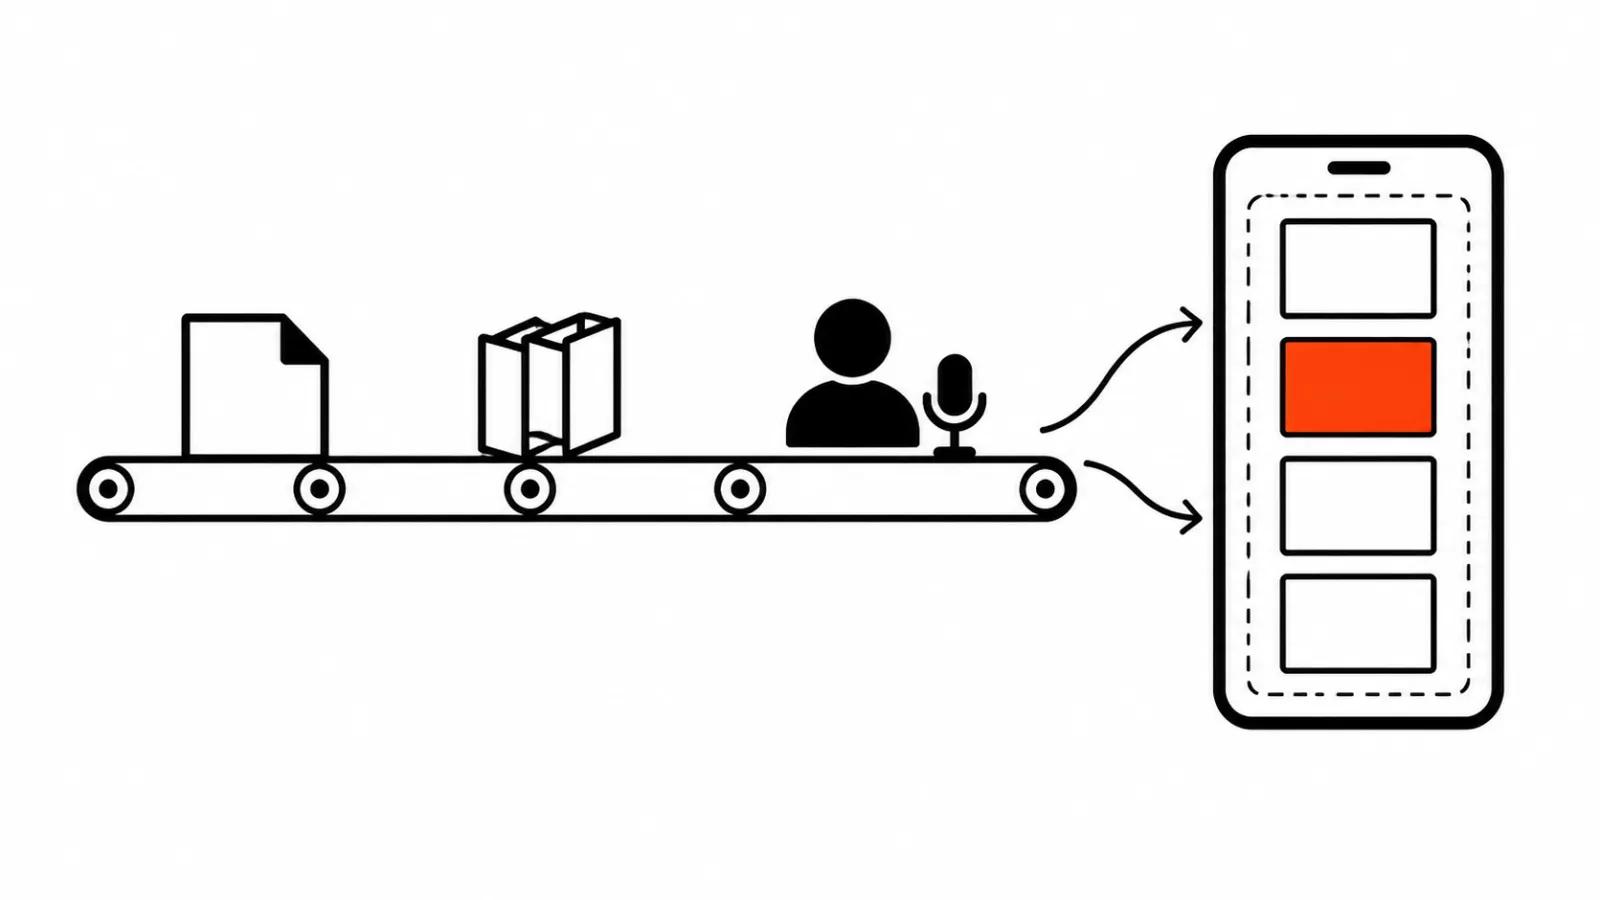
Вот как это выглядит в API. Запрос POST /v3/videos/{video_id} меняет текст сценария, голос, движок аватара и промпт движения, и делает это по id сцен. video_id остаётся прежним, перерисовываются и оплачиваются только те сцены, которые вы тронули. Остальные остаются как были, вместе с уже оплаченным рендером.
Для одного ролика это приятная мелочь. Для серии из тридцати аватар-роликов в месяц это разница в смете и в сроках, потому что правки приходят пачками: клиент поменял цену в третьей сцене, поправил название продукта в седьмой, попросил другой тон в приветствии. Раньше каждый такой комментарий означал новый прогон всего ролика.
Правка по сценам: что остаётся прежним
Соблазн объявить это новой эрой есть, и он преждевременный. Меняется единица работы, качество кадра остаётся прежним. Если движок аватара дал странную мимику на слове «доставка», правка текста в этой сцене её не вылечит, потому что лечится другое место.
Второе, что остаётся прежним: сценарии пишут люди. API принимает текст, голос и промпт движения, и от формулировки по-прежнему зависит, попадёт ли ударение в нужное слово.
И третье, самое неудобное. Пока не проверено, как перерисованная сцена сшивается со старой по свету и по голосу, обещать клиенту бесшовный результат рано. Ставлю это как рабочее сомнение: на стыке двух рендеров может вылезти разница в оттенке кожи и в громкости.
HeyGen AI аватары в Cinematic Avatar
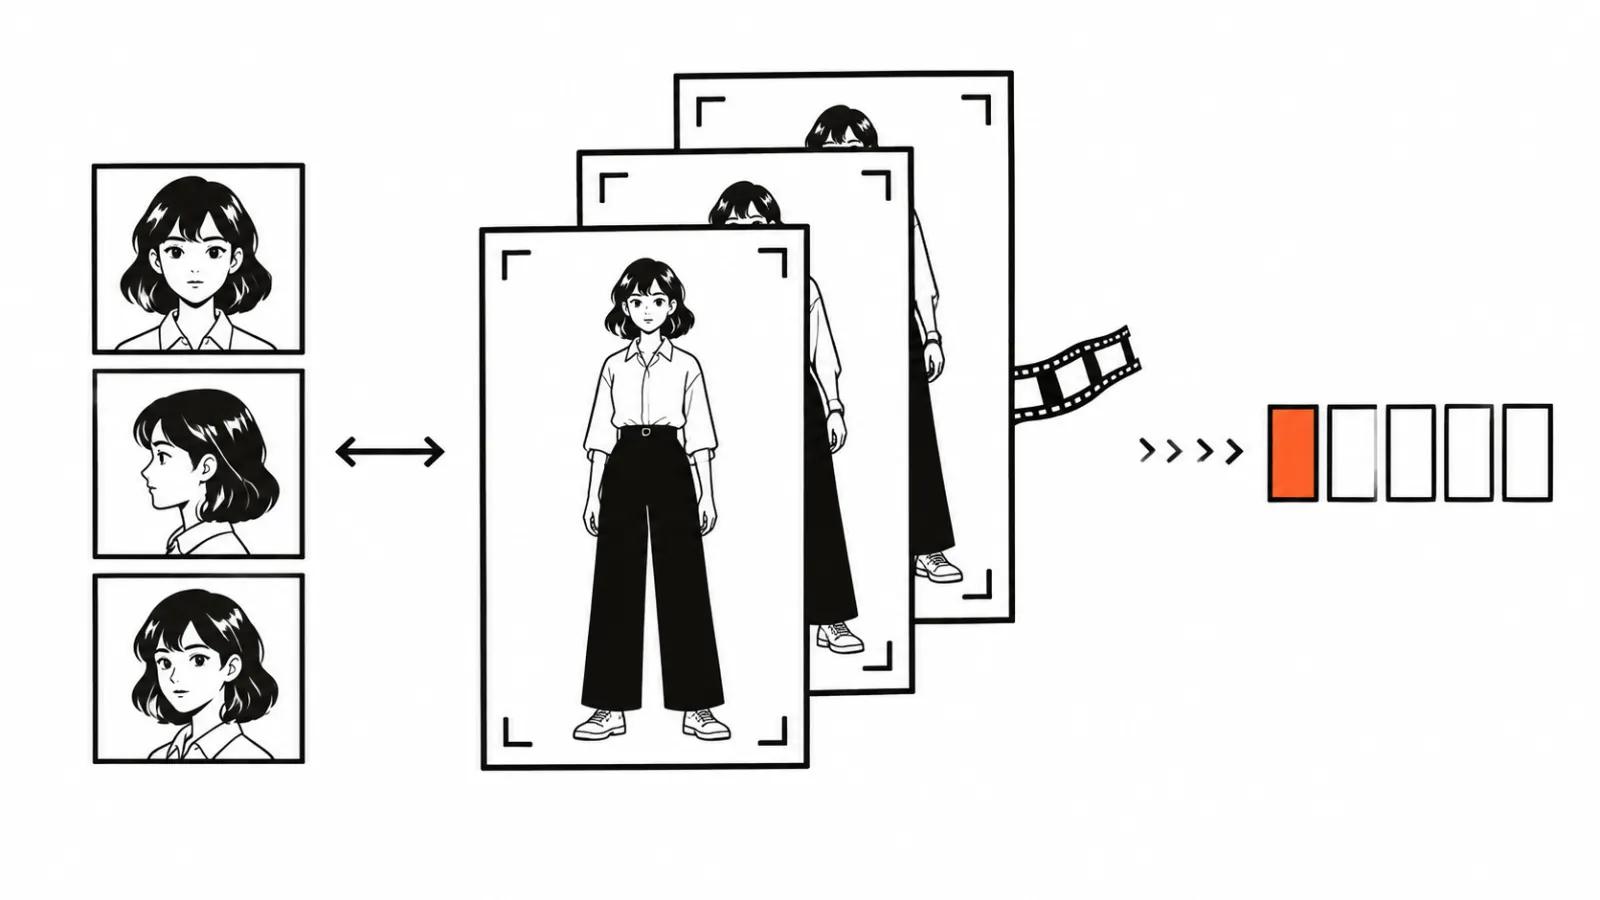
Отдельная запись в чейнджлоге касается съёмки. Cinematic Avatar работает на модели heygen_video_1, и логика у него театральная: ваши аватары и их голоса становятся актёрами шота. Доступны 16:9 и 9:16, 720p, длина 5-15 с, а на входе вместе с картинками и видео принимается до трёх аудиореференсов.
Три аудиореференса это самое интересное место. Голос, темп и манеру подачи задаёт образец, ползунков там нет, и для рекламного шота это ближе к работе с актёром, чем к синтезу. Ограничение по длине честное: 5-15 с, это длина шота, целую сцену так не собрать. Вертикаль 9:16 и 720p говорят о том же, что и длина, это материал для ленты и для вставок между крупными планами.
Аудиотеги, поток и форматы речи
Три изменения в голосе выглядят мелкими и по делу оказываются крупными.
Аудиотеги. В тексте можно писать [whispers], [laughs] и другие пометки, поддерживается 201 тег. Работает у публичных и у instant-голосов. Профессиональные клоны теги не исполняют, и это ограничение стоит держать в голове при выборе голоса под задачу: там, где нужен шёпот по сюжету, клон не поможет.
Потоковая озвучка по WebSocket. Текст приходит кусками, например токенами из LLM, аудио уходит на выход, до пяти контекстов на одно соединение. Для диалогового бота или для озвучки, которая рождается на ходу, это единственный рабочий режим, потому что ждать полного текста там нельзя.
Форматы речи. pcm, mp3, ulaw, alaw и частота от 8 до 48 кГц. Скучная строчка, которая экономит день интеграции, когда звук надо отдать в телефонию или в монтаж без лишней конвертации.
Для контекста одной фразой: из октябрьских записей HeyGen Video делает клипы 5-30 с по тексту и картинке, а reference-to-video тянет до 15 с. Подробности про эту линейку я разбирал отдельно, в текстах про HeyGen Video 1 с MCP и про 2K и бесплатный голос, там речь шла о модели и разрешении. Здесь речь о платформе и о правке, и это разные истории.
Где правка по сценам окупается
Прямая экономия считается на потоке. Аватар-ролики почти всегда идут сериями: приветствие, три преимущества, цена, призыв. Правки в такой серии приходят после каждого согласования, и каждая раньше стоила полного рендера.
Вторая экономия тише, это время. Пока рендерится весь ролик, монтажёр ждёт и не делает следующую сцену. Когда перерисовывается одна сцена, работа идёт дальше, и день не разваливается на ожидание.
Третья статья экономии касается денег на стороне. В ноябрьских записях цен нет, и я их не придумываю. Считать стоит по факту: сравнить стоимость полного перерендера серии с оплатой изменённых сцен на своём объёме.
У нас такие серии собираются в рамках видео нейросетями, а когда нужен человек в кадре и контроль по свету, это уже ИИ-аватары под ключ. Для канала с регулярным выпуском правка по сценам ложится в YouTube-канал от 16 000 ₽ в месяц, где серия собирается по расписанию и правки идут по ходу.
Мой вывод
Правка по сценам важнее любой новой модели, и я готов это защищать. Модели меняются каждый месяц, а стоимость правки остаётся в смете каждый день. Пока перерендер стоит как новый ролик, студия боится трогать готовый материал, и клиент получает компромисс вместо исправленной фразы.
Что я делаю на новом проекте: собираю ролик по сценам с запасом, проверяю стык перерисованной сцены со старой на первом же изменении и только потом обещаю клиенту быстрые правки. Если стык по свету и голосу виден, честнее перерисовать соседнюю сцену, чем объяснять разницу характерами.
И последнее. Платформа и Playground снимут часть слепых прогонов, правка по сценам снимет часть переделок. Ни то, ни другое не отменяет тест на десяти секундах проблемного кадра, потому что именно там видно, тянет ли движок конкретный голос и конкретное лицо.