Что выложили 13 ноября
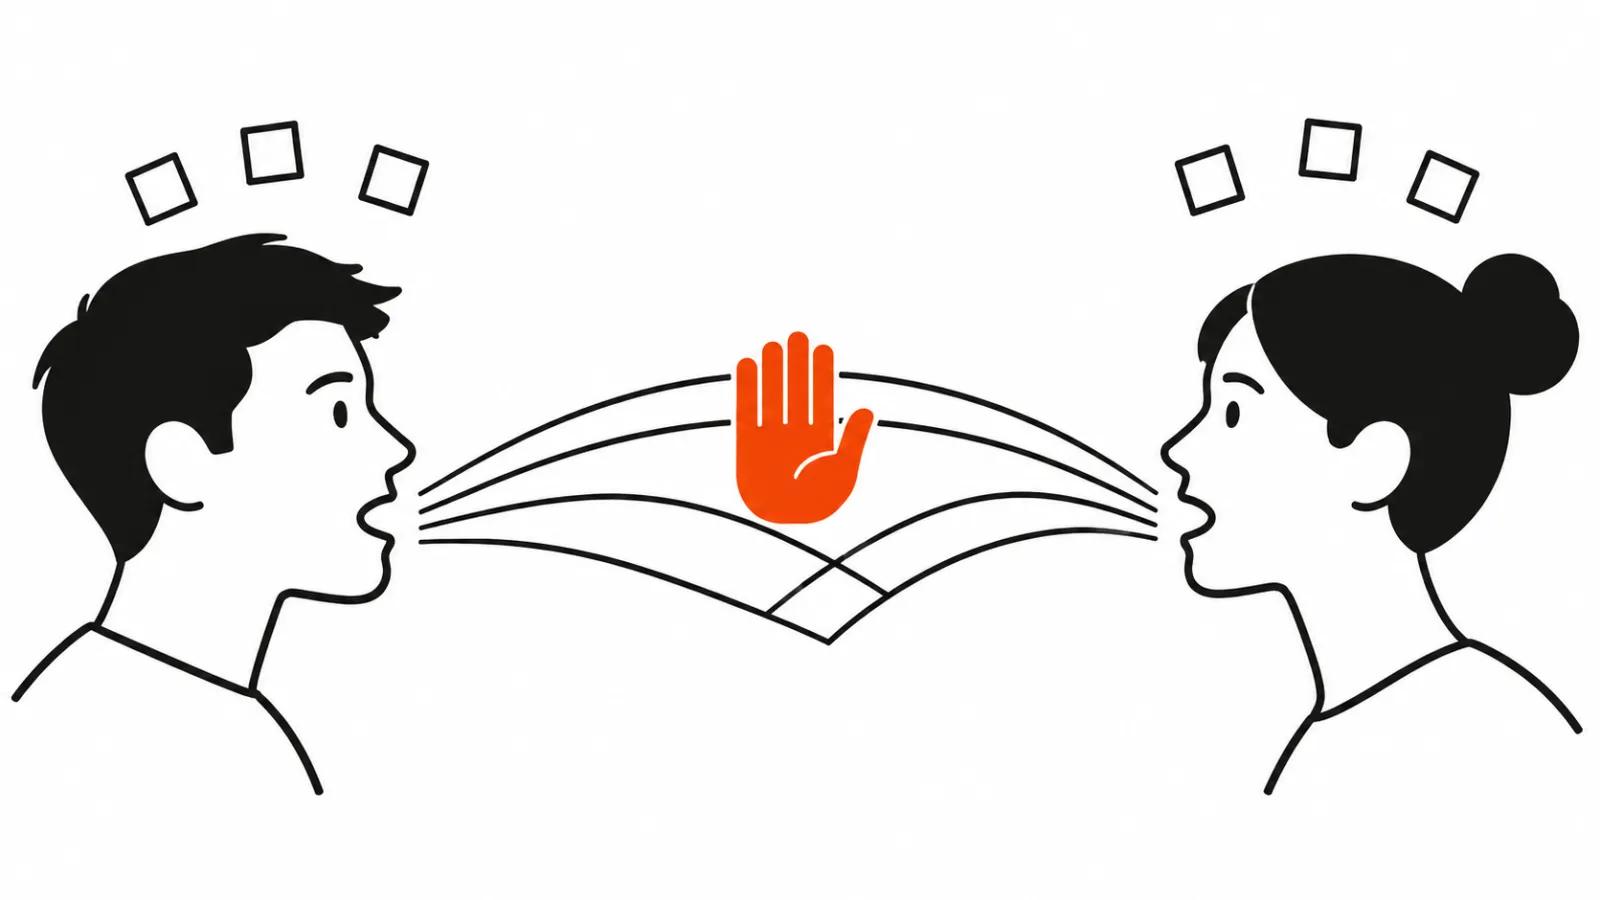
13 ноября 2026 команда inclusionAI открыла модель Duo v1 и выложила статью на arXiv. Авторы описывают её как Reciprocal World Model: модель непрерывно смотрит видео собеседника, слышит его голос и одновременно отвечает своим видео и своим звуком. Разговор допускает перебивания, паузы и всё то, что делает беседу спонтанной.
Слово «дуплекс» пришло из телефонии. Обычный разговор идёт в полном дуплексе: оба говорят, оба слушают, никто не ждёт своей очереди. Видеогенерация до сих пор жила в полудуплексе, потому что на входе был текст или картинка, а на выходе файл. Здесь вход и выход идут в одном такте, и это меняет сценарий использования сильнее, чем любая прибавка к разрешению кадра.
Аватар нейросеть Duo v1: две модели в одном такте
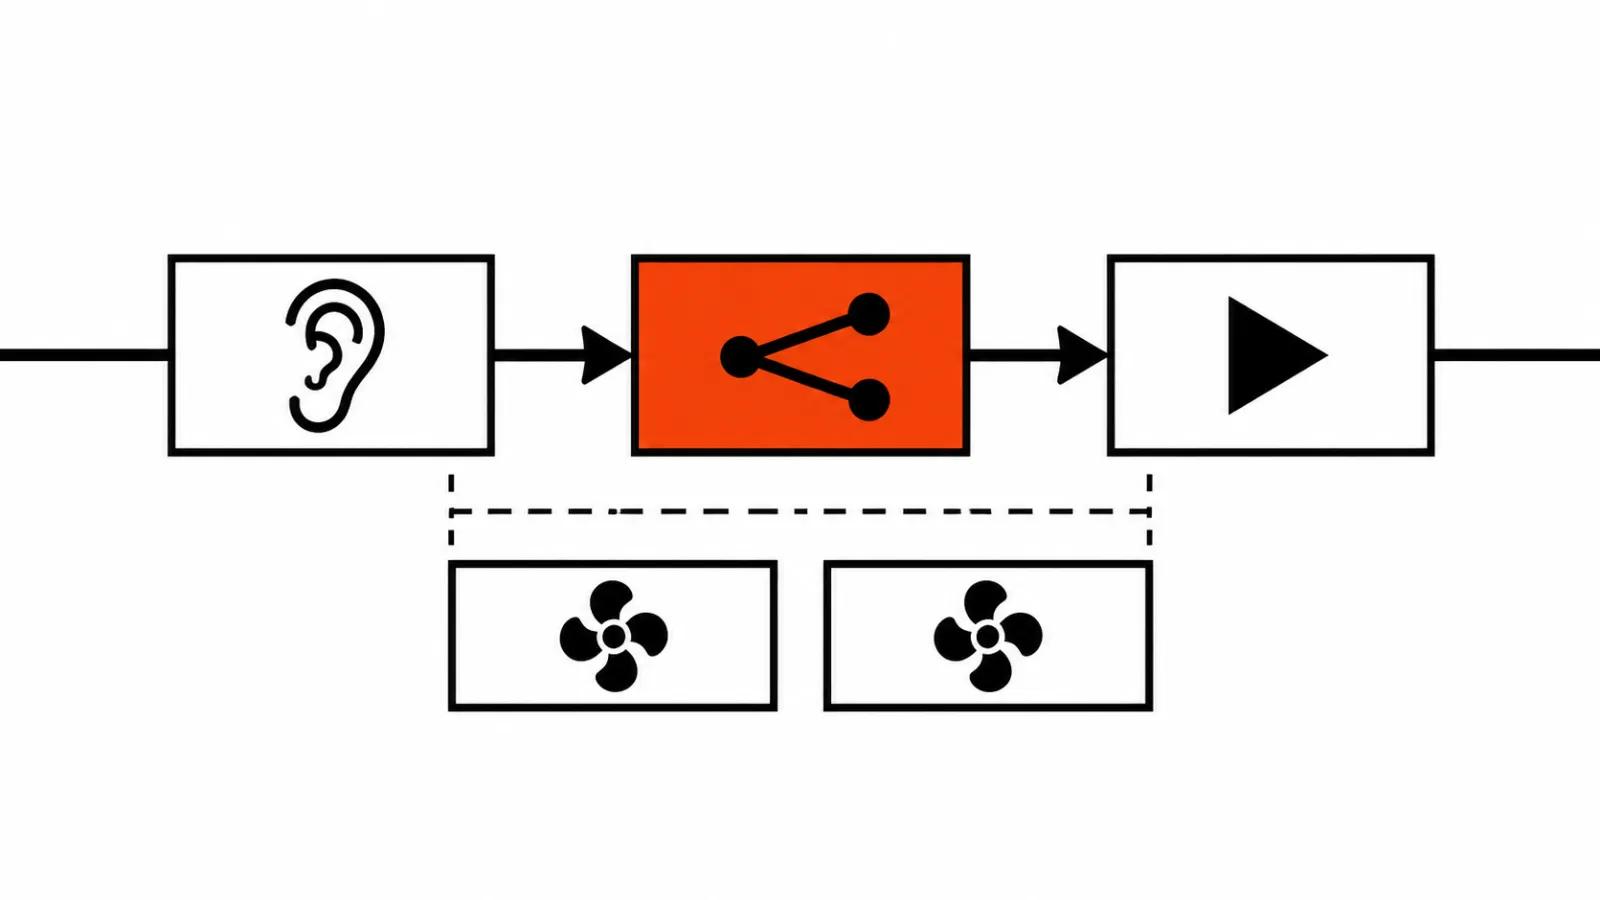
Внутри две части с разной работой. Intent это авторегрессионная мультимодальная модель, она решает, вступать ли в разговор прямо сейчас и что именно сказать. Realization это диффузионная модель, она генерирует видео и звук ответа. Обе части синхронизированы на одной временной шкале и работают кусками, поэтому картинка не отстаёт от голоса.
Маски внимания не дают модели заглядывать в будущие входы. В момент ответа она знает только то, что уже прозвучало. Живой человек в разговоре тоже не знает, что скажет собеседник через секунду, поэтому перебивание и пауза выглядят естественно.
Что в пакете и сколько железа нужно
Состав разложен по карточкам Hugging Face. Duo-1.0-causal-base это полный пакет: Realization, Intent, видео- и аудиокодеки, распознавание речи Qwen3-ASR и выравнивание. Duo-1.0-distill собирает ответ за 4 шага вместо 50 у базовой версии, Duo-1.0-distill-quant сделан в FP8, а Duo-1.2-causal-base несёт улучшение качества. Код открыт под Apache-2.0.
Веса инициализированы от MiniMax H3 и дообучены командой Duo. Условия лежат в LICENSE и NOTICE, и это отдельная работа для юриста: открытый код и открытые веса живут по разным правилам, лицензию MiniMax H3 надо читать до коммерческого запуска.
Железо серьёзное. Нужен Linux, Python 3.10 и выше, FFmpeg и две видеокарты CUDA: на одной живут Intent и кодеки, на второй Realization. Для потокового запуска есть ветки через vLLM-Omni и SGLang-Omni. Одна карта этот сценарий не тянет.
Цифры, которые называют авторы
Пересказ AI Weekly от 13 ноября приводит такие данные. Видео и звук генерируются кусками по 0,71 с. На 30 живых разговорах пройдено 93,3% из 180 критериев, по соблюдению языка и разборчивости речи 100%, по синхронизации губ 90%. Первая реакция занимает 330-650 мс на восьми GPU. Цифры идут из статьи авторов через чужой пересказ, сам я их не перепроверял.
Для практики важнее задержка, чем средняя оценка. Первая реакция за 330-650 мс в живом разговоре воспринимается как короткая пауза перед ответом, и при этом получена на восьми видеокартах.
Где ИИ аватар для видео пока не работает
Duo v1 это превью для исследователей, и авторы прямо пишут, что поддерживается базовый аудиовизуальный разговор. Для рекламы и роликов это пока не инструмент: там нужна повторяемость кадра, монтаж, правки по замечаниям клиента и один и тот же человек в серии версий. Разговорная модель живёт в другом режиме, её ответ нельзя откатить на десятом дубле.
Другое дело живые сценарии. ИИ-аватар для поддержки, который видит человека в камере и отвечает мимикой в том же такте, становится реальнее. Стрим с аватаром, который слышит чат голосом и отвечает лицом, тоже стал ближе. Пока это лаборатория, но направление понятное.
Сейчас видео и распознанный текст собеседника проходят через Intent, а тот уже направляет Realization. В обещанной Duo v2 авторы хотят подавать звук и видео пользователя прямо в Realization, это и есть визуальное взаимодействие из их таблицы релизов.
Пока такие вещи не дошли до продакшена, обычная работа идёт прежним путём: видео нейросетями собирают по сценарию, кадрам и звуку, и на выходе получается ролик, который можно править. Живые персонажи в этой логике уже обкатаны, у нас есть отдельный разбор Vidu S2 Avatar Reactor про живого персонажа.
Мой вывод
Открытых моделей выходит по несколько в неделю. Главное здесь то, что полный дуплекс доехал до видео и звука в одном такте, и теперь разговорный аватар перестаёт быть аттракционом с задержкой. Это архитектурный сдвиг, и он важнее прибавки к метрикам.
Ставку я бы делал на поддержку и стримы. В разговоре с оператором перебивание это норма, и модель, которая его выдерживает, экономит минуты ожидания. В рекламе перебивать никого не нужно, там ценится контроль над кадром.
Сдерживают три вещи: две видеокарты на запуск, куски по 0,71 с и лицензионная надстройка от MiniMax H3. Железо со временем дешевеет, а лицензия потребует разговора с юристом. Смотреть за проектом стоит по ветке Duo v2, там обещают прямое использование видео собеседника.