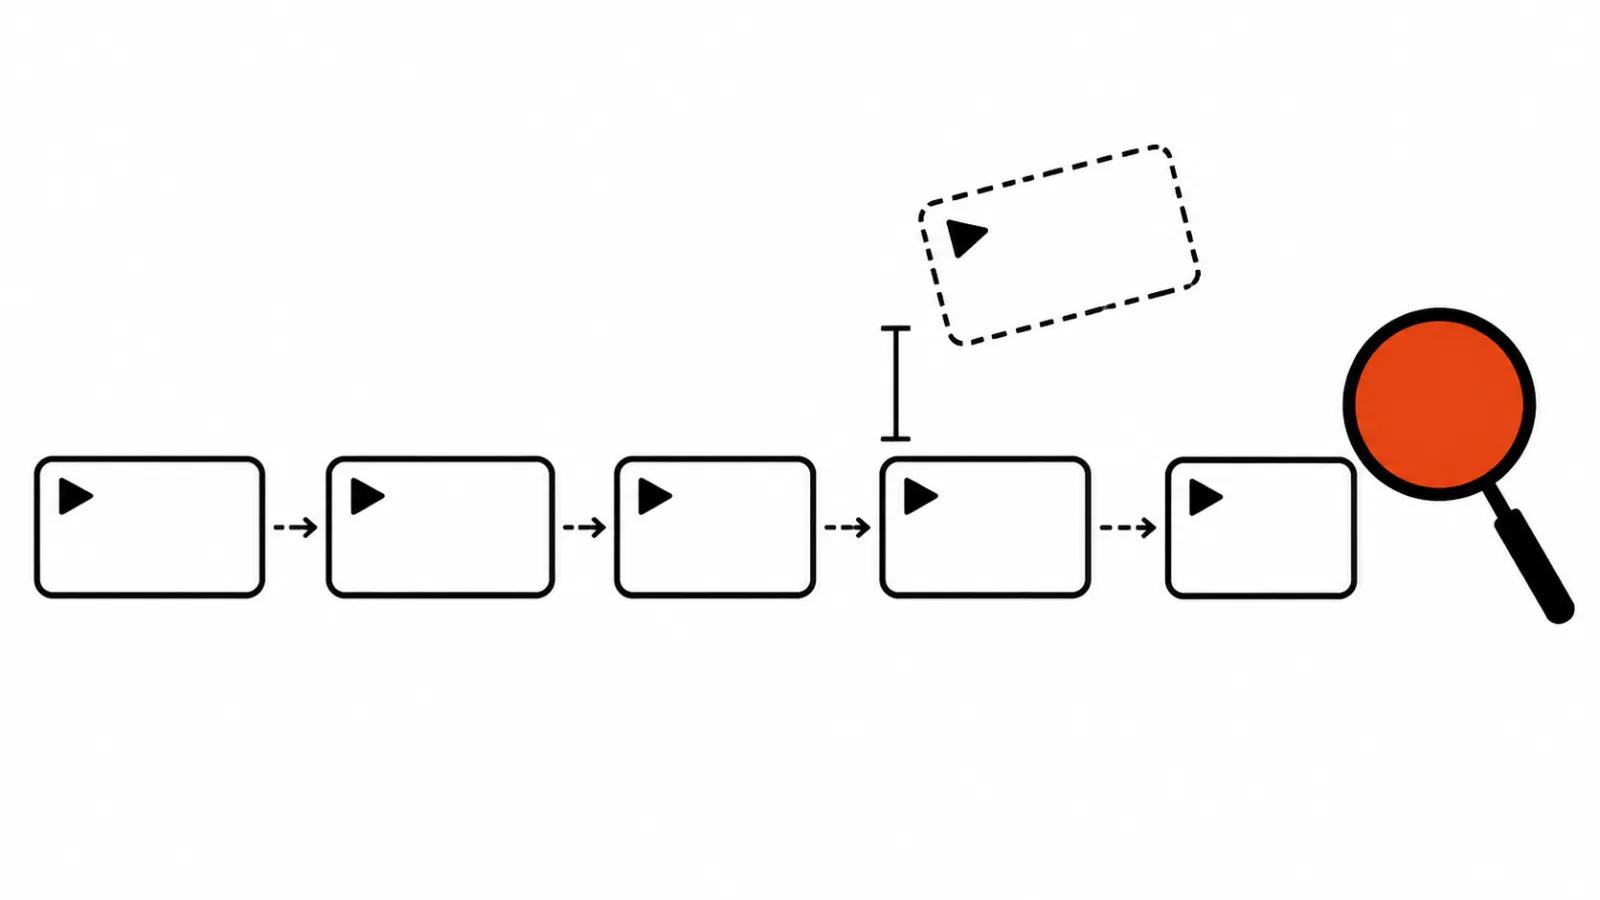
Что предложили 18 ноября
18 ноября VideoTech Wire разобрал статью «Can a World Model Predict a Deepfake Video? A Consistency-Margin Prior for Deepfake Detection». Идея уже в названии. Если модель умеет предсказывать, каким будет следующий фрагмент ролика, то подделка выдаст себя там, где предсказание промахнётся. Искать в кадре нечего: детектор смотрит на поведение видео во времени.
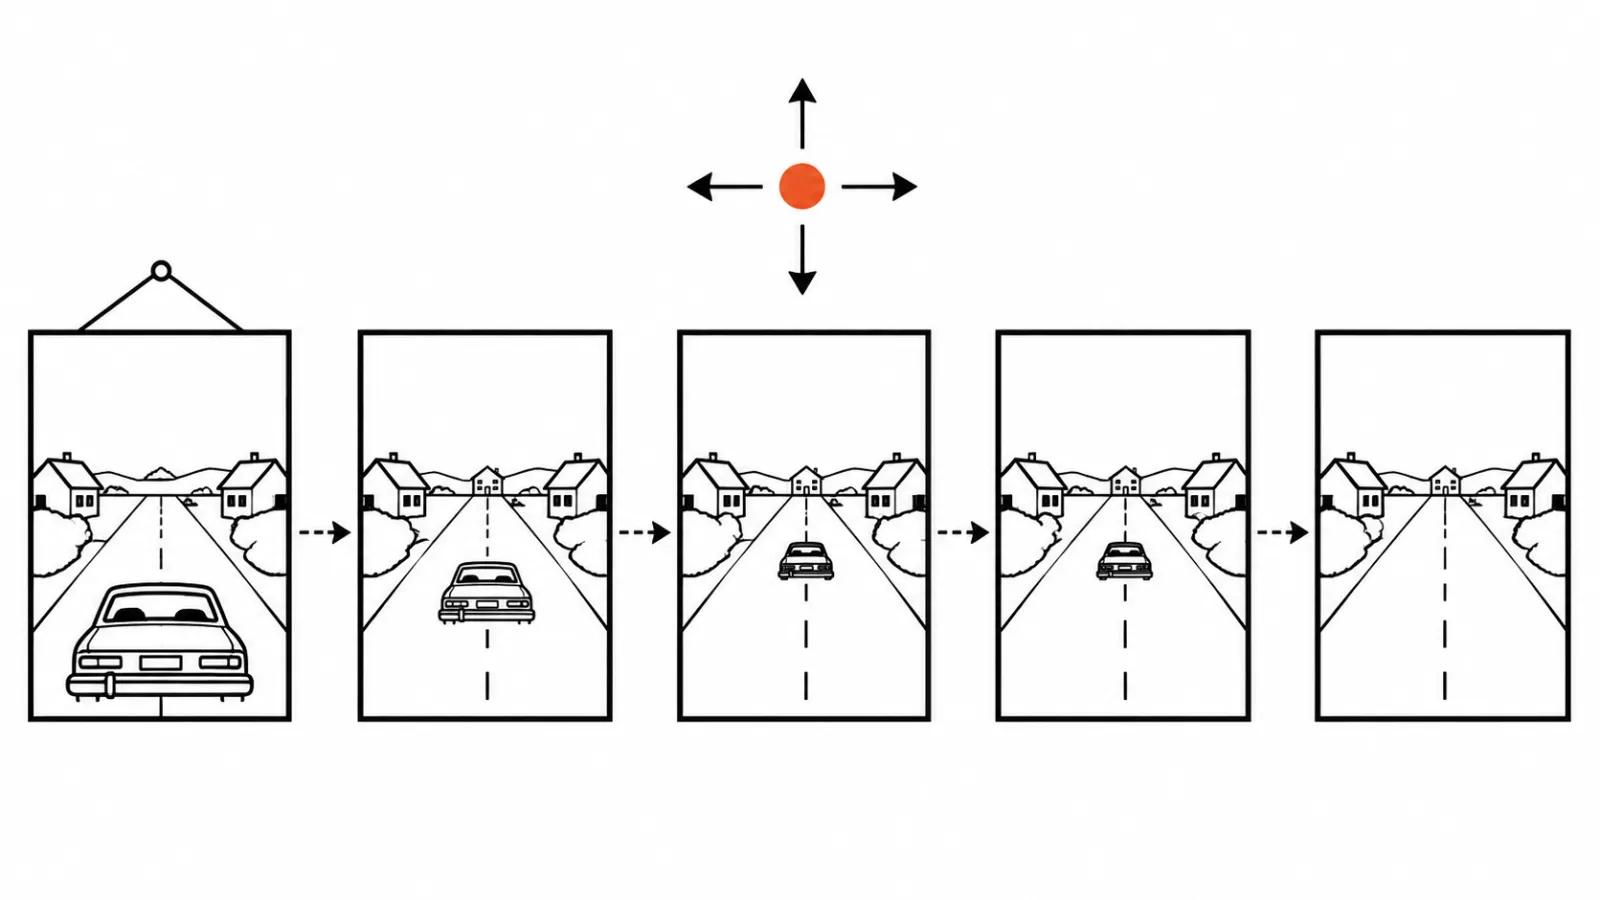
Внутри всё держится на сравнении. Замороженный энкодер V-JEPA 2.1 переводит кадры в скрытое представление: набор чисел, в котором описано, что происходит в сцене. Предсказатель, дообученный через LoRA ранга 16, получает начало ролика и говорит, каким должно быть продолжение в том же скрытом виде. Дальше два описания сравнивают, а разницу авторы называют остатком предсказания.
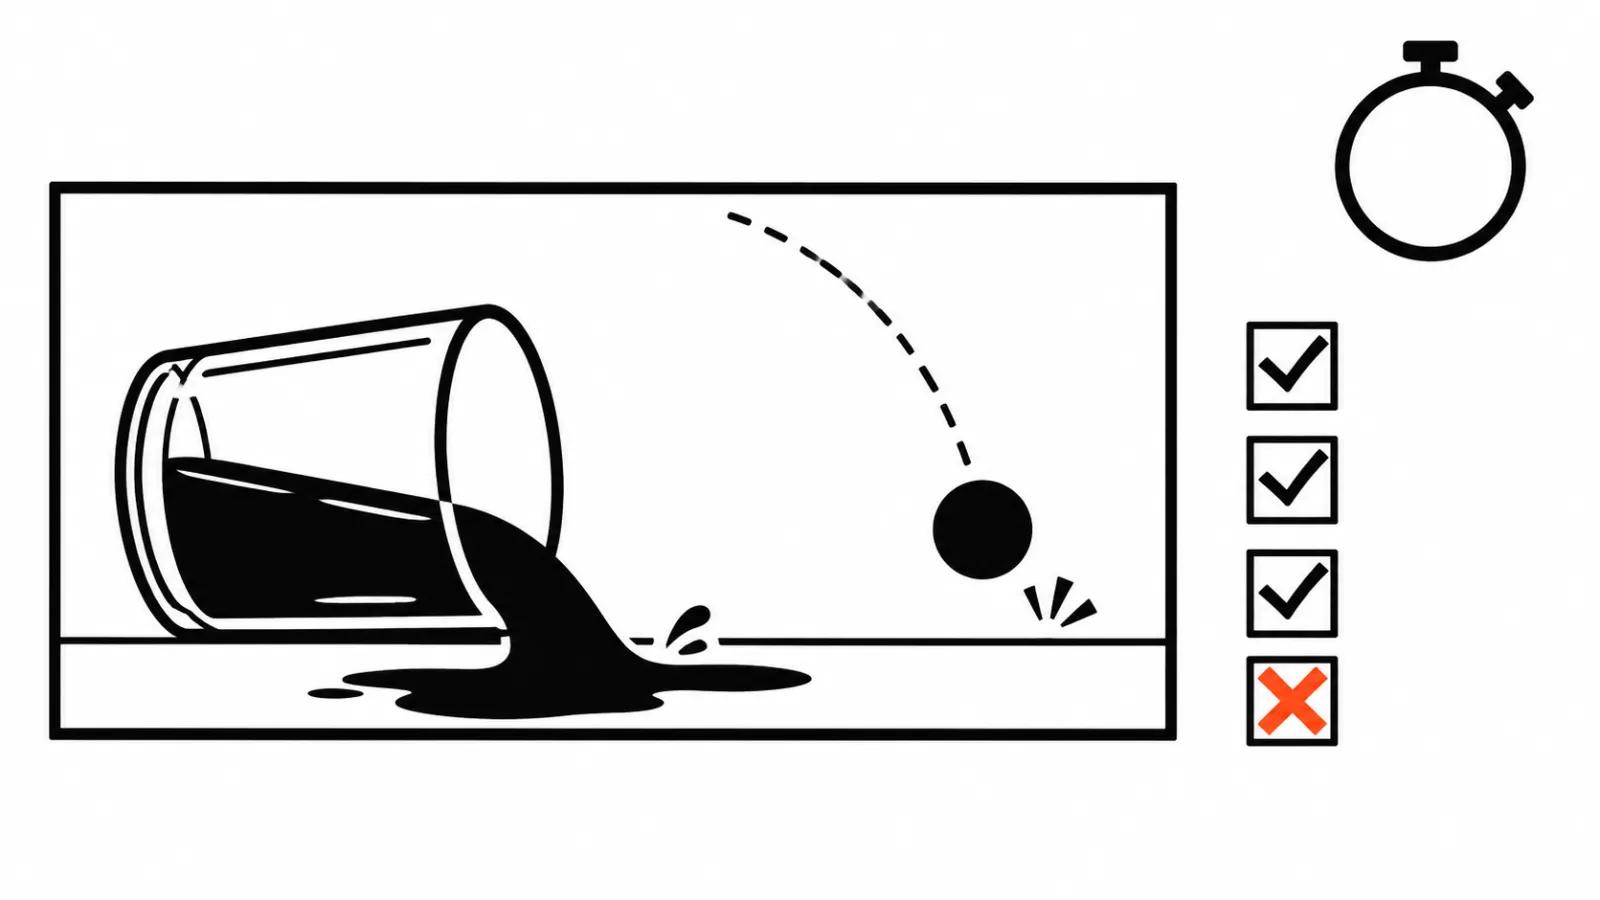
Гипотеза простая: у подделок остаток в среднем больше. Настоящий ролик продолжает сам себя, потому что в нём держатся свет, тени и постоянство объектов. Синтетический ролик, по этой логике, держит такую связность хуже, и модель мира видит в нём больше непредсказуемости.
Как считается остаток предсказания
Шагов три. Сначала энкодер смотрит реальные кадры и выдаёт своё описание сцены. Потом предсказатель по первым кадрам строит догадку о следующем фрагменте. Потом догадку сравнивают с тем, что энкодер увидел на самом деле, и получают число.
Это число ничего не говорит о пикселях. Модель не проверяет, ровные ли пальцы и не плывёт ли надпись на вывеске. Она проверяет, укладывается ли продолжение ролика в то, что она ждала от сцены с таким светом, такой камерой и такими объектами.
Метафора простая. Возьмите ролик, где человек идёт по улице, и покажите первые две секунды знакомому, который улицу знает. Он доскажет, что должно быть дальше: шаг, тень, проезжающая машина. Если вместо этого появится что-то неожиданное, он удивится. Детектор удивляется так же, только в числах.
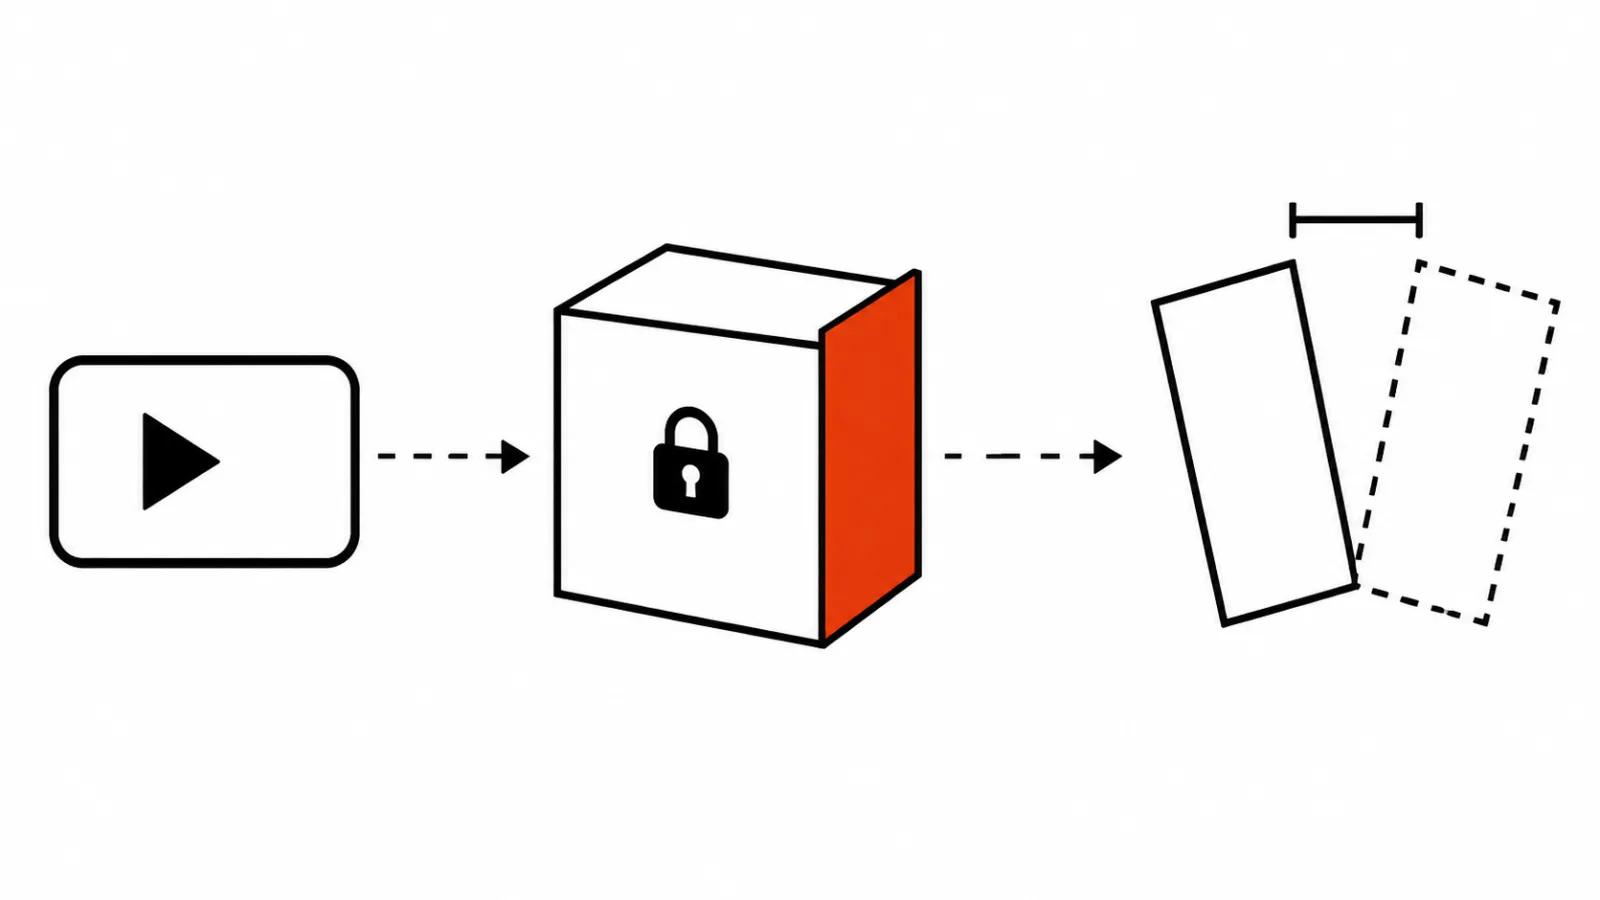
Голова согласованности и восемь миллионов параметров
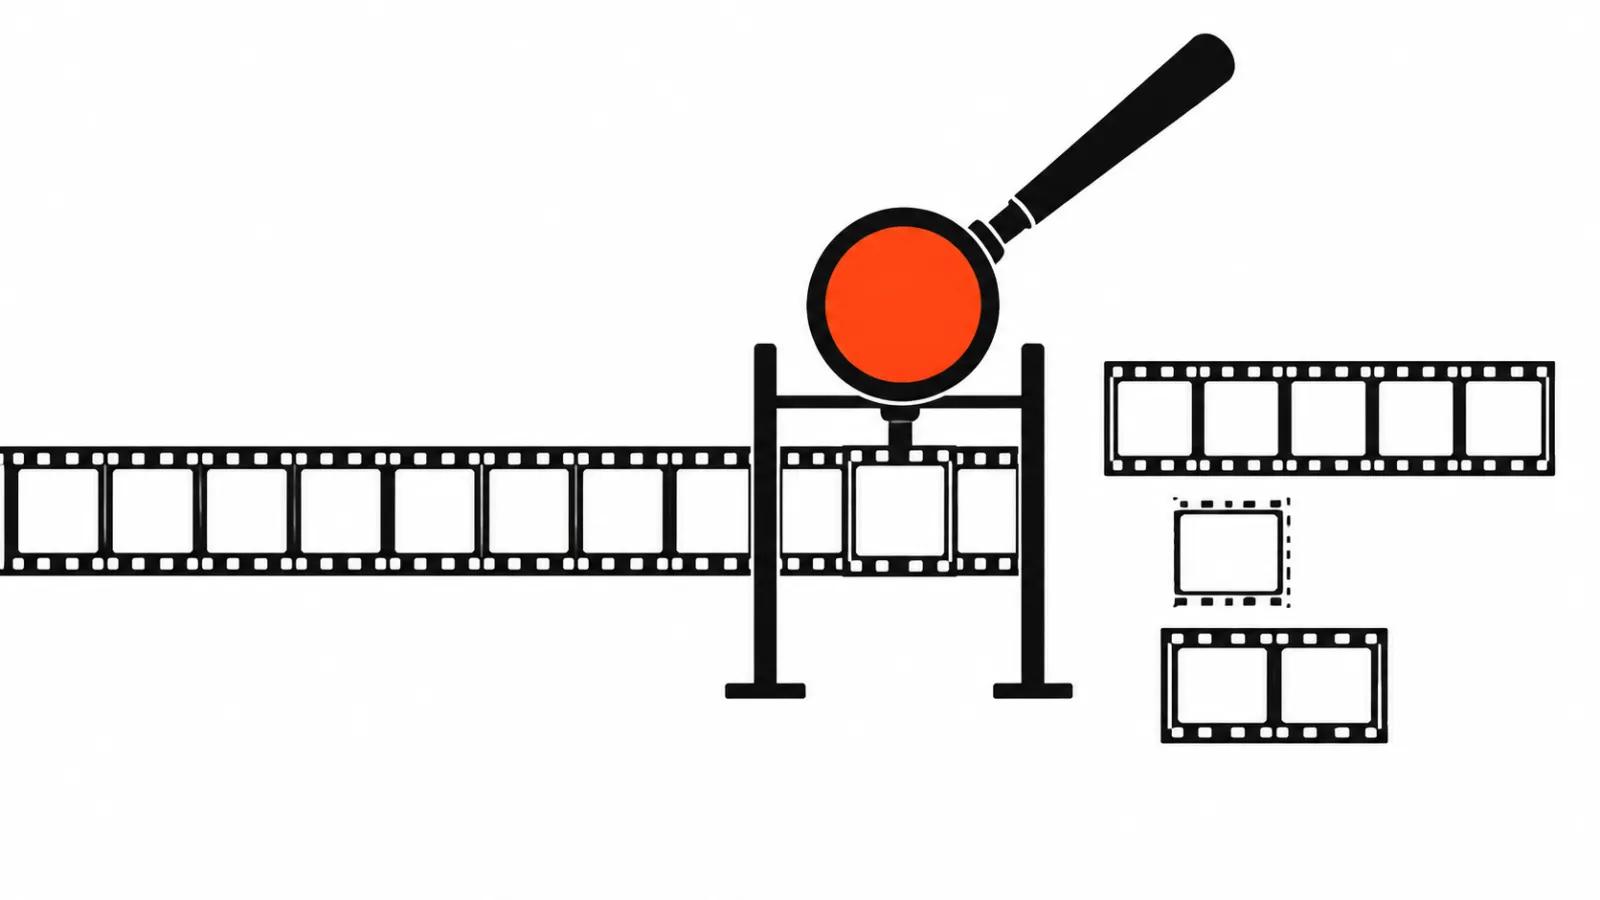
Поверх остатка стоит лёгкая «голова согласованности». Она учитывает две вещи по отдельности: величину остатка и его направление. Величина отвечает на вопрос «насколько сильно модель удивилась», направление на вопрос «куда именно ушло расхождение». Из этих двух сигналов и собирается решение о подделке.
Масштаб обучения скромный. Обучаемых параметров 8,25 млн из 334 млн, это 2,47% от всей модели. Основной энкодер заморожен: его никто не переучивает, добавка сидит сверху. LoRA ранга 16 это маленькая надстройка к весам, которая учит модель одной задаче и не переписывает её целиком.
Для практики такой размер означает две вещи. Хорошая: детектор дешёвый в обучении, его можно переучивать под новые генераторы. Плохая: запас гибкости невелик, и на материале, далёком от обучающего набора, поведение предсказать трудно.
Чем проверка на согласованность отличается от поиска артефактов
Артефакты это то, что видно глазом: шесть пальцев на руке, плывущий текст на вывеске, рваная граница уха, слишком гладкая кожа. Детекторы на артефактах учатся на кадрах и ищут знакомые следы генерации.
Пока генераторы ломались грубо, этого хватало. Сейчас видимых артефактов становится меньше: модели заметно подтянули руки, лица и надписи. Согласованность остаётся слабым местом дольше, потому что она про физику сцены и про время. Модель мира как раз хранит представление о том, как один кадр продолжает другой.
Отсюда разница в поведении приёмки. Поиск артефактов отвечает на вопрос «есть ли в кадре следы генератора». Проверка на согласованность отвечает на вопрос «ведёт ли себя ролик как настоящая съёмка». Второй вопрос шире, и на него сложнее ответить вручную. Про то, как отличить дипфейк от живого видео по признакам в кадре, есть отдельный разбор: там собраны приёмы, которые работают без приборов.
Что цифра 90,5 говорит и чего не говорит
Авторы обучили детектор только на наборе FF++ и проверили на чужом наборе Celeb-DFv2. Получилось AUC 90,5. Расшифрую метрику: AUC показывает, насколько хорошо модель отделяет подделки от оригиналов, где 100 это идеальное разделение, а 50 уровень монетки. Девяносто с половиной на базе, которой модель не видела, это сильный результат для исследовательской работы.
Дальше начинаются оговорки, и они важнее цифры. Авторы сами пишут, что гипотеза про больший остаток не гарантирует поимку любой подделки. Как детектор поведёт себя в реальном конвейере проверки, в работе не показано. Кода и сервиса для пользователей в пересказе работы не упоминается, так что проверить чужие ролики этим способом сегодня нельзя.
Моё сомнение простое. Ролик до проверки проходит перекодирование, монтаж и сжатие площадки, а что останется от остатка предсказания после такого пути, по тексту работы не понять. До такой проверки цифра остаётся ориентиром.
Как распознать дипфейк сегодня, пока это исследование
Рабочий порядок проверки у меня такой. Сначала маркировка и водяные знаки, там где они есть: у Google это SynthID, у части генераторов метаданные в файле. Потом источник: кто опубликовал ролик, есть ли исходная съёмка, совпадает ли контекст. Потом глаза: пауза на движении, скорость моргания, стыки между сценами, звук. И отдельно детекция дублей, если один и тот же материал гуляет по разным аккаунтам в разных версиях.
Для заказчика это переводится в два вопроса к исполнителю. Каким генератором сделан ролик. Есть ли в файле маркировка и метаданные после монтажа. Если ответов нет, проверять придётся вручную, и время на это стоит закладывать заранее.
Сборка ролика нейросетями от этой темы не отменяется. Вопрос лишь в том, что на выходе у вас должно быть понятно, как сделан материал.
Мой вывод
Детектор на модели мира это шаг в правильную сторону. Он проверяет то, что подделать сложнее всего: поведение сцены во времени. Цифра 90,5 на чужом наборе при 2,47% обучаемых параметров показывает, что приём масштабируется дёшево.
Ставить на него приёмку сегодня я бы не стал. Кода и сервиса в открытом доступе не видно, данных о поведении на реальных роликах из соцсетей тоже нет. Гипотеза про больший остаток у подделок красивая и правдоподобная, но она пока живёт в статье.
Практический вывод короткий. Проверяйте ролики по маркировке, водяным знакам и источнику, а глаза держите натренированными. Когда такой детектор появится в виде инструмента, у приёмки будет второй фильтр. Первый, ручной, останется при ней.