Что именно выложила lucidml
11 ноября 2026 года небольшая независимая лаборатория lucidml показала в X сеть, которая играет в GTA V, а 12 ноября на Hugging Face появилась карточка lucidml/gta. В репозитории 630 205 008 параметров и код запуска, лицензия Apache-2.0. Кода обучения там нет. Браузерного клиента в репозитории тоже нет, демо живёт отдельно. Карточку автор пишет от первого лица, и по тону это скорее дневник эксперимента, чем пресс-релиз.
Обучение шло с нуля на датасете GG800, это 800 часов записей GTA V.
Создание видео в играх и модель мира: в чём разница
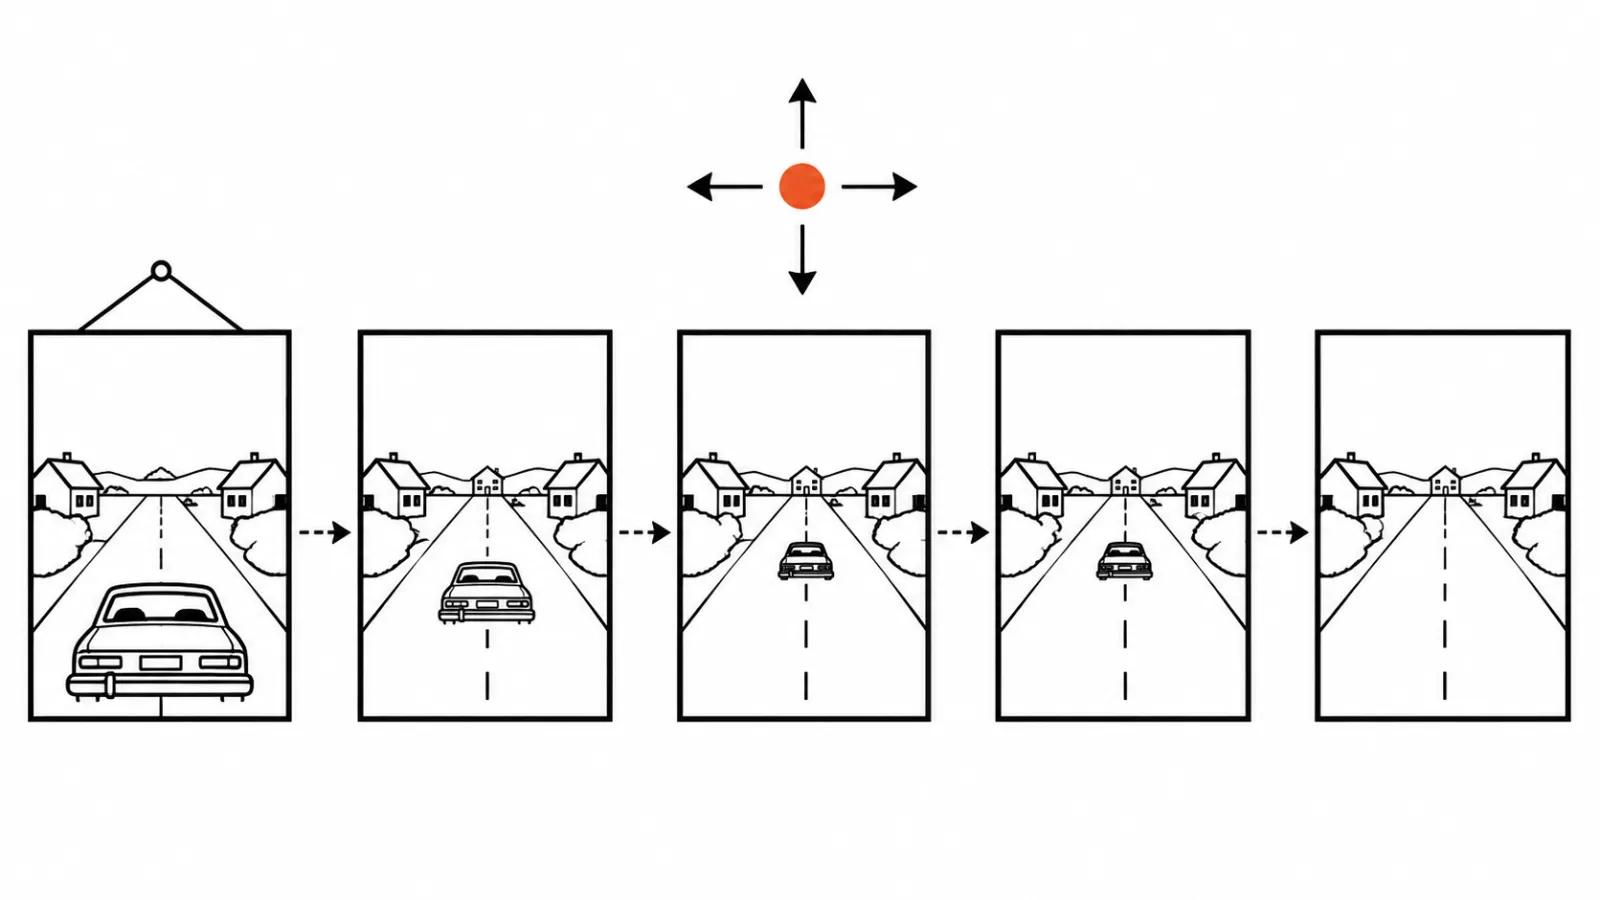
Обычная видеомодель получает текстовый промпт и рисует клип длиной несколько секунд. Модель мира устроена иначе: она предсказывает следующий кадр по текущему состоянию и по действию игрока. Действие здесь это нажатия клавиш, пять чисел. Поэтому одно и то же место в игре можно пройти двумя разными путями, и сеть достроит оба.
Простым языком, это выученный симулятор. Сеть видела 800 часов, как ведёт себя мир GTA V, и теперь продолжает его по правилам, которые осели в весах.
Отсюда и интерес к теме: создание видео в играх до сих пор означало запись экрана или монтаж захвата. Здесь видеопоток рождается в момент нажатия клавиши. Про ту же идею в другой области мы писали в материале про модели мира для роботов, где сеть предсказывает последствия движения.
Как это выглядит в работе
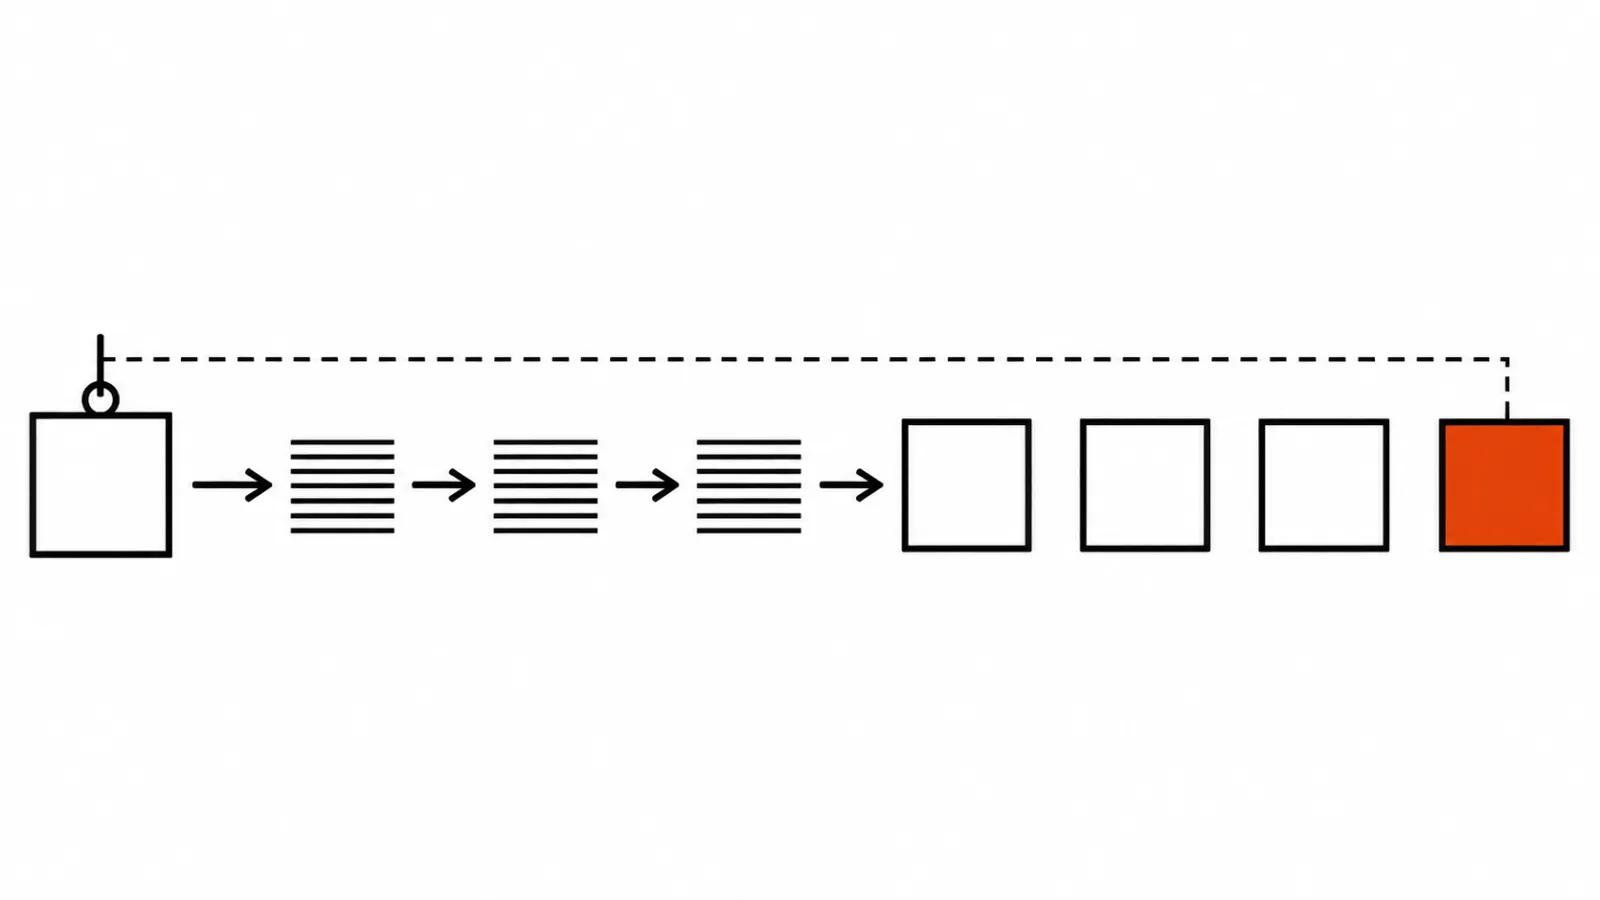
Запуск простой. Даёшь одну стартовую картинку, дальше держишь WASD, и модель генерирует следующее видео кадр за кадром, стримит результат в браузер. Текстового промпта нет вообще. Условия генерации перечислены в карточке: шаг диффузии, действие игрока, частота кадров и размер сетки. На один кадр уходит три прохода расшумления и один чистый проход, который записывается в память.
Выход скромный: 384×672, поток H.264 через WebSocket. Нужны CUDA и torch с FlexAttention, один процесс видеокарты обслуживает одного игрока. Автор пишет, что всё работает на одной потребительской видеокарте.
Как модель помнит прошлые кадры
Архитектура называется Summaryformer. Каждый шаг это целый кадр. На каждом шаге модель смотрит на текущий кадр, на два последних кадра в полном разрешении, на более старые кадры в окне 24 кадров и на стартовую картинку, которая хранится всегда.
Старые кадры попадают в расчёт не целиком. Они сжаты до 96 токенов-конспектов, и вместо 26 208 ключей модели хватает 6528. Это заметно сокращает объём расчёта на каждом шаге. Сеть собрана из 28 блоков шириной 1280.
Окно памяти это 24 латентных кадра, что равно 96 видеокадрам. Всё, что случилось раньше, живёт только в конспектах и в стартовой картинке. Стартовая картинка работает якорем: общий вид сцены не уезжает полностью, пока память вымывает детали.
Почему длинная сессия уплывает
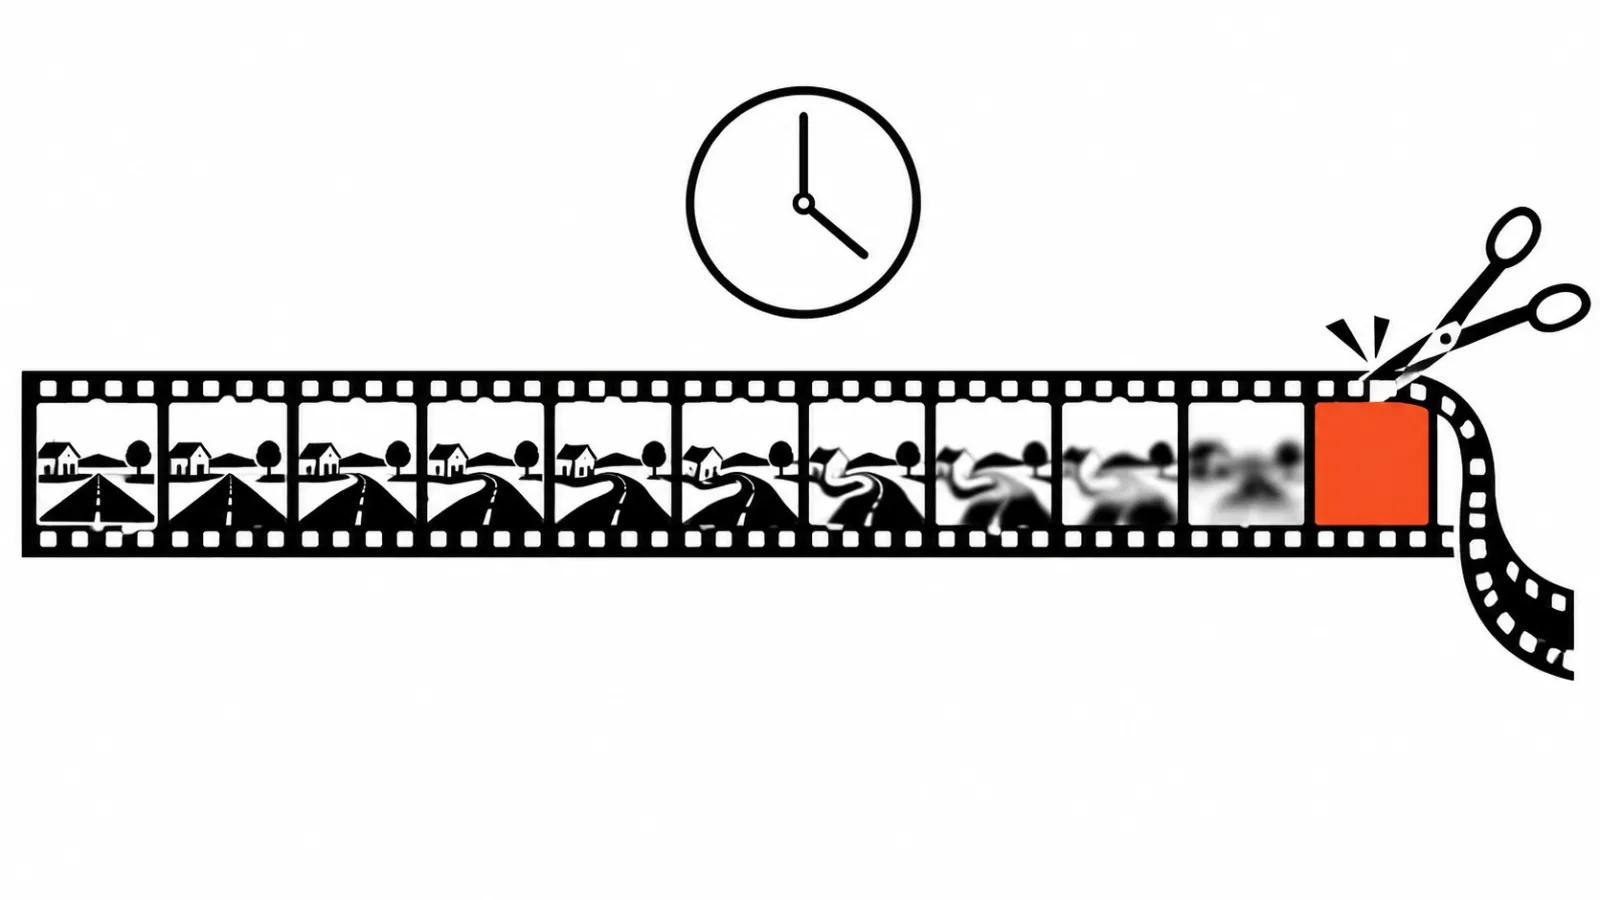
Сессия по умолчанию обрезается через 180 секунд, максимум 4096 кадров. Это честное признание ограничения. Короткая память держит недавнее движение, а дальше картинка накапливает ошибку и уплывает, об этом прямо предупреждают в разборе карточки.
Похожая логика помогает понять, почему в ИИ-видео плывут лицо и руки на длинных планах. Модель опирается на несколько последних кадров, весь остальной контекст у неё сжат. Мы разбирали это отдельно, и вывод там похожий: длинный план надёжнее собирать из коротких кусков с якорем в начале.
Почему это пока игрушка
Причин три, и все они в карточке. Первая: обучение шло на записях GTA V, права на эти записи автор не разбирает, для коммерческого продукта такая база не годится. Вторая: кода обучения нет, дообучить модель на своей игре нельзя, остаётся запускать то, что выложили. Третья: разрешение 384×672 и короткая память, на длинных сессиях картинка уплывает.
Для заказчика роликов это значит одно: инструмента, за который можно взять деньги, здесь нет. Есть демонстрация идеи.
Что из этого применимо к заказам на видео
Идея полезная, и она уже работает в обычной генерации. Опорный кадр как якорь, короткая память последних кадров, конспект старого контекста. Для видео нейросетями отсюда вытекает понятный порядок: сильный опорный кадр, короткие куски, проверка стыков. Для серии выпусков на YouTube-канал это значит, что длинный ролик нарезается на куски с общим якорем, одним проходом его не собрать.
По деньгам расклад известен: ручные ролики от 16 000 ₽, поток вертикальных видео до 0,10 ₽ за просмотр, ведение YouTube-канала от 16 000 ₽ в месяц.
Мой вывод
Я бы держал эту карточку в закладках как учебный пример. Рабочего инструмента здесь пока нет. Ценность тут в объяснении: стало видно, из чего складывается интерактивность и почему память в 96 видеокадров ограничивает всё остальное.
Если появится такая же модель с открытым кодом обучения и часами собственного материала, разговор изменится. Пока 630 миллионов параметров, один игрок на видеокарту и Apache-2.0 это хорошая новость для исследователей и нейтральная для продакшена.