Три поломки, которые заказчик называет одним словом
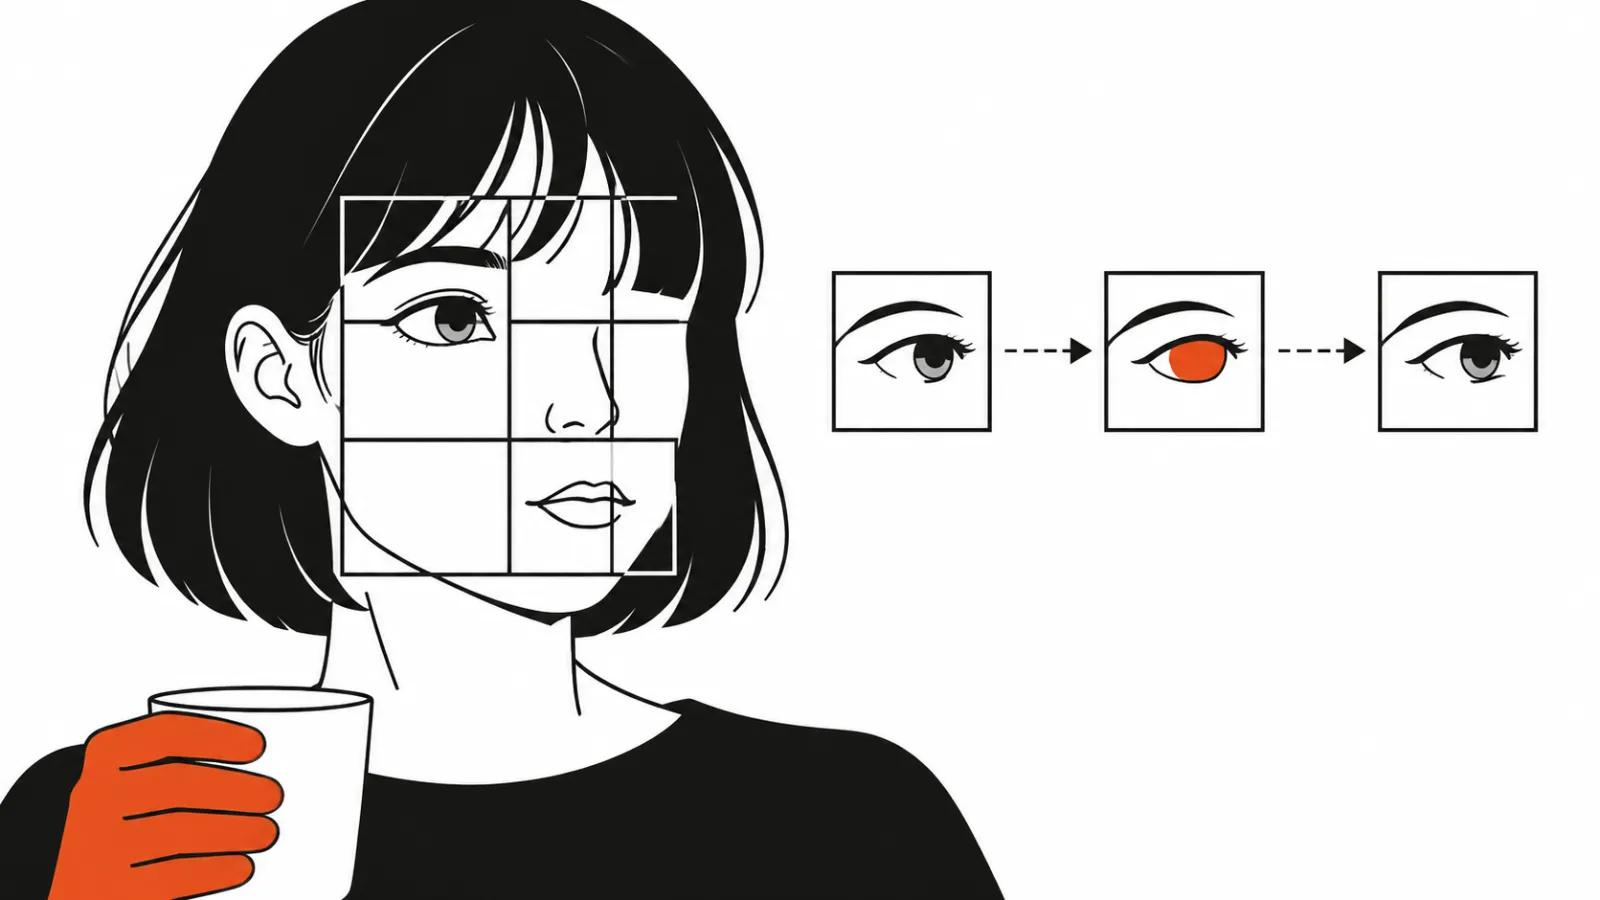
Клиент присылает ролик и говорит: плывёт лицо. Через минуту выясняется, что претензий три. Лицо: глаза уезжают на пиксель в сторону, уголок рта меняет форму, между шотами герой становится похож на другого человека. Руки: пальцы слипаются в один, появляется шестой, кисть входит в чашку или в ручку двери. Текст: буква теряет чёрточку, надпись на футболке читается как набор знаков, логотип на вывеске расползается.
Причина у всех трёх одна и та же, но проявляется по-разному. Дальше механизм, а в конце приёмы, которые реально помогают.
Почему в ИИ-видео плывут лица: модель видит сжатый черновик кадра
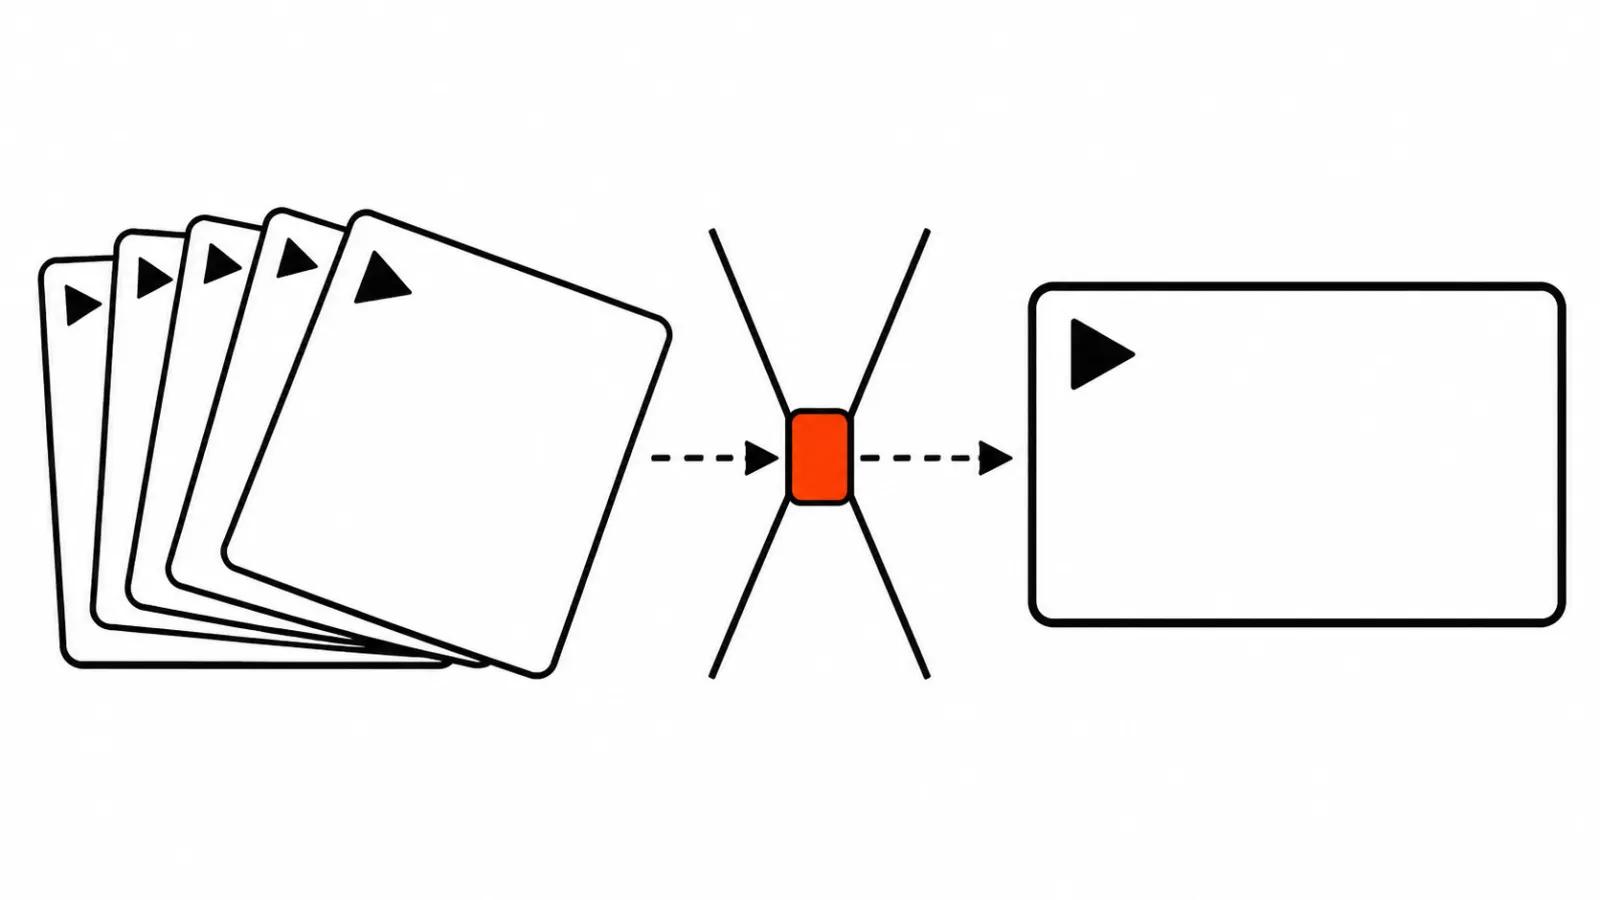
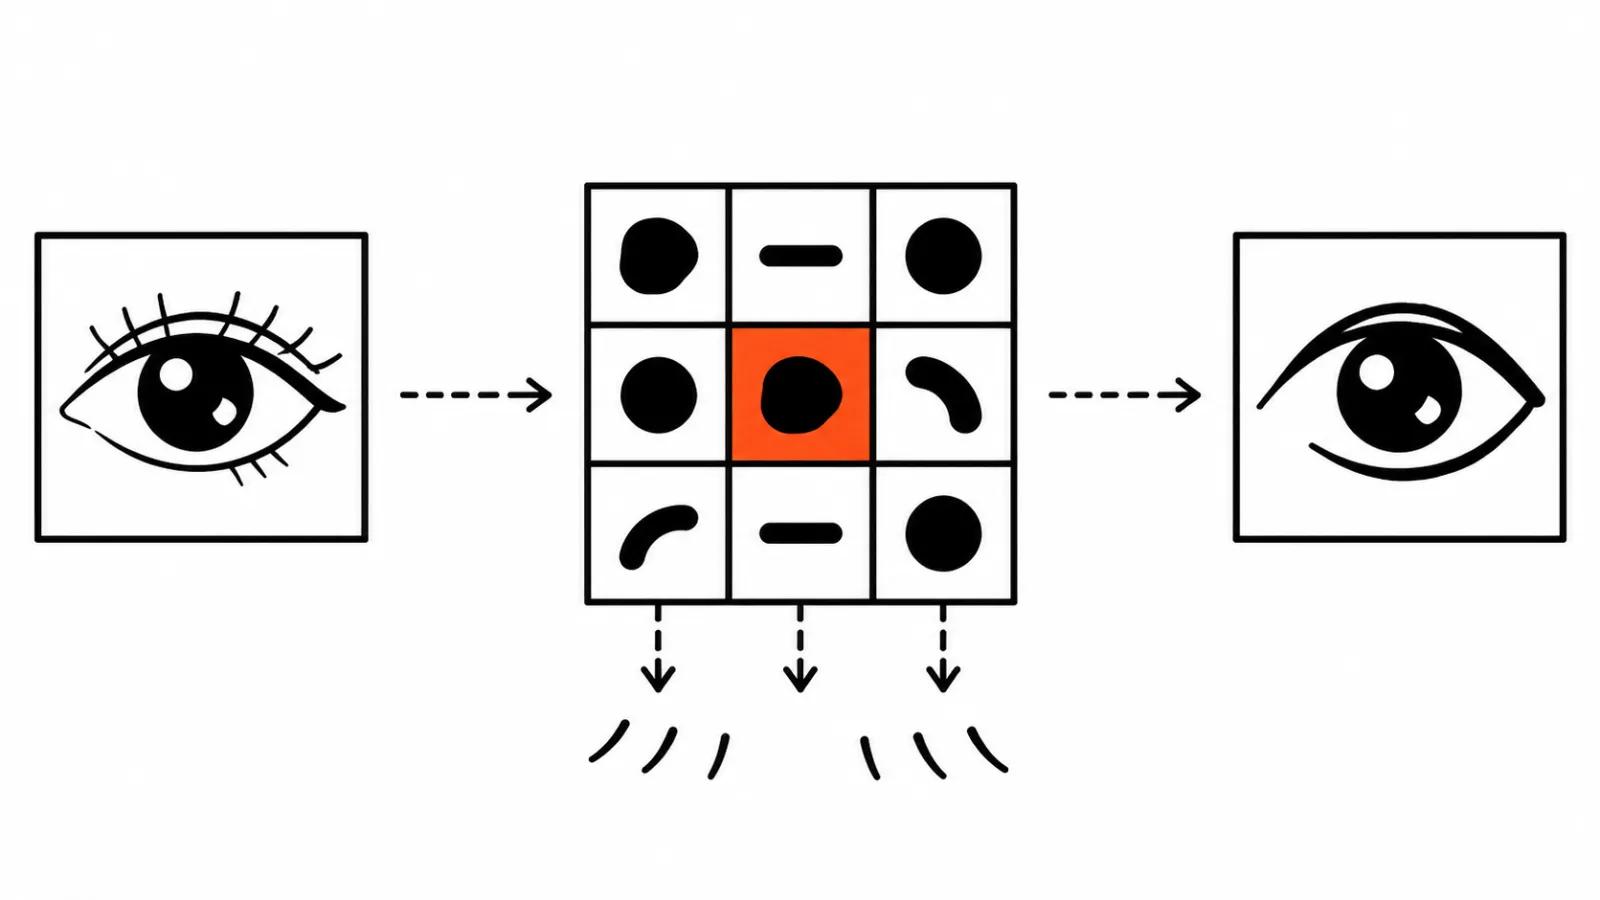
Видеомодель не рисует пиксели напрямую. Она работает с латентом, сжатым черновиком кадра, где подробности уже потеряны. В открытой LTX-Video от Lightricks (статья на arXiv 2501.00103) кодировщик сжимает видео в 192 раза: один токен описывает блок 32 на 32 пикселя сразу на 8 кадров.
Переведу на бытовой язык. Кадр разложили на кубики по 32 пикселя, и модель говорит про каждый кубик одной фразой. В кубик помещается нос целиком или кусок щеки. А зрачок, ресница, буква в надписи занимают долю кубика. Модель эту долю почти не хранит. Когда декодер собирает кадр обратно, он дорисовывает мелочь по смыслу: глаз должен быть здесь, значит нарисуем глаз. Рисует похожий, и в следующем кадре похожий немного иначе.
У этого есть цена. Чем мельче деталь, тем меньше от неё осталось в черновике и тем больше декодер придумывает сам.
Каждый кадр дорисовывается заново, и сдвиги копятся
Второй слой проблемы в том, что мелочь на каждом кадре восстанавливается из черновика заново. Даже когда модель генерирует кадры вместе, глаз или палец на соседних кадрах получается чуть разным.
11 ноября 2026 года автор фильтра ComfyUI-H3-FaceRefine-Plus (проект на GitHub) описал это на MiniMax H3. Перерисованное лицо дрожит: глаза и уголки рта встают на 1 или 2 пикселя не туда, и на каждом кадре сдвиг свой. Волосы и уши при этом держатся, потому что они крупнее. Дрожание читается как нервный тик, хотя по отдельности каждый кадр выглядит нормально.
Его фильтр Flow Lock на тестовом шоте снизил дрожание с 0,73 до 0,19% высоты лица. Это цифры автора и один тест, зато порядок величины понятен: сдвиг убирается, если вести лицо от кадра к кадру отдельным проходом.
Третья причина крупнее первых двух: модель может потерять сам предмет.
PhyRubric, тест из University of Illinois Chicago (arXiv 2611.13576, 10 ноября 2026), проверяет сгенерированное видео по физическим пунктам. У 10 моделей 20,4% провалов по физике пришлись на постоянство и счёт: предметы исчезают между кадрами, удваиваются, сливаются друг с другом. Ошибки формы и идентичности в тесте идут отдельным типом.
Лучшая модель в тесте, Seedance 2.5, оказалась верна описанию сцены и физике одновременно в 44,20% видео. Подробный разбор цифр и остальная физика в ИИ-видео собраны в отдельной статье, там же список пунктов, по которым считается результат. Смысл для заказчика простой: удержать один и тот же объект от первого кадра до последнего для генератора отдельная сложная задача, и решает он её приблизительно.
Почему плывут руки
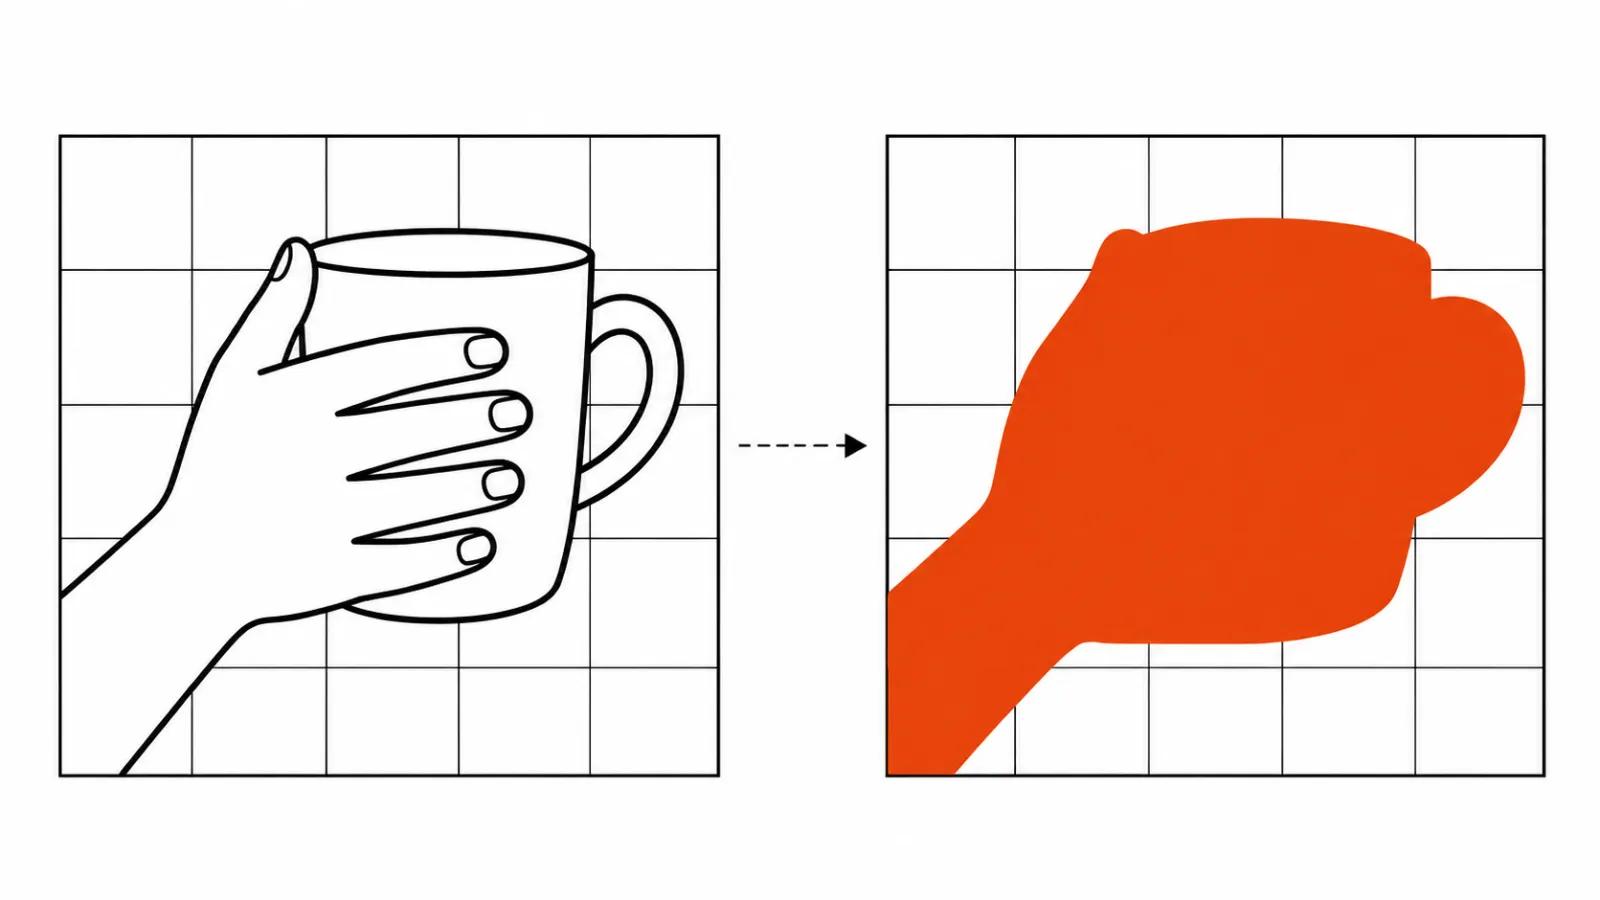
Рука это пять пальцев, ладонь, запястье и предмет, который они держат. Части мелкие и перекрывают друг друга. В один блок 32 на 32 пикселя попадает сразу несколько пальцев, а иногда и край чашки. Дальше работает тот же механизм: модель помнит, что здесь рука, и дорисовывает пальцы по смыслу.
Отсюда два следствия. Крупный план кисти, которая наливает чай или печатает по клавиатуре, остаётся самой тяжёлой задачей. И чем сильнее предмет перекрывает пальцы, тем выше шанс, что предмет и пальцы срастутся в одно пятно.
Почему ломается текст в кадре
Буква это точная форма. Она отличается от соседней одной чёрточкой, и подмену видно мгновенно, потому что читать мы умеем с детства.
Сжатие бьёт по тексту сильнее всего. Короткое слово может уместиться в один-два блока, а внутри блока модель хранит общий смысл, вроде «здесь вывеска». При распаковке получается правдоподобная вывеска, буквы в ней похожи на буквы, но не те. Названия брендов и логотипы страдают первыми, потому что там важна каждая линия.
Вывод простой: надписи, ценники и логотипы добавляйте в монтаже. Слой текста поверх готового видео читается идеально и не зависит от того, что модель придумала в кадре.
Производители это признают
Google в описании Gemini Omni 1.2 Flash (blog.google, 5 ноября 2026) перечисляет, над чем работа продолжается: быстрая спортивная динамика, быстрые смены сценария и сложная физика. В том же тексте обещано меньше дрейфа лица и объектов от первого до последнего кадра. То есть компания считает дрейф отдельной задачей и сообщает, что стало лучше.
Kling в гайде 4.0 идёт другим путём. В примерах промпта у них написано, что герой должен оставаться визуально одинаковым в каждом кадре. Это подсказка модели, которая часть проблемы снимает, а часть перекладывает на человека, который пишет промпт.
Дрейф лица между шотами это отдельная тема, приёмы, как держать персонажа, я собирал в прошлом разборе.
Что делать на съёмке и в монтаже
Пять приёмов против дрейфа.
Лицо крупнее в кадре, когда оно важно для смысла. На среднем плане глаз занимает пару пикселей, и дрожание видно. На крупном плане у той же детали пикселей в разы больше, и сдвиг теряется.
Шоты с лицом короче. Чем меньше кадров модель рисует подряд, тем меньше она успевает накопить сдвигов.
Референс лица. Референс даёт модели опору, и сходство держится лучше. У Gemini Omni, по гайду Runware, лучше всего сходство держит референсное видео, одна фотография справляется хуже.
Текст, ценники и логотипы в монтаже.
Покадровая проверка перед сдачей. Прокрутить спорные места в полном масштабе, кадр за кадром, и посмотреть на телефоне. Дрожание, которое не видно в окне предпросмотра, на телефоне вылезает сразу.
Для видео нейросетями этот чек-лист стоит проходить на каждой сдаче. Когда ролик требует сцен с крупным лицом и разборчивыми надписями, их проще отдать в ручные ролики от 16 000 ₽, где за кадр отвечает человек.
Мой вывод
Плывущие лица, пальцы и буквы это свойство метода. Модель работает со сжатым черновиком кадра и дорисовывает мелочь заново на каждом шаге. Пока это так, часть сцен придётся строить вокруг ограничения: лицо крупнее, шот короче, надпись в монтаже.
Порядок, который я вывел для себя, звучит скучно. Сначала раскадровка с учётом того, что модель тянет, потом проверка десяти секунд на самом сложном шоте, потом решение про всю серию. Как устроены шаги генерации и откуда берётся шум, я разбирал отдельно в статье, как работает генератор видео по шагам. Сегодняшний текст про другое: про то, во что эти шаги превращают мелкие детали.