Две работы за сутки, обе про одно
22 октября на arXiv появились два текста. Первый, WorldForge V2, про то, как заставить видеомодель ехать камерой по заданному маршруту и не разваливать сцену. Второй, AnyGameRenderer, про то, как превратить серый блочный прототип игры в картинку с персонажами, движением и эффектами, сохранив расположение объектов.
Общее у них вот что. Обе работы не обещают нового уровня фотореализма. Обе возятся с управляемостью: чтобы кадр делал то, что просили, и чтобы объекты не появлялись и не исчезали сами по себе.
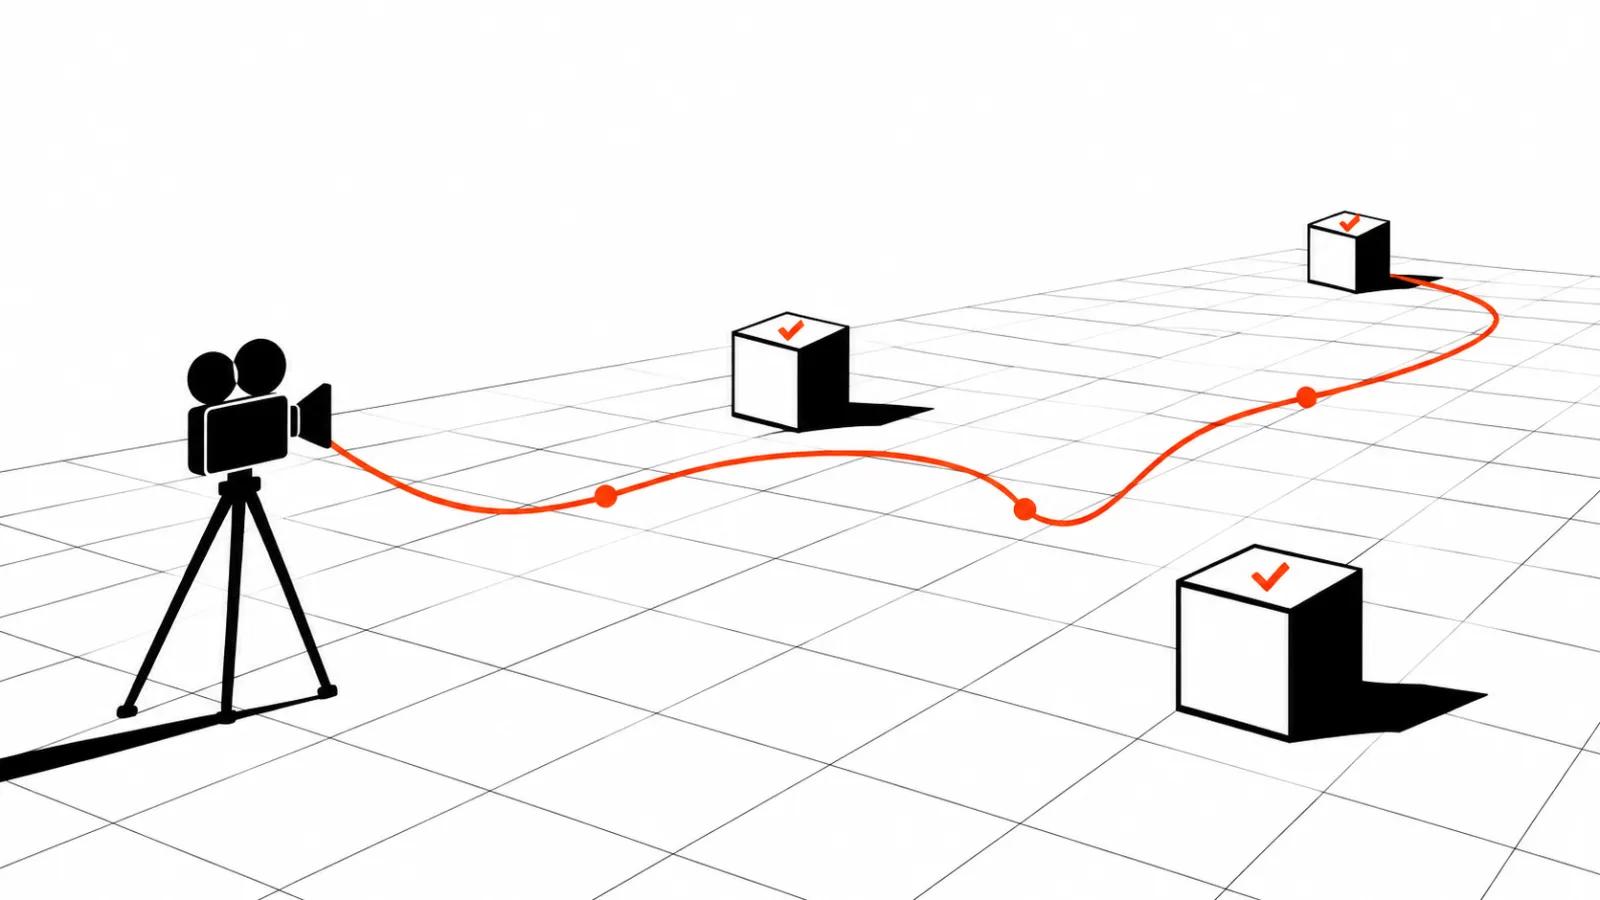
WorldForge V2: камера без переобучения
Авторы, Chenxi Song и соавторы, начинают с честной констатации: видеомодели набрали богатых 3D и 4D приоров и годятся для генерации сцен и пересъёмки, но точное управление камерой им не даётся. Мешают три вещи: неточный контроль, пространственные и временные несоответствия, и слипание движения камеры с движением объектов в сцене.
Обычные лекарства, дообучение под задачу и постобработка с варпингом, дают артефакты, плохо переносятся на новые сцены или стоят слишком дорого. Поэтому авторы делают схему без обучения: берут искажённые референсы и итеративно правят генерацию вдоль целевой траектории.
Ключевая деталь: оптический поток показывает, какие латентные каналы отвечают за движение. По ним и направляется правка, поэтому управление движением отделяется от внешнего вида. Вторая деталь, двухпутевая стратегия: модель сравнивает предсказание с подсказкой и предсказание без неё и по разнице чинит артефакты от неидеальных референсов.
Что даёт Trajectory LoRA и кэш
Итеративная правка дорогая, поэтому в работе есть v-cache: поправка приближается по предыдущему шагу денойзинга, и лишний прогон модели не нужен. Дальше авторы переносят локализацию движения с латентных каналов на блоки сети и добавляют Trajectory LoRA, который настраивает только те блоки, что сильнее всего реагируют на подсказку по траектории.
Обучение двухступенчатое и экономное. Адаптеры учатся убирать шум в тех состояниях, которые возникают при генерации с подсказкой. Заявлено, что одной обучающей сцены хватает, чтобы схема работала на невиданных ранее сценах. Это сильное утверждение, и проверять его придётся независимо.
AnyGameRenderer: прототип превращается в игру
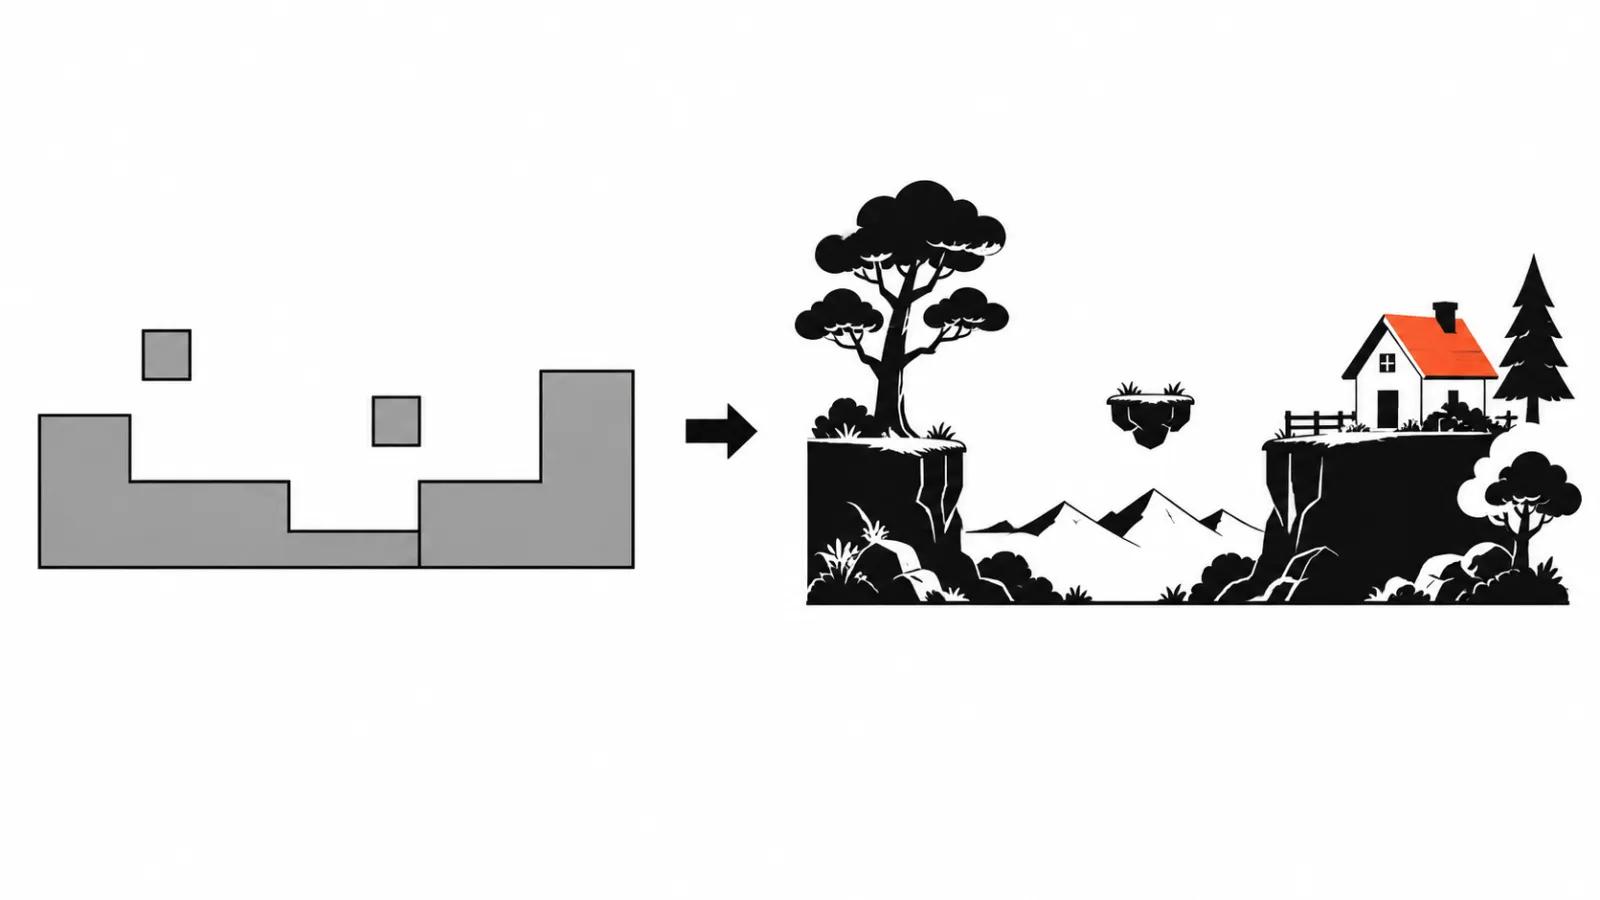
Вторая работа начинается с бытового наблюдения. Агенты, которые пишут код, собирают маленькую играбельную игру за минуты, но выглядит она как программистский арт: серые блочные заготовки, цветные примитивы, плоские пятна на месте персонажей.
AnyGameRenderer это видео в видео. На вход идёт обычная запись прототипа, без движковых буферов, без разметки классов, без низкополигональных прокси. Серые болванки, цветные примитивы, семантические карты и каркасы подходят как есть. На выходе картинка с персонажами, деталями движения и эффектами, при этом компоновка, камера и позиции объектов остаются на месте.
Авторы перечисляют жанры, на которых схема работает: tower defense, авто-баттлеры, выживание сверху, пошаговые бои, картинг, раннеры с толпой. Отдельно сказано про соответствие сущностей: количество персонажей в группе сохраняется, объекты появляются и исчезают на нужном кадре.
Цифры, которые стоит запомнить
Технически это LoRA поверх MiniMax-H3 ref2va, модели на 33 миллиарда параметров, которая принимает референсное видео как условие. Обучение шло примерно на 10 тысячах парных клипов из трёх источников: записи 38 игр, сделанных агентами и выгруженных из GEAR, данные двухпоточной съёмки в Unreal Engine с программно управляемой толпой и масштабом, плюс реальные записи геймплея с парами, восстановленными по 3D-боксам.
Для оценки авторы собрали бенчмарк: 59 отложенных случаев, 753 сущности, сверка с эталонными боксами. Временное совпадение выросло с 50,9 до 62,9 процента. Пропущенные изменения количества упали с 34,7 до 21,3 процента. Выдуманных и недорисованных сущностей стало меньше.
Почему я смотрю на это скептически
Обе работы решают задачу, которую заказчик не видит. Клиент видит финальный ролик и не знает, что камера дрогнула на орбите или что в толпе было семь человек, а стало пять. Именно поэтому прогресс здесь идёт медленно: рынок платит за картинку.
И всё же я считаю эти два текста важнее очередного релиза с красивым демо. Красивых демо стало много, а предсказуемость кадра осталась роскошью. Пока модель не держит траекторию и счёт объектов, каждый сложный кадр приходится переснимать генерациями, и смета на пачку роликов растёт вместе с числом дублей.
Мой личный вывод простой: следующий скачок в ИИ-видео случится в надёжности повторов. Кто первым сделает камеру и объекты предсказуемыми, тот и заберёт производственные бюджеты.
Что с этим делать студии
Смотреть на эти работы как на сигнал: контроль становится отдельной дисциплиной, и его надо закладывать в процесс заранее. Когда берёте производство видео нейросетями, требуйте от исполнителя не только красивых кадров, но и повторяемости: одинаковый промпт и одинаковая сцена должны давать одинаковый результат. Там, где нужен поток, выручает связка моделей и обзор нейросетей для видео, по которому видно, что каждая из них умеет. Для сложных постановок остаются ручные ролики, и это нормально: часть задач дешевле снять, чем догонять генерациями. А для кампаний, где один сюжет нужен в десяти версиях, полезна уникализация роликов, потому что именно там разваливается совпадение объектов между кадрами.