Что за модель и откуда версия 1.6
Команда LongCat из Meituan 15 ноября объявила версию 1.6 своей модели для говорящих аватаров. Код 1.6 влит в основную ветку в тот же день, веса и карточка модели лежат на Hugging Face с 13 ноября, лицензия весов MIT. По сути это открытый инструмент: можно скачать, запустить у себя и дорабатывать.
Модель делает видео говорящего человека под записанное аудио. На вход подаются аудиодорожка плюс референс-картинка или текстовое описание внешности. Готовый клип она умеет продолжать, а прошлая версия уже умела ставить в кадр несколько спикеров, так что диалоги для неё отдельная штатная задача.
Говорящий аватар из фото: что подаётся на вход
Объясню вход простыми словами. Аудио задаёт текст и интонацию: модель двигает губы и мимику под звук. Референс-картинка отвечает за внешность, это и есть тот случай, когда оживить фото и заставить говорить можно одним прогоном без съёмки. Если картинки нет, внешность описывается текстом, хотя с фотографией результат обычно предсказуемее.
Мы разбирали похожий подход в отдельном материале про говорящий аватар из фото в открытой модели Kandinsky S2V: там тоже аудио плюс референс, тоже открытые веса. Разница в позиции: Kandinsky S2V про короткие клипы, LongCat 1.6 бьётся именно за длину.
Почему лицо уплывает на длинной дистанции
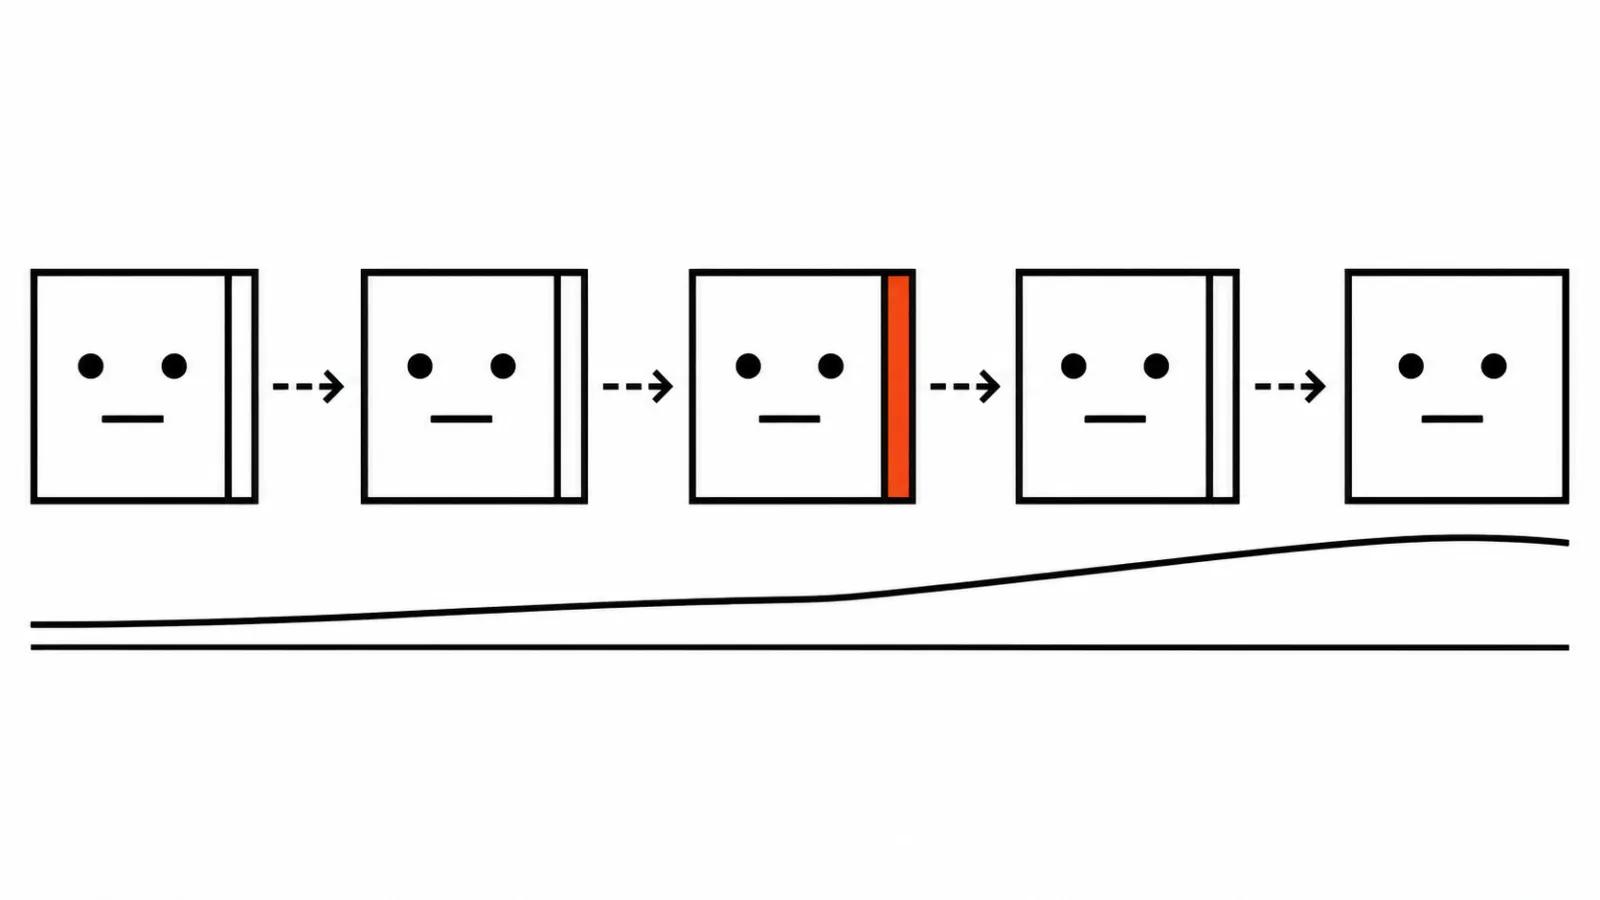
Длинные ролики модель собирает из коротких кусков. Часть последних кадров предыдущего клипа переносится в начало следующего, к ним дописываются новые кадры. В каждом переносе живёт мелкая ошибка у рта или в текстуре лица, и с каждым шагом она растёт. На тридцати секундах этого не видно, к пятой минуте зритель замечает, что ведущий «поплыл», даже если не может объяснить причину.
Это и есть главная боль длинных форматов с одним ведущим. Обучающие ролики, объяснялки и диалоги длинные по определению: записать их одним куском ни одна видеомодель пока не может, значит нужен механизм продолжения, и от его чистоты зависит весь ролик.
Что изменили в 1.6
Модель дообучали в ситуациях, где она продолжает собственные сгенерированные клипы. Проще говоря, её учили на своих же ошибках: берём сгенерированный кусок, продолжаем его, сравниваем с тем, как должно быть, и подтягиваем веса. Результат по заявлению команды: ролики длиннее 10 минут, где десять минут это длина готового видео, с меньшим дрейфом лица и рта.
Формулировка честная: обещание про меньший дрейф, и проверять его надо на своём материале, потому что дрейф зависит от референса, темпа речи и сцены.
Цифры Meituan: где 1.6 сильнее и где слабее
Сравнение самих разработчиков: 508 пар картинка плюс аудио, 6 моделей, 33 051 валидный голос. Версия 1.6 заняла второе место после OmniHuman 2.0. Против собственной прошлой версии доля побед 55,6% при 2 535 голосах: улучшение зафиксировано, но отрыв небольшой.
Человечность выше на реалистичных референсах и ниже на анимационных, это стоит учитывать при выборе стиля. Самое показательное число про губы: эксперты на половинной скорости нашли рассинхрон губ в 82,5% клипов 1.6 против 83,7% у 1.5. Это строгая проверка, и она говорит прямо: синхрон остался слабым местом, сдвиг мизерный, и на критичном материале губы всё равно придётся проверять и подчищать.
Что нужно для запуска
Веса открытые, лицензия MIT. Стандартный набор весит около 31,7 ГБ, 8-битная версия около 15,9 ГБ, весь репозиторий со всем содержимым 77,6 ГБ. В примерах на карточке запуск на двух GPU. Минимальный объём памяти и время рендера десяти минут видео разработчики не публикуют, поэтому прикинуть под свою карту заранее не выйдет, останется мерить на практике.
Если цель стоит в прямом эфире, эта модель всё равно не про то: у нас есть отдельный разбор локального говорящего аватара в реальном времени, там другая инженерия и другие требования к железу.
Мой вывод
Направление правильное: длинные форматы с одним ведущим это рынок обучающего видео, и кто научится держать лицо на десятке минут, заберёт заметную часть заказов. Meituan двигается туда всерьёз, о чём говорит и дообучение на собственных продолжениях, и открытая публикация цифр с неудобными числами про губы.
Мы на своей серии 1.6 не прогоняли, поэтому обещать десять минут без артефактов я бы не стал: сначала короткий тест на своём референсе и своём аудио, потом решение про весь формат. Права на лица и голоса остаются на продакшене, открытая лицензия весов согласия человека за вас не подпишет. И про расклад сил: если задача это десять коротких версий под вертикальные форматы, логичнее отдать её тем, кто ежедневно делает видео нейросетями под задачу, а длинный ведущий под бренд пока надёжнее живёт в классике, где у нас ручные ролики собирает человек и отвечает за каждый кадр.