Что именно открыли
29 октября SenseTime выложила SenseNova 6.8 Code2Video. Это лёгкая модель, дообученная из Qwen3.8-27B: 27 млрд параметров, лицензия Apache 2.0, веса на Hugging Face, код на GitHub. Вместе с весами открыт скилл производства: воркфлоу, гайды и инструменты рендера. В логах траекторий 357 картинок-кадров, и по ним видно, как модель собирает сцену шаг за шагом.
Задача узкая: короткий ролик, целиком реализованный кодом. Модель пишет программу, которая строит сцену и рендерит её в файл. Кадр за кадром никто не дорисовывает, поэтому текст, цифры и геометрия остаются ровно такими, какими их задали.
Как устроен процесс: три шага
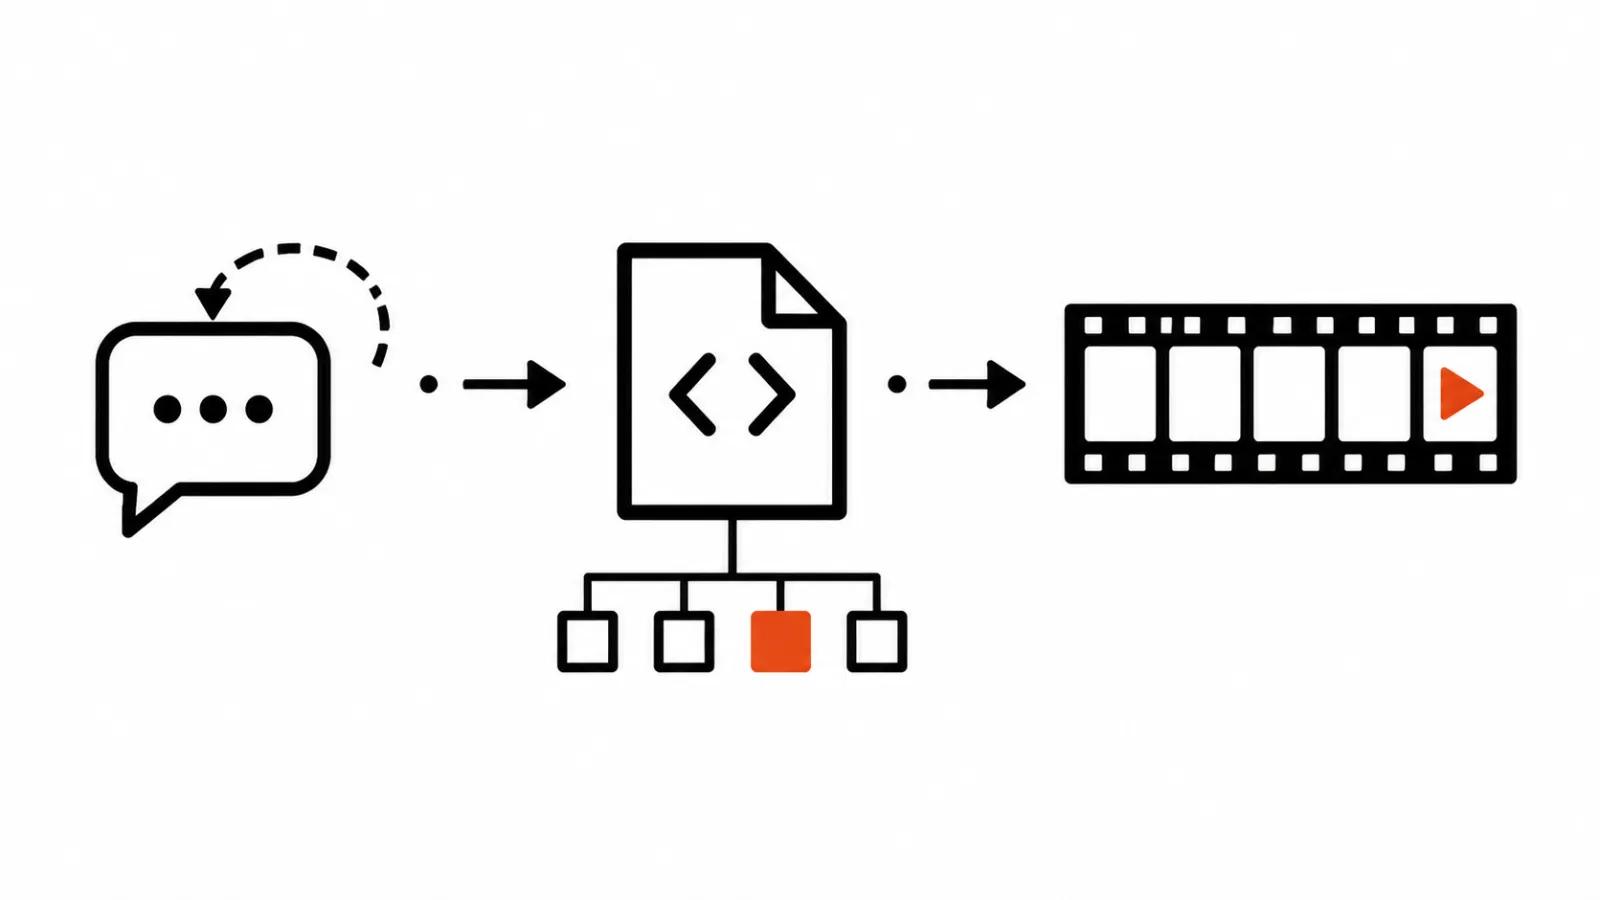
Работа идёт в три шага. Сначала сильная общая модель переписывает промпт автора, в своём примере SenseTime берёт версию 5.5. Потом Code2Video внутри Claude Code со скиллом code-video выдаёт три файла: final.mp4, SPEC.md с описанием сцены и VERIFY.md с проверками. Третий шаг правки по заметкам автора.
Один ролик это долгая задача. Модель держит прогоны больше десяти часов и больше двух тысяч ходов, контекст 512K. Отсюда и рекомендация ставить её в оболочку вроде Claude Code, где длинный прогон с файлами на диске переживает паузы и перезапуски.
Моушн-дизайн кодом: точный текст и правки
Диффузия рисует надпись как картинку и часто ломает буквы, а рендер из кода ставит текст шрифтом. Для титров, подписей и цифр в счётчике это разница между браком и готовым кадром. На роликах с плотной графикой такой брак виден сразу.
Второй плюс правки. Число, цвет или тайминг меняются в коде, сцена перерендеривается, остальное остаётся на месте. Перегенерация с шансом получить другой кадр тут не нужна. Третий плюс повторяемость: одинаковый код даёт одинаковый результат, и версию ролика можно откатить.
Если нужно вспомнить, что такое моушн-дизайн в обычном смысле, у нас есть разбор про ключевые кадры, тайминг и кривые.
Видео инфографика и объяснялки
Здесь видео инфографика держится на цифрах, стрелках, графиках и переходах между слайдами, и всё это код описывает точнее, чем промпт. По ходу работы модель может вызывать другие модели: генерацию картинок, видео, 3D и монтаж. Цель, которую называет SenseTime, звучит так: модель-координатор творческих инструментов. Дальше обещают монтаж, композитинг, анимацию и 3D.
Ещё один приём из описания: на вход можно подать референс-видео, и модель воссоздаст его как редактируемый код. Для студии это способ разобрать чужой ролик на слои и пересобрать под свой бренд.
ИИ для создания видео по тексту: граница подхода
Скажу прямо: там, где в кадре нужен живой человек, лицо, мимика, съёмка с рук, код не помогает, потому что он не снимает. Модели ии для создания видео по тексту в этом сценарии остаются рабочим инструментом, и Code2Video их не вытесняет.
Разница в задаче. Персонаж, эмоция, фактура кожи требуют генерации пикселей. Схема, график, титр, заставка требуют геометрии и шрифта, и здесь код дешевле по числу итераций: правка занимает минуту вместо нового прогона на десять часов.
Цена входа: четыре GPU и десять часов
Запуск описан честно: LightLLM, vLLM или SGLang с tensor parallel 4, то есть нужно четыре GPU. Плюс больше десяти часов на один ролик и больше двух тысяч ходов модели, контекст 512K. Для лаборатории это норма. Для студии с тремя проектами в неделю это отдельная машина и человек, который следит за прогоном.
Поэтому пока это лабораторный инструмент с очень понятным применением. Ставить его в общий пайплайн вместо привычных генераций я бы не стал: четыре GPU на одного клиента не окупаются, и короткие объяснялки на диффузии выходят дешевле.
Что это меняет для студии
Код забирает себе класс роликов, где важны точность и повторяемость: объяснялки, инфографика, схемы, титры, заставки. Именно на таких задачах мы работаем с видео нейросетями, и точный текст в кадре всегда был больным местом.
Первый заметный заход в видео кодом был у DeepSeek V4.1 Flash, о нём мы писали отдельно. Code2Video идёт дальше: там открыты веса и весь воркфлоу, поэтому подход можно проверить на своём проекте вместо чтения анонсов.
Мой вывод
Модель стоит внимания тем, кто делает объяснялки и моушн-графику. Три вещи из описания я бы проверил первыми: как она держит русский текст в кадре, сколько итераций уходит на правку одной сцены и насколько стабильно повторяется рендер на той же машине.
Живой съёмке и персонажам она не конкурент, и в этом нет трагедии: у диффузии там своя сильная сторона. А вот обещание монтажа, композитинга, анимации и 3D стоит держать в голове: если SenseTime доведёт модель до координатора инструментов, поменяется сама сборка ролика, а генерация кадра станет одной из операций внутри кода.
Пока я бы поставил её на один тестовый ролик и не переводил на неё поток.