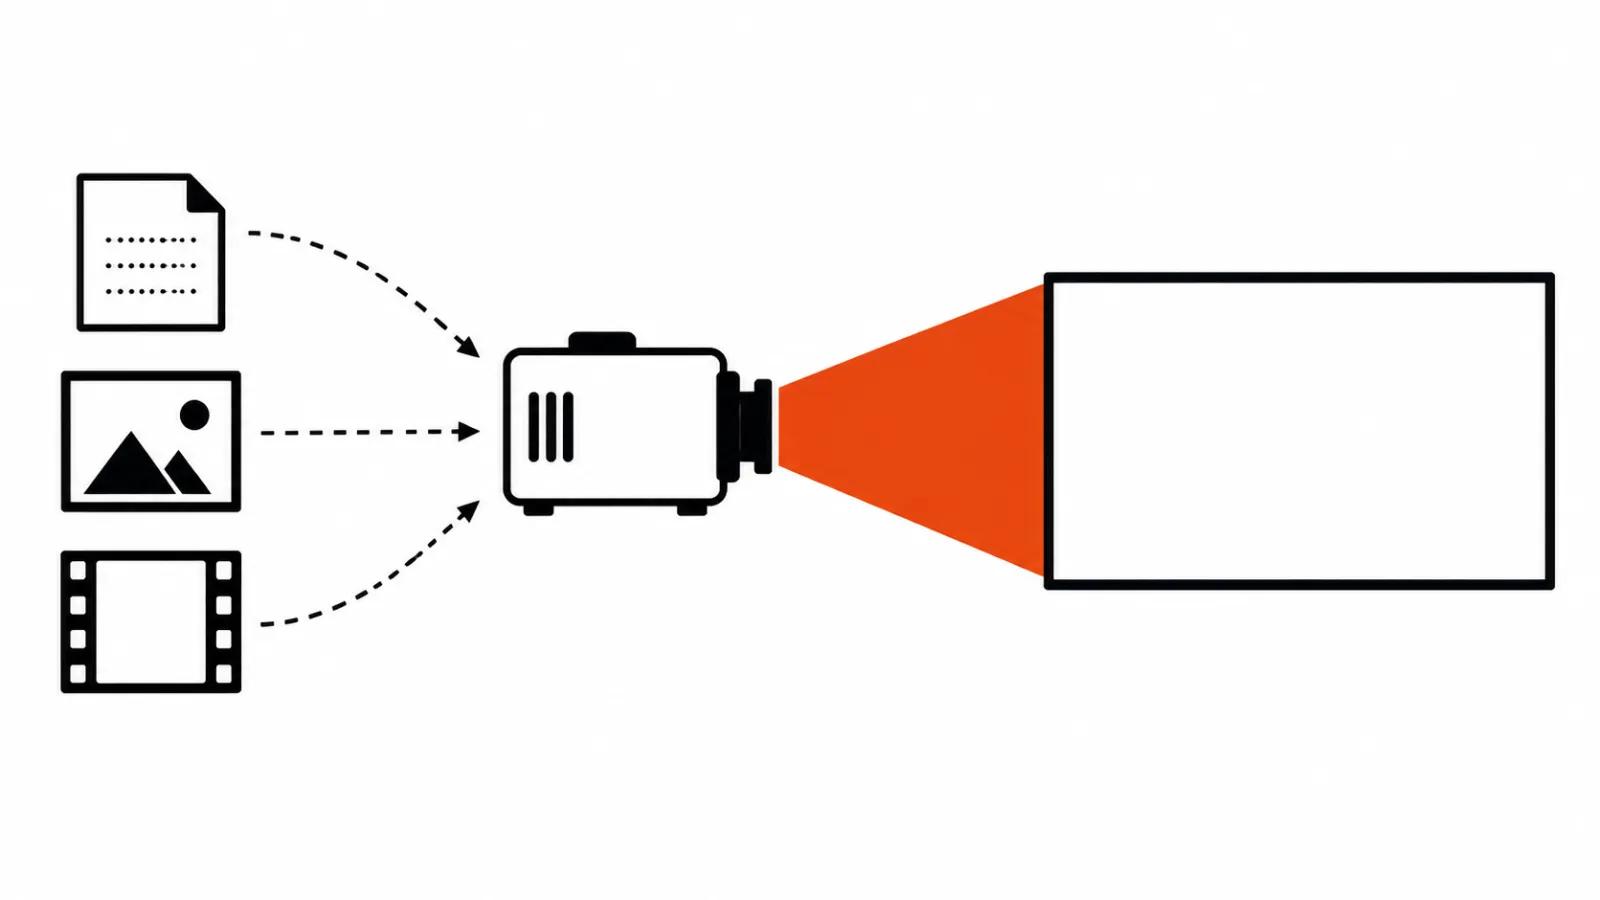
Три входа: текст, картинка, видео
В видеогенерации три входа, и по ним же называют режимы. t2v это текст в видео: вы пишете описание, модель придумывает кадр с нуля. i2v это картинка в видео: на вход идёт готовое изображение, модель добавляет движение. v2v это видео в видео: на вход идёт отснятый или сгенерированный клип, модель меняет в нём фон, свет, объект или стиль.
На практике выбор режима редко бывает вкусовым. Он зависит от того, что у вас уже есть на руках: пустой лист, один кадр или готовый материал. Ниже разбор по порядку, на конкретных версиях моделей и их официальных документах, чтобы решение опиралось на паспорт инструмента.
Что держит картинка
У Runway официальный Gen-4 Video Prompting Guide описывает i2v так: ролики 5 или 10 секунд по входной картинке и тексту. Картинка задаёт визуальную стартовую точку, текст описывает движение. В том же гайде есть предупреждение, которое экономит прогоны: повтор деталей картинки в промпте может уменьшить движение.
Вывод простой. В i2v промпт пишут про действие, камеру и темп, а цвет упаковки и форму логотипа оставляют картинке. Тогда генерация видео из фото держит то, что должно остаться неизменным: конкретный продукт, лицо, фирменный кадр, вывеску на стене, оттенок материала.
Когда хватит текста
t2v удобен, когда нужно нащупать идею и атмосферу: свет, погоду, настроение сцены, тип движения камеры. Открытая модель LTX-2.5 от Lightricks (карточка Hugging Face Lightricks/LTX-2.5) умеет видео и звук из текста, картинки и видео, и веса лежат в открытом доступе. При подходящей видеокарте это много дешёвых дублей на своей машине.
Ограничение у текста одно и постоянное: он не гарантирует конкретный предмет, лицо и повторяемость между шотами. Описание «белая кружка на столе» в десяти прогонах даст десять кружек. Поэтому t2v хорошо работает на этапе поиска, где цель это направление, а точный кадр появится позже.
Когда есть съёмка
Обратная задача: материал снят, менять нужно фон, свет, объект или убрать лишнее. Здесь работает v2v, и у Runway для этого есть Aleph 2.0 с официальной справкой «Creating with Edit Studio». Правка готового видео идёт отрезками от 2 до 30 секунд, вход 480p-1080p, 24-30 кадров в секунду, не больше 10 склеек или смен плана.
Лимиты задают подготовку. Клип длиннее 30 секунд обрезается, частота выше 30 кадров в секунду прореживается, и происходит это до генерации. Значит, нарезку и выбор десяти смен плана делает человек, а нейросеть получает уже аккуратный кусок. Ролик, собранный как видео из видео, экономит съёмку: фон меняется, движение героя остаётся прежним.
Промежуточные варианты: референсы и ключевые кадры
Между картинкой и текстом есть третий вход, который часто пропускают. Референс это изображение или клип, с которых модель берёт внешний вид объекта, стиль или движение, без привязки к первому кадру. Разница с i2v простая: стартовый кадр задаёт начало ролика, референс задаёт то, что должно появиться внутри.
В Kling 4.0 по официальному User Guide до 15 референсов на задачу: до 10 картинок, 5 видео суммарно до 30 секунд, 7 элементов и 3 видеоэлемента. Там же первый и последний кадр, до 10 ключевых кадров, 3-30 секунд за генерацию, 720p, 1080p и 4K, форматы 21:9, 16:9, 1:1 и 9:16, промпт до 8 000 токенов.
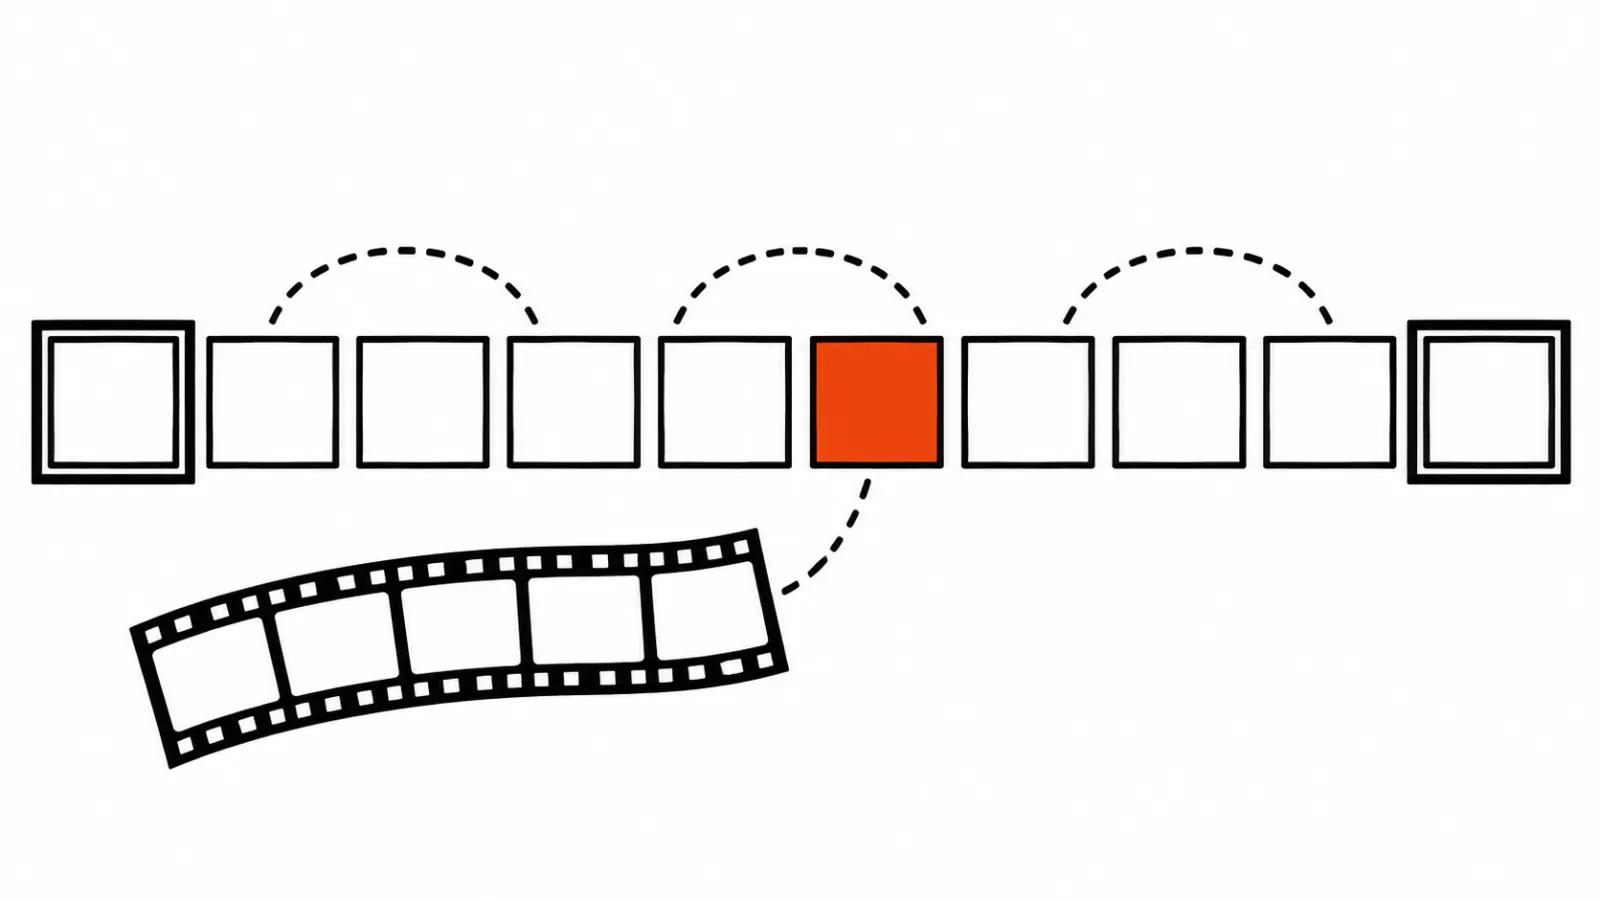
Ключевые кадры отвечают на частый запрос заказчика: длинное действие с контрольными точками. Человек открыл дверь, повернулся, поставил коробку. Каждая точка это кадр, между ними модель достраивает движение. Первый и последний кадр решают ту же задачу дешевле, если точек всего две.
Gemini Omni 1.2 Flash из документации Google Cloud, модель вышла 5 ноября 2026, заходит на эту территорию целиком: видео со звуком до 15 секунд, 360p, 720p, 1080p и 4K, текст в видео, картинка в видео, генерация по референсам, первый и последний кадр, правка видео входом до 15 секунд, продление на 3-10 секунд к последним 30 секундам входа и апскейл, до 10 картинок и 3 видео на запрос, 16:9 и 9:16. Когда один инструмент закрывает все режимы, выбор смещается с сервиса на подачу: важно то, что вы кладёте на вход.
Черновик на быстрой модели, финал на полной
Отдельная экономия лежит в двух проходах. В changelog Higgsfield от 12 ноября 2026 есть Seedance 2.5 Flash: быстрые превью в 480p и 720p со звуком, Omni reference и первый с последним кадром как у полной модели. Тот же промпт и те же референсы переносятся в Seedance 2.5 и дают финал в 1080p или 4K.
Цикл получается такой: движение, композиция, камера и свет проверяются на превью, дубли сравниваются между собой, спорный вариант отбрасывается, и только принятая версия считается в финальном разрешении. Превью со звуком здесь важны отдельно, потому что ритм ролика без дорожки не читается.
Порядок: какую нейросеть использовать для создания видео
Мой порядок идёт от входа к инструменту.
Нужен конкретный продукт, лицо или фирменный кадр: начинаю с картинки или референсов. i2v в Runway Gen-4 или Omni Reference в Kling 4.0 держат объект, пока промпт занят движением.
Есть отснятый материал, и меняются фон, свет или объект: v2v, Runway Aleph 2.0, клип нарезан до 30 секунд и до десяти смен плана.
Нужно найти идею и атмосферу: текст, t2v, много дублей на быстрой модели. LTX-2.5 тут удобен открытыми весами.
Длинное действие с точками: ключевые кадры в Kling 4.0 или первый и последний кадр в Gemini Omni 1.2 Flash, если нужен звук и вертикаль 9:16.
Дальше смотрю на формат. Вертикальная реклама живёт в 9:16, и это отсекает часть моделей и настроек ещё до генерации.
Мой вывод
Режим это самый дешёвый способ управлять результатом. Один и тот же промпт в i2v и в t2v даст разные ролики, и различия пойдут по тому, что остаётся под контролем: предмет, идея или движение исходника. Картинка держит предмет, текст держит идею, видео держит движение и свет съёмки.
Модель я бы не выбирал по демо-роликам в ленте. Полезнее взять свой худший кадр, прогнать его в двух режимах на превью и посмотреть, где сломается лицо, текст на упаковке и руки. Ответ на этот тест обычно и решает вопрос.
Если вы заказываете ролики нейросетями, задайте исполнителю тот же порядок: сначала режим под задачу, потом модель и разрешение. Если задача в потоке версий для соцсетей, есть смысл посмотреть, как устроена вертикальная реклама серией.