Почему ролик обрывается на десяти секундах
Запрос звучит буднично: нужен ролик на минуту, желательно сразу с озвучкой. Модель отдаёт от трёх до тридцати секунд, и дальше начинается разговор про бюджет и терпение. Дело не в тарифах.
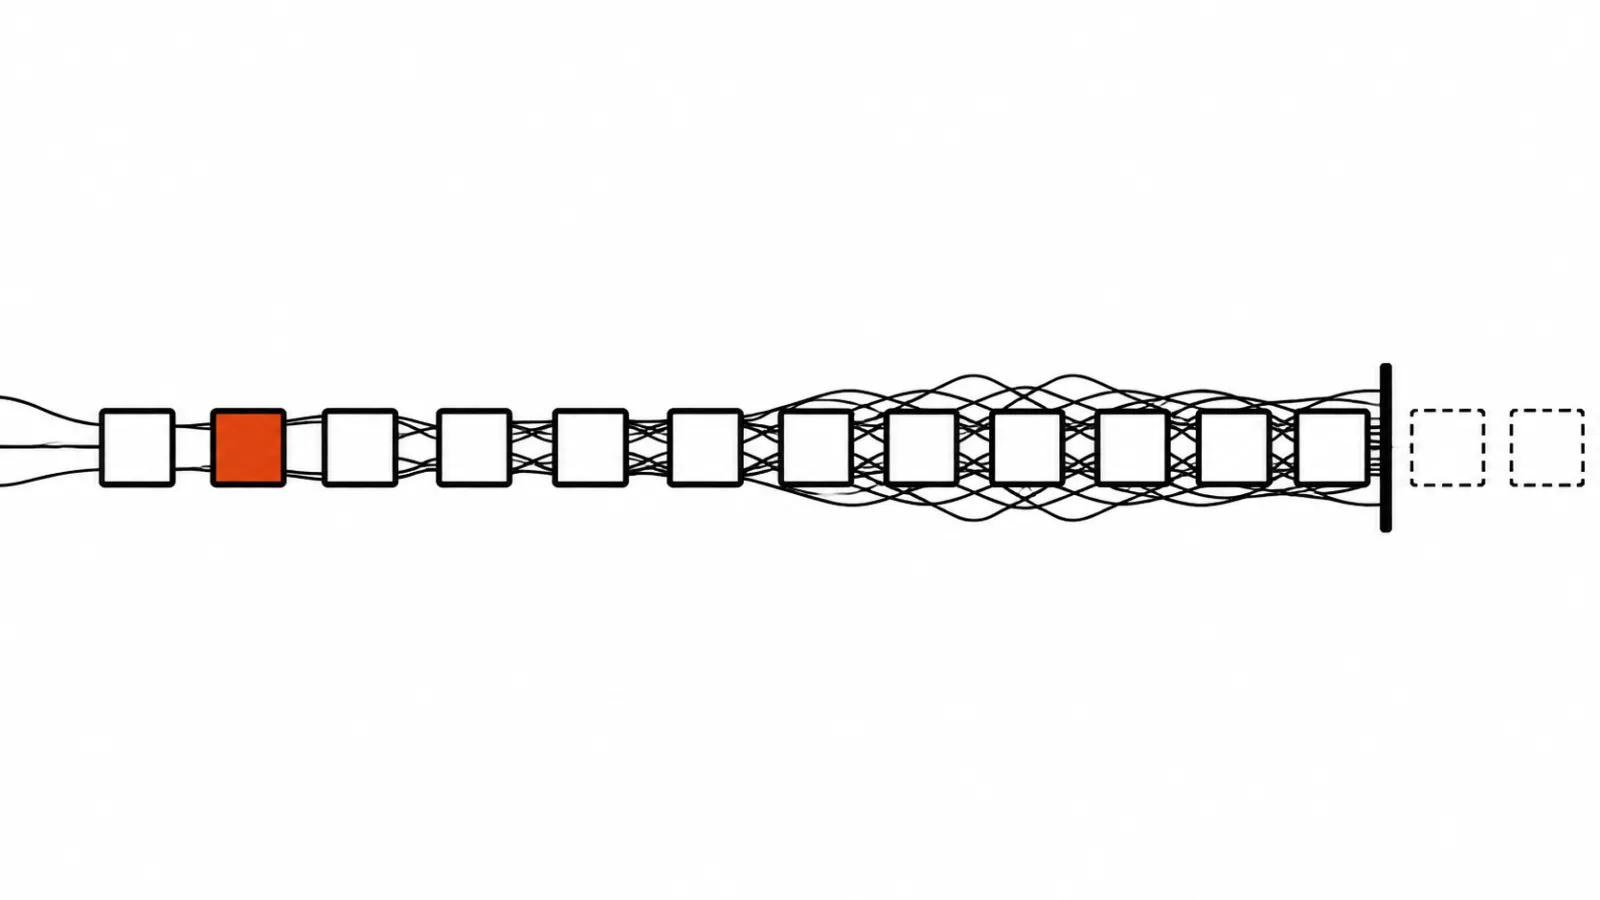
Внутри модели видео устроено похоже на языковую модель. Каждый новый кадр сверяется с уже собранными кадрами, чтобы движение, свет и текстура не разъехались между началом сцены и её концом. Механизм называется вниманием: кадр смотрит на предыдущие и решает, что в нём продолжить. Именно поэтому фон держится ровно и человек не меняет куртку на середине прохода. Именно поэтому же генерация упирается в потолок.
Цена внимания растёт быстрее длины
Арифметика простая, без формул. Пять секунд при 24 кадрах в секунду это 120 кадров. Тридцать секунд это 720 кадров. Кадров стало в шесть раз больше, а сверок между ними примерно в тридцать шесть раз больше. Удвоили длину, объём работы вырос вчетверо, память под это нужна тоже вчетверо больше.
Отсюда два следствия. Первое: у каждой модели есть предельная длина одного прохода. Второе: секунда на длинном ролике не дешевеет, она стоит дороже, чем секунда на коротком. Провайдеру выгоднее резать работу на короткие генерации, и он режет.
Создание длинных видео нейросетью упирается в потолок модели
Цифры с официальных страниц моделей, проверены 16 ноября.
Kling 4.0 генерирует от 3 до 30 секунд за один проход. Gemini Omni 1.2 Flash держится диапазона от 3 до 15 секунд, а ролик по первому и последнему кадру у него ограничен десятью секундами. Seedance 2.5 Flash выдаёт от 4 до 30 секунд за один запрос.
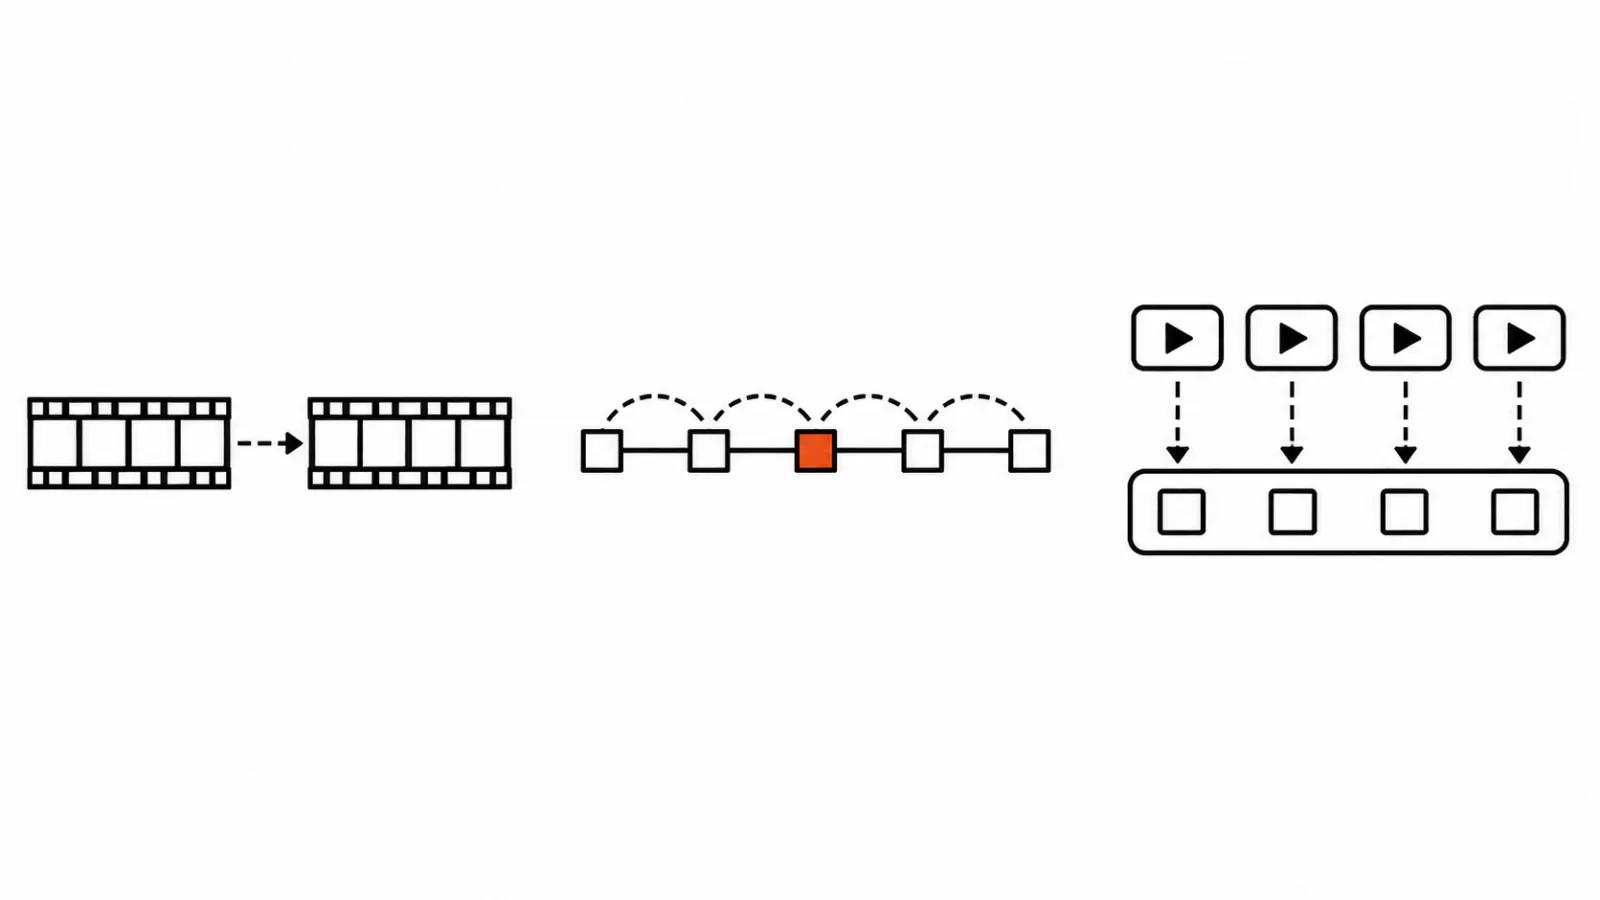
Тридцать секунд это уже серьёзный рекламный шот: в него влезает выход героя, показ товара и финальный кадр. До минутного объяснения или до диалога на две реплики такой кусок не дотягивает. Дальше начинается сборка, и способов у неё три.
Продолжение с последнего кадра
Способ первый: скормить модели конец готового клипа и попросить продолжить движение.
LongCat-Video-Avatar 1.6 от команды Meituan работает именно так. Последние кадры предыдущего клипа переносятся вперёд, к ним дописываются новые кадры, ролик растёт шагами. Слабое место приёма предсказуемо: ошибка накапливается. Небольшой сдвиг у рта или в текстуре лица на каждом шаге чуть увеличивается, и после десятка продолжений человек в кадре уже другой. В версии 1.6 модель дообучали в ситуациях, где она продолжает собственные сгенерированные клипы, и это дало ролики длиннее 10 минут с меньшим дрейфом лица и рта. Механика у нас разобрана отдельно: почему в ИИ-видео плывут лица и руки, там тот же самый эффект накопления.
Kling 4.0 умеет продолжать готовый ролик: режим Video Extension достраивает его вперёд и назад за несколько проходов и доводит до двух минут по официальному описанию. Seedance 2.5 Flash продлевает видео несколькими раундами через API. Правило одно: продолжение цепляется за последний кадр, и качество этого кадра определяет следующий кусок.
Ключевые кадры по таймлайну
Способ второй: расставить по таймлайну опорные картинки и дать модели прорисовать движение между ними. У Kling 4.0 на одну генерацию до 10 ключевых кадров: поза героя, смена плана, поворот камеры, появление товара на столе.
Логика понятная. Модель ведёт сцену от опоры к опоре, и структура ролика перестаёт быть лотереей. Режиссёрская работа переезжает в раскадровку, где её и удобно делать руками.
Ограничение тоже честное. Между ключевыми кадрами модель досочиняет сама, и на длинном отрезке её может увести в сторону. Чем плотнее стоят кадры, тем крепче контроль и тем меньше свободы для движения. Для рекламы это обычно плюс, для танца или драки минус.
Нарезка на шоты и монтаж
Способ третий, самый надёжный и самый скучный: ролик режут на шоты по пять-десять секунд, каждый генерируют отдельно, потом собирают в редакторе. Склейки, звук, титры и цвет живут уже в монтаже.
Плюс очевидный: брак в одном шоте не тянет за собой остальные. Переделка стоит времени одного куска. Минус тоже очевидный: стыки видны, если о них не думать заранее. Спасают общие референсы на лицо, одежду и свет, движение, переходящее через склейку, и монтажный ритм, который маскирует переход.
Тут полезно понимать, что такое латентное пространство. Это сжатое описание сцены внутри модели, где нет пикселей, есть набор чисел. Модель сравнивает такие описания, и на стыках двух независимых генераций описания расходятся: свет чуть другой, лицо чуть иное. Отсюда странности на склейках, которые глаз замечает раньше, чем мозг.
Что это значит для сметы
Длинный ролик на деле это серия шотов, и считать его надо по шотам. Минута финала это обычно порядка десяти сгенерированных кусков, и часть уйдёт в брак, потому что раскадровка уточняется по ходу работы.
Второй пункт сметы это переделки. Первый шот всегда самый дорогой по времени: на нём подбирают референсы, свет и стиль, и именно его чаще всего переделывают целиком. Дальше работа идёт быстрее, если референсы зафиксированы.
Отсюда практический вывод для заказчика: обсуждать надо число шотов и запас на переделку. Длина ролика тут следствие. Такой разговор снимает половину споров на приёмке. У нас видео нейросетями собирается именно так, по шотам, а ручные ролики берут проекты, где нужен непрерывный кадр или сложная актёрская сцена.
Мой вывод
Потолок в тридцать секунд это не временное ограничение, которое снимут патчем. Это следствие того, как модель считает: чем длиннее ролик, тем дороже каждая следующая секунда. Модели будут уходить дальше, продолжение и ключевые кадры уже работают, но принцип остаётся.
Поэтому мой рабочий порядок такой: сначала раскадровка на шоты, потом генерация по одному куску с общими референсами, потом монтаж. Продолжение с последнего кадра беру, когда нужен один непрерывный проход камеры. И на первом шоте всегда оставляю запас на переделку, иначе смета врёт уже на второй день.